Linux服务器GPU监控指南:nvidia-smi与nvitop
GPU 任务启动后,需要分别确认设备是否可用、程序是否正在计算、显存由哪些进程占用。显存占满不等于计算效率高,GPU 利用率低也不一定代表程序挂起;监控应结合运行阶段、进程状态和日志共同判断。
本文面向配有 NVIDIA GPU 的 Linux 服务器,整理普通账户可以使用的查看与排查方法。连接、环境和任务管理的整体流程见 AI Coding指南。
1 先区分驱动、计算环境与监控工具
NVIDIA 驱动提供系统访问 GPU 的基础接口;PyTorch 等框架及其 CUDA 运行时位于项目环境中;nvidia-smi、nvitop 用来读取设备和进程状态。这三层相关,但不能相互替代。
nvidia-smi 通常随驱动工具安装,nvitop 通过 NVML 接口读取 GPU 信息。安装 nvitop 不会安装或修复系统驱动,也不需要为了监控而把整个 CUDA Toolkit 安装到个人目录。
先确认当前机器和基础查询:
1 | hostname |
若命令不存在,先核对是否登录了 GPU 节点,以及集群是否要求加载模块。若提示无法与驱动通信或 NVML 初始化失败,应保留完整错误并检查管理员提供的运行环境;反复安装 Python 包通常不能解决驱动层问题。
容器与调度系统可能只暴露部分设备。当前终端看不到 GPU,并不一定代表整台物理服务器没有 GPU;需要核对资源分配与容器启动方式。
2 阅读 nvidia-smi
2.1 一次查看与持续刷新
1 | nvidia-smi |
第一条显示当前概况,第二条列出设备名称与 UUID,第三条每秒刷新。watch 前台运行时按 Ctrl+C 结束监控,不会结束另一个终端里的训练。
没有 watch 时,可使用 nvidia-smi -l 1 持续刷新。GPU 负载会随数据加载、前向计算、反向计算和验证阶段变化,应观察多个采样周期。
2.2 主要指标
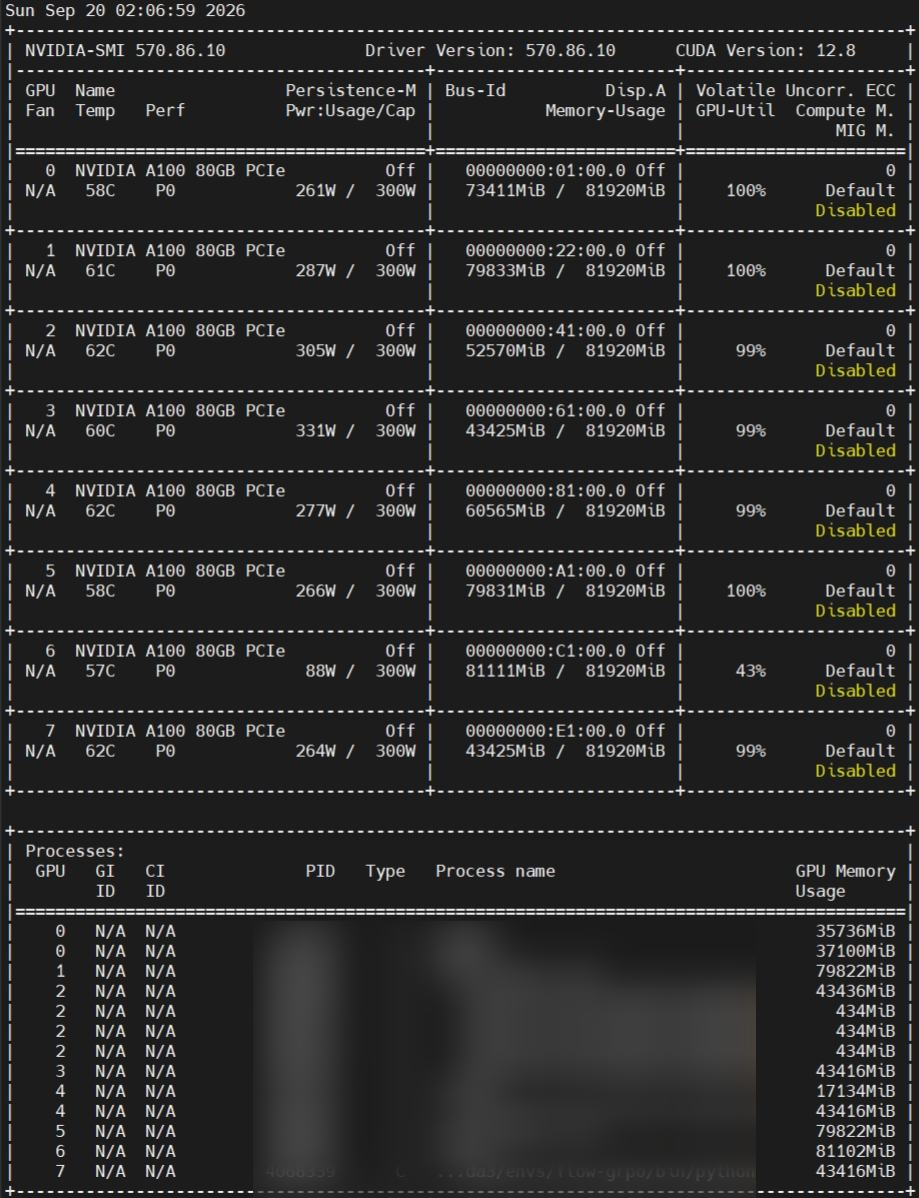
- GPU 名称与编号:定位设备;编号属于当前查询环境,不宜作为永久身份标识。
- Memory-Usage:显存已用量与总容量,例如
12000 MiB / 24576 MiB。 - GPU-Util:采样期间 GPU 执行计算内核的时间比例,不是峰值算力利用率。
- Temp 与 Power:温度、当前功耗及功耗上限,可辅助观察负载变化。
- Processes:与 GPU 相关的进程 PID、类型、命令及显存用量。
进程类型中的 C 通常表示计算,G 表示图形,C+G 表示两者兼有。部分硬件、MIG 配置或权限条件下会出现 N/A,它表示指标不可用,不能直接当作零值。字段定义见 NVIDIA nvidia-smi 文档。
需要区分显存容量占用与显存读写活动。查询字段 memory.used 是占用了多少显存;utilization.memory 是采样期间读写显存的活动比例,不是 memory.used / memory.total。
2.3 CUDA Version 不等于项目安装版本
常见输出顶部的 CUDA Version 表示驱动支持的 CUDA 版本上限,不表示当前 Python 环境的 CUDA 运行时版本。新版工具可能显示为 CUDA UMD Version,驱动字段也可能显示为 KMD Version,含义仍需与项目环境区分。
在已经安装 PyTorch 的项目环境中检查:
1 | python -c "import torch; print('PyTorch:', torch.__version__); print('Built with CUDA:', torch.version.cuda); print('CUDA available:', torch.cuda.is_available())" |
torch.version.cuda 是该 PyTorch 构建对应的 CUDA 版本;CPU 构建可能返回 None。nvcc --version 则检查当前路径中的 CUDA 编译器,三者不同不能单凭数字不一致就判断环境损坏。
解释器与依赖选择见 Linux服务器Python环境管理与依赖复现。驱动升级属于服务器维护工作,不是普通项目环境安装的一部分。
2.4 导出便于保存的指标
1 | nvidia-smi --query-gpu=index,uuid,name,memory.used,memory.total,utilization.gpu \ |
长实验可以每 10 秒记录一次:
1 | mkdir -p logs |
这个命令持续占用当前终端,按 Ctrl+C 停止。若需要断开 SSH 后继续采样,可将它放在单独的 tmux 窗口中;方法见 tmux、日志与断线恢复。日志记录的是设备整体状态,多用户共享时不等于单个实验的独占使用量。
3 安装与使用 nvitop
3.1 独立环境安装
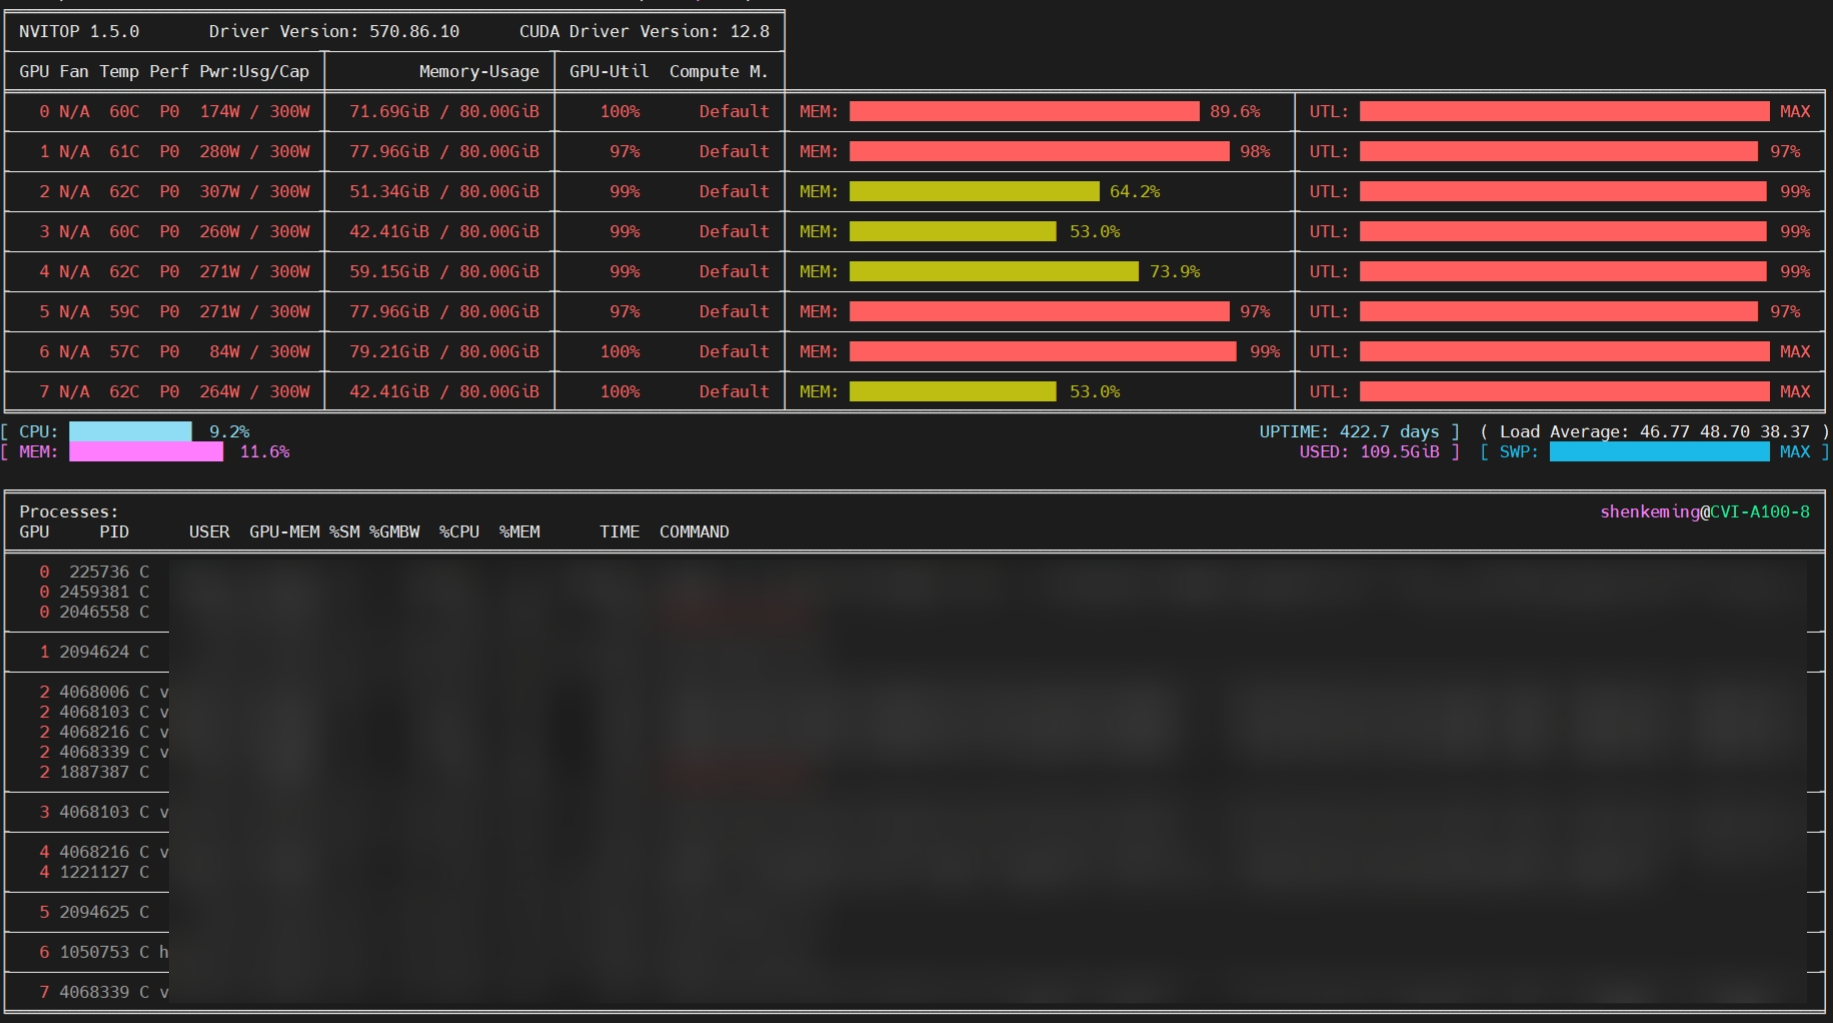
nvitop 将 GPU、CPU、系统内存和相关进程集中显示,适合交互查看。可以用支持 venv 的 Python 在个人目录创建独立工具环境:
1 | python3 -m venv "$HOME/.venvs/nvitop" |
这种方式不需要 sudo,也不会向训练环境添加依赖。之后直接使用最后一条绝对路径命令启动即可;无需在每个项目中重复安装。安装要求见 nvitop 官方文档。
若系统不具备 venv,可使用已有 Conda 创建工具环境:
1 | conda create -n gpu-tools -c conda-forge nvitop |
两种安装方式任选其一。下载失败时先检查服务器网络和包源访问;网络配置见 Linux服务器代理联网指南:Clash与Mihomo。
以下示例假设已将 nvitop 所在环境激活,因此可直接调用命令。采用上面的 venv 时执行 source "$HOME/.venvs/nvitop/bin/activate",结束后用 deactivate 退出;采用 Conda 路线时执行 conda activate gpu-tools,结束后用 conda deactivate 退出。
3.2 日常查看
1 | nvitop |
分别对应交互监控、仅显示当前用户的相关进程、输出一次快照。用户过滤主要影响进程列表,设备总体指标仍可能包含其他任务的占用。
常用交互操作包括:
h或?:查看帮助。- 上下方向键:选择进程。
Enter:查看所选进程的指标。t:查看进程树。q:退出监控界面。
nvitop 含有发送进程信号的快捷键,因此退出时使用 q,不要把所有监控界面中的 Ctrl+C 都当作普通退出操作。若已安装版本的 nvitop --help 列出 --readonly,可以用 nvitop --readonly 禁用进程修改功能。参数与按键见 项目使用说明。
3.3 将 GPU 状态关联到进程
进程列表重点看 PID、用户名、命令行、GPU 显存、CPU 使用量、主机内存和运行时长。显存是 GPU 的存储资源,主机内存是服务器 RAM,两者应分别观察。
对于列表中的某个 PID,可进一步查询;下面的 12345 只是示例,必须替换为当前实际 PID:
1 | ps -p 12345 -o user,pid,ppid,stat,etime,%cpu,%mem,rss,args |
PPID 可用于核对父进程,RSS 以 KiB 表示常驻物理内存;ps 的 %CPU 通常是进程生存期内的平均值,不等于监控界面的瞬时采样值。字段含义见 ps 手册。
同一训练任务可能产生多个 Python 子进程,PID 相近也可能只是启动时间接近。判断归属应依靠用户名、命令和实际父子关系,不能凭数字相近推断。
4 选择任务使用的 GPU
4.1 CUDA_VISIBLE_DEVICES 的作用
在没有调度器预先分配设备、且已确认允许使用目标 GPU 的条件下,可以只为一次命令设置可见设备:
1 | CUDA_VISIBLE_DEVICES=2 python train.py |
train.py 代表已有项目的训练入口。这里的设备 2 必须实际存在且已确认可用;该环境变量在 CUDA 初始化前生效,不能在任务运行过程中改变已经建立的设备上下文。
仅暴露一张设备时,程序内部一般将它编号为 cuda:0。同样,CUDA_VISIBLE_DEVICES=2,1 暴露两张设备时,程序内的 cuda:0 对应列表第一张,cuda:1 对应第二张。顺序与重编号规则见 CUDA 环境变量文档。
设置可见列表不会自动让单卡代码改为多卡计算。多卡训练还需要框架的分布式启动方式和项目支持。
4.2 编号、UUID 与可见性
数字编号可能受到设备枚举顺序、容器和环境配置影响。记录或指定具体设备时,可以先查询完整 UUID:
1 | nvidia-smi --query-gpu=index,uuid,pci.bus_id,name --format=csv |
然后将下例字符串替换为查询得到的完整 GPU-... UUID:
1 | CUDA_VISIBLE_DEVICES=GPU-实际完整UUID python train.py |
UUID 标识设备本身,可减少将监控编号与 CUDA 进程内编号混淆的情况。使用 MIG 切分设备时还涉及实例标识,应遵循所在集群的资源分配方式。
nvidia-smi 通常仍能列出其权限范围内的设备,不会因为训练设置了 CUDA_VISIBLE_DEVICES 就只显示训练可见的卡。nvitop 的 --only-visible 可按启动监控时所在环境的该变量过滤显示。
4.3 可见性不等于预约资源
CUDA_VISIBLE_DEVICES 不会锁定或独占 GPU,其他用户仍可能使用同一设备。显示“显存空闲”也不代表设备没有被预约。
Slurm 等系统已为作业分配 GPU 时,应保留调度器设置的可见设备,不要覆盖变量指定物理编号。容器中的 cuda:0 也可能是分配给容器的第一张卡,而不是宿主机的 0 号卡。
5 结合日志判断瓶颈
5.1 显存占用高,GPU 利用率低
模型参数、缓存或已分配的张量可以长期驻留显存,计算则可能在等待数据加载、CPU 预处理、磁盘读取或多进程同步。低利用率也可能是初始化、保存 checkpoint 等正常阶段。
先查看日志是否仍有进度,再观察 CPU 与 I/O 活动。优化应针对已确认的等待环节;仅增加 DataLoader worker 数量可能同时增加 CPU、系统内存和存储压力。
5.2 CUDA 显存不足
日志明确出现 CUDA out of memory 时,应检查当前任务及同卡其他任务的显存使用,并结合模型规模、batch size、序列长度或输入分辨率分析峰值需求。
PyTorch 的缓存分配器可能保留暂未被张量使用的显存,因此 nvidia-smi 的占用与框架报告的张量占用不完全一致。torch.cuda.empty_cache() 只能释放部分未使用的缓存,不能释放仍被活动张量引用的内存。参见 PyTorch CUDA 内存管理。
5.3 进程突然消失或只显示 Killed
这不一定是 GPU 显存问题。系统 RAM 耗尽、作业内存限制、超时、外部信号和程序异常都可能导致退出。单凭 Killed 无法确定原因,应结合日志和调度器记录判断。
1 | free -h |
free 中的 available 比单纯的 free 更适合判断系统当前可供新任务使用的内存;它仍不一定反映容器或作业的独立限制。df 应同时检查实际数据与输出所在文件系统,个人配额还需单独查询。内存字段见 free 手册。
5.4 日志不更新,但进程还在
先确认查看的是当前实验的日志,并检查输出是否被缓冲。Python 可以用 -u 启动减少标准输出缓冲;程序采用独立日志框架时,还应检查其写入目标和刷新机制。
若 GPU、CPU 与日志长期没有变化,再检查数据路径、网络请求和进程同步。等待 API 或远程文件时,修复 GPU 环境通常没有作用。
6 正常停止与异常占用
优先回到任务所在终端使用项目的停止方式。独立任务失去原终端后,先确认 PID 仍属于自己的目标任务,再请求终止:
1 | ps -p 12345 -o user,pid,ppid,lstart,args |
12345 是占位示例,不应原样执行。SIGTERM 给程序处理终止请求的机会,但能否保存结果取决于程序实现。等待并再次检查;只有进程持续不响应、已重新核对身份且确需强制结束时,才考虑 kill -KILL 实际PID。
强制终止无法执行清理逻辑,也不保证自动结束全部子进程。由调度器管理的任务优先通过其作业取消接口处理;共享服务器上不应通过重置 GPU 或结束其他用户的进程来清理显存。
如果 GPU 列表中的 PID 在当前环境查不到,还需考虑容器 PID 命名空间、进程退出时序和查询权限。严格的 Linux 僵尸进程是已经退出、等待父进程回收退出状态的进程,不能仅凭“显存还占着”作出判断。
设备文件关联进程的进一步排查见 NVIDIA显卡异常进程占用排查。涉及系统权限和共享设备时,应由管理员结合宿主机进程信息处理;PID 相近本身不是终止一批进程的依据。