CH-01 神经网络基础
用计算模型模拟生物神经系统的建模思路,要早于“人工智能”这一名称出现的时间。1943 年,神经生理学家 Warren McCulloch 与逻辑学家 Walter Pitts 提出了一种阈值逻辑神经元:多个输入信号汇总之后,只有超过阈值时才输出 1。1958 年,Frank Rosenblatt 提出了感知机 (Perceptron),并在康奈尔航空实验室建造了 Mark I 感知机:它用一个 20×20 的光电管阵列“观察”图像,通过调节电位器来改变连接的强度,从而学会区分简单的图形。然而,1969 年 Marvin Minsky 与 Seymour Papert 在《Perceptrons》一书中指出,单层感知机无法表示异或 (XOR) 这类简单的函数,这一结论常被认为是神经网络研究在此后十余年陷入低谷的原因之一。直到 1986 年,Rumelhart、Hinton 与 Williams 系统阐述了训练多层网络的反向传播算法,多层神经网络才重新成为研究热点。
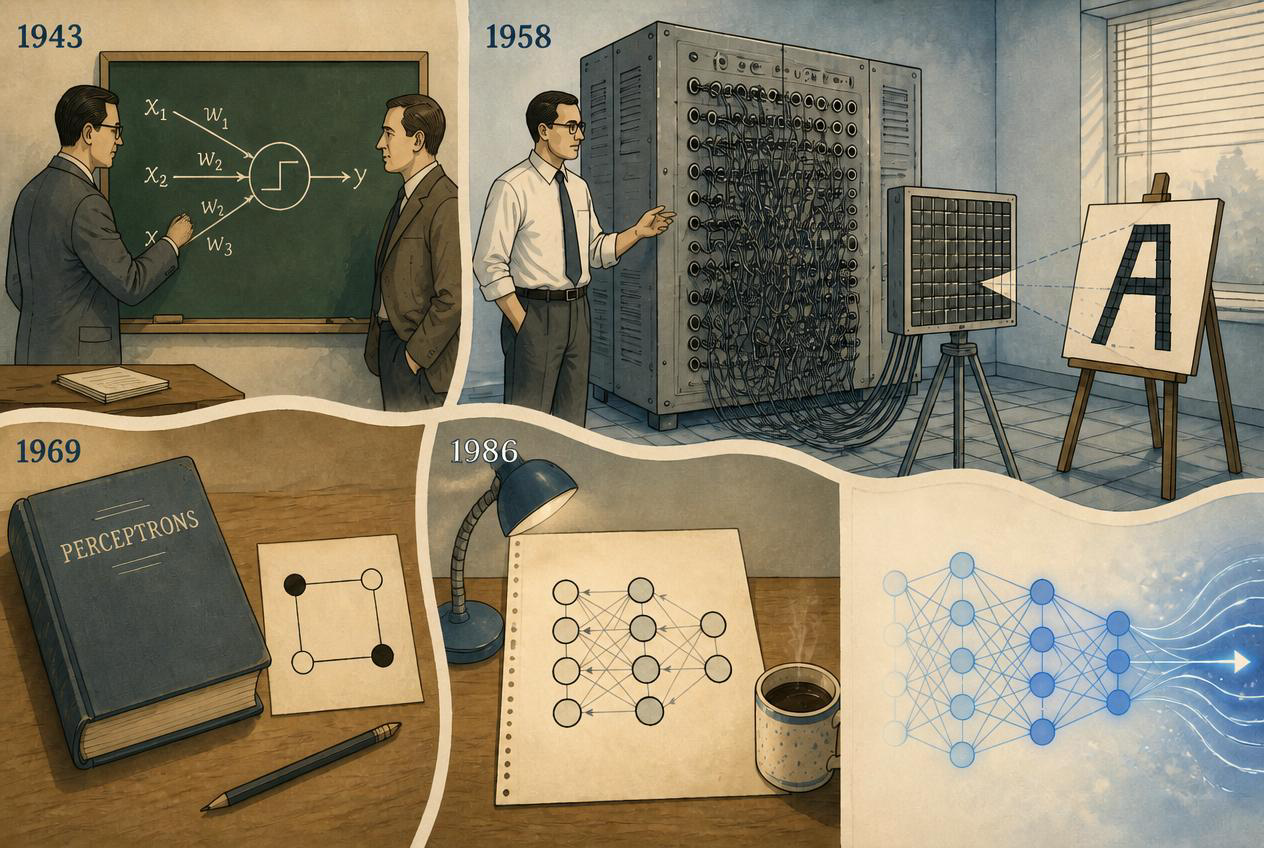
回顾这段历史,可以发现两个贯穿始终的问题:一是单个计算单元应当如何定义,二是多个单元应当如何组合,才能表达足够复杂的函数。
从计算的角度看,神经网络 (Neural Network) 是一族带参数的函数 $f_\theta$。给定输入 $x$ 与参数 $\theta$,它输出一个预测结果 $f_\theta(x)$。其中,网络结构决定了这族函数的形式,训练通过优化损失函数来调整参数,从这族函数中选择适合数据的成员。
Transformer 的计算同样依赖这些基本运算。具体而言,Query、Key、Value 的投影、注意力输出投影和词表预测使用线性层;前馈网络在两个线性层之间引入激活函数。因而,理解仿射变换(矩阵乘法加偏置)如何与非线性函数组合,是分析 Transformer 特征变换的基础。注意力中的跨位置加权聚合则将在后续章节单独讨论。
1. 人工神经元
1.1 从生物神经元到数学模型
人工神经元的设计借鉴了生物神经元的基本工作方式。一个生物神经元通过树突 (dendrite) 接收来自其他神经元的信号,这些信号在细胞体 (soma) 中整合;当整合后的电位超过一定阈值时,神经元便会“放电”,并沿轴突 (axon) 把信号传递给下游的神经元。其中,不同突触 (synapse) 的连接强度不同,因此各个输入信号对结果的影响也不相同。
人工神经元把这一过程抽象为三个步骤:首先,每个输入 $x_i$ 乘以一个表示连接强度的权重 $w_i$;然后,将这些乘积求和,再加上一个偏置 $b$;最后,把求和结果送入一个激活函数 $f$,得到输出:
下图标出了生物神经元的主要结构。树突接收信号,轴突将信号传向其他细胞。
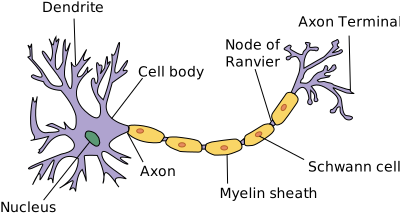
需要强调的是,生物学概念上的神经元对于神经网络是一种启发式设计,现代神经网络中的“神经元”已经被建模成了一个纯粹的数学运算过程,它的设计由算法的优化效果与计算效率(复杂度)决定,而不再追求生物学上的真实性。
1.2 感知机
Rosenblatt 提出的感知机模型是一个早期的神经网络实例。它使用阶跃函数 (step function) 作为激活函数:当加权和大于零时输出 1,否则输出 0,即:
从几何上看,方程 $w^\top x+b=0$ 定义了输入空间中的一个超平面(在二维平面上就是一条直线),感知机把位于其一侧的点判为类别 1,另一侧的点判为类别 0。与此同时,Rosenblatt 还给出了一种简单的学习规则:每当某个样本被分错时,就沿着减小误差的方向调整权重和偏置。可以证明,当两类样本能够被某个超平面完全分开时,这一规则会在有限步内收敛。
然而,感知机的局限也恰恰来自这种几何结构:它的决策边界只能是一个超平面。因此,对于无法用一条直线分开的数据(例如第 3.1 节将要讨论的异或问题),单个感知机无法通过调整参数准确分类。增加特征变换的表达能力,需要把多个神经元组织成层,并在层与层之间引入非线性。
2. 线性层与仿射变换
2.1 加权求和
要让同一输入产生多个特征,需要把多个神经元组织为一层。如果暂时去掉激活函数,单个神经元计算的是带偏置的加权和。在日常生活中,这是一种很常见的计算方式:例如,综合成绩等于各科成绩乘以相应的权重再求和,有时还会再加上一个固定的基础分。而如果让多个神经元并列、同时读取同一组输入,就得到了一个线性层,它会同时计算多组不同的加权和。
具体而言,设输入为行向量 $x=[2,-1]$,输入维度 $d_{\mathrm{in}}=2$。一个输出维度 $d_{\mathrm{out}}=3$ 的层会计算以下三组加权和:
其中,输入分量前面的系数称为权重 (weight),末尾的常数称为偏置 (bias)。代入 $x_1=2,x_2=-1$,可以得到:
如果把这一计算画成网络图,每条连线就对应一个权重,每个输出节点汇总所有指向它的连线。下图展示了这个 2 输入、3 输出的线性层。
2.2 矩阵形式
在网络图中,连线的数量等于输入维度与输出维度的乘积,当维度增大时,逐条书写就会变得非常繁琐。为此,可以把每个输出所使用的权重排成一列,上述计算就可以写成一次矩阵乘法:
在这里,$W_1\in\mathbb R^{2\times3}$ 的第 $i$ 行第 $j$ 列,正是从输入 $x_i$ 指向输出 $a_j$ 的那条连线的权重;换言之,第 $j$ 列给出了第 $j$ 个输出的全部权重。一般地,在行向量约定下,各个对象的形状为:
在深度学习中,这种计算通常被称为线性层 (Linear Layer)、全连接层 (Fully Connected Layer) 或 Dense 层。不过严格地说,当偏置非零时,它在数学上是仿射变换 (Affine Transformation),只有偏置为零时才是线性变换。偏置的作用是让输出可以整体平移,使得输入为零时,输出不必为零。
“全连接”指的是每个输出都可以使用全部输入分量,并不要求所有权重都非零。线性层的参数量为 $d_{\mathrm{in}}d_{\mathrm{out}}+d_{\mathrm{out}}$,与输入维度和输出维度的乘积成正比,这也是大模型的参数主要集中在线性层的原因。
按定义计算 $a=xW_1+b_1$。torch.tensor 构造数值张量,@ 执行矩阵乘法。
1 | import torch |
运行结果:
1 | tensor([ 1.5000, -2.5000, 3.0000]) |
2.3 线性层接口
nn.Linear(2, 3) 表示两个输入特征、三个输出特征的线性层。它把权重存储为“输出维度 × 输入维度”,实际计算 x @ weight.T + bias,因此赋值时需要转置正文中的 $W_1$。
1 | fc1 = nn.Linear(2, 3) |
运行结果:
1 | tensor([ 1.5000, -2.5000, 3.0000]) |
torch.no_grad() 只在参数赋值期间关闭梯度记录;后续前向计算仍可构建计算图。detach() 在这里仅用于显示结果。
3. 非线性激活函数
3.1 仿射变换的复合仍是仿射变换
既然一个线性层的表达能力有限,那么是否可以通过堆叠多个线性层来增强它呢?不妨连续使用两个线性层:
记 $\widetilde W=W_1W_2$、$\widetilde b=b_1W_2+b_2$,结果仍然是 $z=x\widetilde W+\widetilde b$。也就是说,多个仿射变换的复合仍然是一个仿射变换,因此仅仅堆叠线性层,并不能获得超出单个仿射函数的表达能力。
从几何上看,这意味着无论堆叠多少个线性层,采用线性输出判别的二分类器,其决策边界始终是一条直线(或一个超平面)。以采用同号为 1 的连续 XOR 类别翻转算例为例:当一个二维点的两个坐标同号时属于类别 1,异号时属于类别 0,于是第一、三象限属于同一类,第二、四象限属于另一类。如下图左侧所示,任何一条直线都会把某些样本分到错误的一侧;而右侧带 ReLU 的两层网络则可以组合多条边界,从而把两个对角象限同时划为类别 1。
3.2 ReLU
为了打破这种可合并性,需要在两个线性层之间插入一个逐元素的非线性函数。目前最常用的选择是 ReLU (Rectified Linear Unit):
它保留正数,并将负数置零。对上一节的输出使用 ReLU,可以得到:
1 | h = torch.relu(a) |
运行结果:
1 | tensor([1.5000, 0.0000, 3.0000]) |
一个单变量算例可以说明非线性如何改变可表示的函数。对于实数输入 $t$,令两个隐藏单元分别计算 $\operatorname{ReLU}(t)$ 与 $\operatorname{ReLU}(-t)$,再将二者相加:
绝对值函数在零点两侧的斜率不同,因此任何单一的仿射函数都无法在整条实数轴上表示它,而仅仅两个 ReLU 单元就可以做到。同样的道理,多个 ReLU 单元可以在输入空间中组合出多段“折线”,这正是上图右侧的网络能够划出对角区域的原因。
3.3 导数与其他激活函数
由于训练依赖梯度,激活函数的导数同样值得关注。ReLU 在正区间的导数为 1,在负区间的导数为 0,在零点处不可导;对此,自动微分框架会在零点取一个约定值,PyTorch 取的是 0。需要注意的是,负区间的零导数意味着梯度无法经过被截断的单元传回。如果一个单元对几乎所有输入都处于负区间,它的参数就几乎得不到更新,这种现象被称为“神经元死亡 (dying ReLU)”。
除 ReLU 之外,常见的激活函数还包括:
- Sigmoid:$\sigma(u)=1/(1+e^{-u})$,输出位于 $(0,1)$ 之间,常用于门控和二分类概率。但当输入的绝对值较大时,它的导数会趋于零。
- Tanh:输出位于 $(-1,1)$ 之间,常见于 RNN 的状态更新(第 05 章)。
- GELU (Gaussian Error Linear Unit):$\operatorname{GELU}(u)=u\,\Phi(u)$,其中 $\Phi$ 是标准正态分布的累积分布函数。它可以看作 ReLU 的平滑版本,BERT、GPT 等后续模型的前馈网络大多采用它,而原始 Transformer 使用的是 ReLU。
感知机所使用的阶跃函数几乎处处导数为零,梯度无法通过它传递,这也是它难以用于训练多层网络的原因之一。下面计算并绘制四种激活函数。它们使用相同的输入区间;纵轴保留各自的数值范围。
1 | import matplotlib.pyplot as plt |
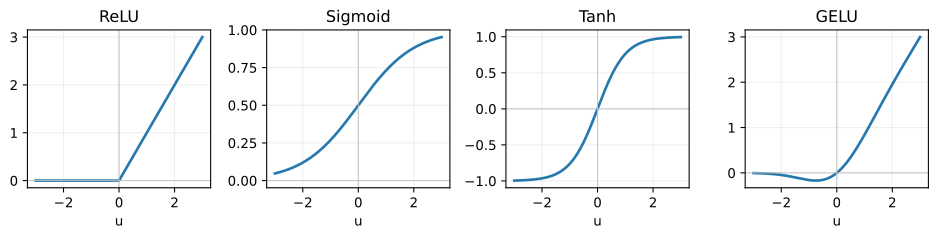
隐藏激活与概率输出需要按任务区分。ReLU 的输出没有上界,各个分量也不会自动归一化,因此通常用于隐藏特征变换。互斥多分类任务使用 softmax,把类别 logits 转换为总和为 1 的分布;二分类或多标签任务则可以对相应的 logit 应用 sigmoid,得到单个事件或各标签的 Bernoulli 概率参数(第 02 章)。
4. 多层感知机与分段仿射结构
4.1 两层网络
多层感知机在输入层与输出层之间引入隐藏层,下图为含一个隐藏层的全连接结构。图中的单元数量用于说明结构,后面的数值算例采用两个输入、三个隐藏单元和两个输出。
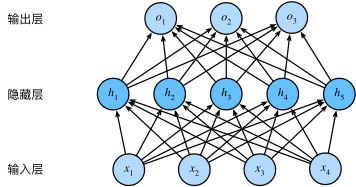
有了线性层与非线性激活,就可以把它们交替堆叠,构造不能简化为单次仿射变换的多层网络。沿用前面的算例,在 ReLU 之后再接一个线性层,设其参数为:
代入 $h=[1.5,0,3]$,可以得到:
因此,完整的计算过程为:
沿用前面得到的隐藏向量 h,再计算一次仿射变换:
1 | W2 = torch.tensor([[1., -1.], [.5, .5], [-1., 1.]]) |
运行结果:
1 | tensor([-1.4000, 1.4000]) |
这样的网络称为多层感知机 (Multi-Layer Perceptron, MLP)。需要说明的是,这里的“感知机”只是沿用了历史名称,MLP 中的激活函数通常不再是阶跃函数。如果按带可学习权重的层来计数,它是一个两层网络,包括一个隐藏层和一个输出层。其中,$h$ 被称为隐藏表示 (hidden representation);这里的“隐藏”仅表示它不是最终输出,并不意味着它无法被观测。
把上述数值填入网络图中,就可以看到一次前向计算的完整过程:输入经第一层得到 $a$,经 ReLU 得到 $h$,再经第二层得到 $z$。
另外,输出层通常不使用 ReLU。这是因为当 $z$ 被用作分类分数(即 logits)时,它需要能够取任意实数,随后再由 softmax 转换为概率。换言之,每一层使用什么激活函数,取决于这一层需要表达的数值范围。
4.2 几何解释
从几何的角度来看,在二维输入平面上,$a_1=0$、$a_2=0$、$a_3=0$ 各自对应一条直线,这三条直线把平面划分为若干个区域。在每个区域的内部,各个 $a_i$ 的符号保持不变,所以相应的 ReLU 要么原样保留一个仿射表达式,要么恒为零;随后,第二层再对这些结果做仿射变换。因此,整个网络在每个区域内都是仿射函数,而在整体上则是一个连续的分段仿射函数。
由此可见,增加隐藏单元,可以提高网络划分输入空间和拟合复杂函数的能力,但具体形成多少区域仍取决于权重与偏置。万能近似定理 (Universal Approximation Theorem)为此提供了理论保证:只要隐藏单元足够多,单隐藏层网络就可以在紧致输入区域上,以任意给定精度一致逼近连续函数。不过,该定理只说明这样的参数是存在的,既没有说明需要多少个单元,也没有说明训练能否找到这组参数。在实践中,增加网络深度往往比无限加宽更加有效。
下面的交互图使用了上述固定参数。拖动输入点或调整滑块,可以同时查看 $a$、$h$ 与 $z$ 的数值;当输入点跨过某条直线时,对应的隐藏单元会在开启与关闭之间切换。可以观察到,函数值在边界两侧是连续的,但输入对输出的影响方式发生了改变。参数保持固定,因此拖动输入展示的是同一函数在不同位置的取值。
5. 参数与激活
在理解了网络的计算过程之后,还需要区分参数与激活这两类对象。为此,保持参数不变,把输入换成 $x'=[-1,2]$,可以得到:
两次计算使用的是同一组 $W_1,b_1,W_2,b_2$,却得到了不同的 $a,h,z$。前者被称为parameter(模型参数),通常由训练学习,在常规推理过程中保持固定;后者被称为activation(激活值),取决于当前输入和参数。模型参数确定输入到输出的变换规则;activation 是当前输入沿该规则计算得到的中间数值。对比上一节的图可以发现,对于这个新输入,输出为 0 的变成了第一个和第三个隐藏单元,可见哪些单元处于“开启”状态同样是由输入决定的。
以该网络为例,它的参数量为:
无论处理多少个输入,这 17 个参数都不会增加,但每次前向计算都会产生新的中间激活。在训练时,框架需要保存这些激活,以便在反向传播中计算梯度。因此,训练过程的显存占用除了参数本身之外,还会随批量大小与序列长度的增加而增长。这一点在第 11 章分析注意力的存储开销时还会再次出现。
同理,“激活函数”与“激活值”也需要区分开来:ReLU 是一个函数,而 $h=\operatorname{ReLU}(a)$ 则是它在当前输入上的取值。
6. 批量计算与参数共享
6.1 批量矩阵乘法
在实际应用中,网络通常一次处理多个输入。为此,可以把多个输入按行堆叠成一个矩阵:
这样一来,同一个网络就可以一次性处理这两行:
在这里,矩阵的每一行对应一个样本,而 $XW_1+b_1$ 表示给每一行都加上同一个偏置向量,这一操作被称为广播 (broadcasting)。批量计算把多次相同的运算合并为一次矩阵乘法,GPU 可以高效地执行这类运算;但需要注意的是,它并不会让某个样本的输出读取另一个样本的输入。
将两个输入堆叠成矩阵,只需把单个向量 x 换成 X。下面同时打印隐藏表示与输出:
1 | X = torch.tensor([[2., -1.], [-1., 2.]]) |
运行结果:
1 | tensor([[1.5000, 0.0000, 3.0000], |
两个输出分别对应两行输入。
6.2 逐位置共享
同样的机制也适用于序列数据。如果一句话有 $L$ 个位置,每个位置是一个 $D$ 维向量,那么它们可以组成一个 $L\times D$ 的矩阵,而一个 MLP 则可以用同一组参数分别变换其中的每一行。这正是 Transformer 中FFN(逐位置前馈网络)的计算方式(第 09 章)。以绪论中的前缀“今天/深圳/天气/很”为例,四个位置的向量各自经过同一个 MLP,得到各自的输出。
由此可以得到一个重要的推论:逐位置 MLP 只变换当前位置的特征,而不读取其他位置的信息。 也就是说,如果两个位置的输入向量完全相同,那么无论 MLP 有多少层,它们的输出都会相同。因此,要让同一个词在不同的语境下得到不同的表示,就必须引入一种能够跨位置交换信息的运算:在 RNN 中,这种运算是隐藏状态的递推;而在 Transformer 中,则是注意力机制。
此外,参数共享指的是同一套权重在多个样本或多个位置上复用,并不代表整个模型只有一套权重。不同的层通常各自拥有独立的参数,跨层共享则需要由网络结构另行规定。
7. 前向传播与学习目标
前向传播 (forward propagation) 是指在给定输入与参数的情况下,依次计算各层的激活和最终输出。前文的数值算例都属于前向传播:它们确定了一组参数的计算行为,但并没有回答哪一组参数适合某个具体任务。
为了回答这个问题,监督学习 (supervised learning) 会使用带标注的样本来评价预测结果。令全部参数记为 $\theta$,网络记为 $f_\theta$,则训练集上的平均损失为:
其中,$N$ 是样本数,$x^{(n)}$ 与 $y^{(n)}$ 分别是第 $n$ 个输入及其目标,$\ell$ 是单样本的损失函数。在分类任务中,$\ell$ 通常取交叉熵,第 02 章会给出它的概率来源。
在此基础上,反向传播 (backpropagation) 利用链式法则,沿着计算图从损失出发,逐层求出损失对每个参数的梯度;随后,优化器 (optimizer) 根据梯度更新参数。与感知机只能在分错样本时调整单层权重的规则相比,反向传播可以把误差信号传递到任意深度的每一个参数,这正是 1986 年这项工作使多层网络重新受到重视的原因。下图概括了一个训练步中的数据流。
将上述运算对应到 Transformer,Q、K、V 投影是线性层,FFN 是 MLP,而注意力则负责位置之间的信息交互。参数定义了变换,输入产生了激活,损失则指导参数的更新。
参考资料
[1] Warren S. McCulloch and Walter Pitts. A Logical Calculus of the Ideas Immanent in Nervous Activity. The Bulletin of Mathematical Biophysics 5, 115–133, 1943.
[2] Frank Rosenblatt. The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review 65(6), 386–408, 1958.
[3] Marvin Minsky and Seymour Papert. Perceptrons: An Introduction to Computational Geometry. MIT Press, 1969.
[4] David E. Rumelhart, Geoffrey E. Hinton, and Ronald J. Williams. Learning Representations by Back-Propagating Errors. Nature 323, 533–536, 1986.
[5] George Cybenko. Approximation by Superpositions of a Sigmoidal Function. Mathematics of Control, Signals, and Systems 2, 303–314, 1989.
[6] Kurt Hornik. Approximation Capabilities of Multilayer Feedforward Networks. Neural Networks 4(2), 251–257, 1991.
[7] Dan Hendrycks and Kevin Gimpel. Gaussian Error Linear Units (GELUs). arXiv:1606.08415, 2016.
[8] Marvin Minsky and Seymour Papert. Perceptrons: An Introduction to Computational Geometry. MIT Press, 1969.
[9] PyTorch Contributors. Linear. PyTorch documentation.
[10] PyTorch Contributors. Autograd Mechanics. PyTorch documentation.
Figure source: Aston Zhang, Zachary C. Lipton, Mu Li, and Alexander J. Smola, Dive into Deep Learning. Biology, Original SVG, Reproduced without modification; Apache 2.0 license.
Code and experiment data: 01-basics.py, 01-examples.py.
Figure source: Aston Zhang, Zachary C. Lipton, Mu Li, and Alexander J. Smola, Dive into Deep Learning. mlp.svg, Original vector artwork, Reproduced without modification; Apache 2.0 license.