CH-04 模型的训练
前三章分别给出了网络的计算形式、损失函数的概率来源以及文本的张量表示,但还有一个关键问题没有回答:网络的参数究竟从何而来?训练通过数据中的监督信号优化参数,使模型降低预测损失;与此同时,还需要用独立数据评价模型对未见样本的泛化表现。训练损失下降本身并不保证泛化能力提高。
训练 Transformer 与训练一个小型分类器,使用的是同一套流程:批次采样、前向计算、损失计算、反向求导、参数更新,以及在独立数据上的评价与模型选择。二者共享优化的基本步骤,但输入规模、监督目标、资源开销和学习率配置存在差异。本章用一个二维分类任务说明训练各环节的作用,再将这些环节对应到序列模型。
1. 优化问题与梯度下降
1.1 经验风险最小化
首先从优化目标说起。设训练集为 $\{(x^{(n)},y^{(n)})\}_{n=1}^N$,训练的目标是最小化训练集上的平均损失,即经验风险 (empirical risk):
然而,我们真正关心的是模型在新数据上的损失,即期望风险 (expected risk)。期望风险与经验风险之间的差称为 generalization gap(泛化差距);期望风险则描述模型在目标数据分布上的平均预测误差。数据划分、验证与检查点选择用于估计泛化表现,并据此选择模型。
1.2 梯度下降与小批量
明确了优化目标之后,接下来的问题是如何求解。由于梯度 $\nabla_\theta\mathcal L$ 指向损失增长最快的方向,在梯度非零、损失局部光滑且步长足够小时,沿其反方向更新参数可以降低当前损失:
其中,$\eta$ 被称为学习率 (learning rate)。下面用一个单参数的例子来说明:令 $w=2$、输入为 3、目标为 1,则平方损失为 $L=(3w-1)^2=25$,对应的导数为:
取 $\eta=0.01$,经过一步更新后 $w=2-0.01\times30=1.7$,损失随之降为 $(5.1-1)^2=16.81$。
先按解析导数计算一次更新:
1 | import torch |
运行结果:
1 | gradient = 30.00 |
学习率的选择直接决定了优化能否成功。以同一个例子为例,下图对比了三种学习率下连续 6 步的更新轨迹:学习率过小时收敛缓慢,适中时会在谷底两侧振荡并逐渐收敛,而过大时每一步都会越过谷底,并且离最优点越来越远。
不过,对整个训练集求梯度的代价很高。因此在实践中,每次只抽取一小批样本 (mini-batch) 来估计梯度,这种方法被称为随机梯度下降 (Stochastic Gradient Descent, SGD)。在均匀随机抽样的条件下,小批量梯度是经验损失梯度的无偏估计。不同批次带来的估计波动还会影响优化轨迹;这种波动的作用取决于学习率、批量大小和损失函数的局部形状。由此可见,批量大小、学习率与训练步数共同决定了优化过程。
1.3 Adam
在 SGD 的基础上,Adam(Kingma & Ba, 2014)是训练 Transformer 时最常用的优化器。它为每个参数维护梯度的一阶矩(即动量)$m$ 与二阶矩 $v$ 的指数滑动平均:
其中,$g_t$ 是第 $t$ 次更新的梯度,平方和除法均逐元素进行。两个状态从零初始化,偏差修正为 $\hat m_t=m_t/(1-\beta_1^t)$、$\hat v_t=v_t/(1-\beta_2^t)$。一阶矩平滑近期梯度方向,二阶矩为各参数提供不同的缩放系数;最终更新幅度由两者的比值决定,不能仅由当前梯度的大小判断。第 10 章还会介绍原始 Transformer 在 Adam 之上使用的 warmup(训练初期逐渐提高学习率) 学习率调度。
这种自适应步长在不同方向曲率差别很大时尤其有效。例如,下图在一个两个方向曲率相差 50 倍的二次函数上,对比了 SGD 与 Adam 从同一点出发、迭代 30 步的轨迹。
2. 实验任务:连续 XOR
2.1 任务定义
下面把上述优化方法应用到一个二维二分类任务。每个输入都是一个二维向量 $x=[x_1,x_2]$,其坐标从 $[-1,1]$ 中均匀抽取。无噪声的标签定义为两个坐标是否同号:
也就是说,第一、三象限为类别 1,第二、四象限及坐标轴上的点为类别 0。这种分类规则与经典 XOR(异或)的几何结构相同,但采用同号为 1、异号为 0 的标签约定,相当于翻转 XOR 的两个类别。早在 1969 年,Minsky 与 Papert 就指出单层感知机无法解决 XOR 问题,原因在于它的决策边界只能是一条直线,而这里需要分开的是两组对角区域。结合第 01 章的讨论,带 ReLU 的多层网络可以组合多条直线边界,因此能够表示这一规则。
2.2 标签噪声与评价指标
为了更贴近真实场景,数据生成脚本在抽取 2400 个样本之后,还会以 5% 的概率独立地翻转每个标签,并将结果作为实际的监督信号 $y$。这是因为真实数据中普遍存在标注错误,这一设置使我们可以观察模型是否在拟合噪声。也正是由于噪声的存在,即使按照完美的规则进行分类,模型在新样本上的期望准确率也只有 95%。
下图按同样的规则采样了一小批点,可以直观地看到数据的分布以及被翻转的标签:
在训练过程中,需要同时记录以下两个指标:
- 交叉熵损失:取决于模型给正确类别分配的概率,因此对置信度较为敏感。
- 准确率 (accuracy):只关心最高分的类别是否正确。
例如,当正确类别的概率上升、但仍低于错误类别时,准确率保持不变,而交叉熵却已经下降。因此,同时记录这两个指标,可以区分“概率分布在改善”与“分类结果在改善”这两种不同的情况。
3. 数据:Dataset、DataLoader 与划分
3.1 Dataset 与 DataLoader
确定任务之后,下一步是组织数据。PyTorch 使用两个抽象来完成这项工作:Dataset 定义如何按索引取出一个样本,而 DataLoader 负责把样本组织成批次,并控制遍历的顺序。对于已经存放在内存中的张量,可以这样实现:
1 | class PointDataset(torch.utils.data.Dataset): |
1 | loader = torch.utils.data.DataLoader( |
在这里,单个输入的形状为 [2],标签是一个整数;组成批次之后,二者的形状分别变为 [64, 2] 与 [64]。需要注意的是,最后一个批次可能不足 64 个样本,因此在统计时应使用实际的样本数。
另外,一个 step 对应一次参数更新,而一个 epoch 对应完整遍历一次训练集。其中,shuffle=True 会在每个 epoch 打乱样本顺序(特征与标签依然保持配对);generator 固定了打乱时所用的随机数;num_workers=0 则表示在主进程中读取数据。
3.2 三个集合的分工
在训练开始之前,这 2400 个样本被划分为互不重叠的三部分:
| 集合 | 样本数 | 用途 |
|---|---|---|
| 训练集 | 1680 | 计算梯度、更新参数 |
| 验证集 | 360 | 选择检查点、调整超参数 |
| 测试集 | 360 | 在所有选择完成之后做一次独立评价 |
其中,测试集的价值在于它没有参与任何决策。如果反复根据测试结果来调整模型,测试集实际上就变成了第二个验证集,最终报告的指标也会因此偏于乐观。
3.3 数据泄露
除了样本本身,数据预处理同样需要遵守划分规则。例如,输入标准化所使用的均值 $\mu$ 与标准差 $\sigma$ 只能从训练集中估计,并对三个集合使用同一个变换:
如果用全部数据来估计这些统计量,就会把验证集和测试集的信息带入训练流程,这种情况被称为数据泄露 (data leakage)。此外,划分方式还应与样本之间的依赖关系保持一致。例如,同一用户、同一文档或相邻时间片段的样本通常高度相似,它们应当被归入同一个集合,否则测试结果会高估模型的泛化能力。在本例中,由于样本是独立生成的,采用随机划分即可。
下图概括了三个集合的划分方式,以及标准化统计量的来源与使用范围:
4. 模型:nn.Module 与前向计算
准备好数据之后,接下来定义模型:
1 | class Classifier(torch.nn.Module): |
运行结果:
1 | torch.Size([2, 2]) |
其中,nn.Module 会自动登记子模块与参数,而 forward 则定义了具体的计算关系。张量的形状依次为 [B,2] → [B,32] → [B,32] → [B,2],最后一层输出两个类别的 logits。调用模型时应写作 model(features),而不是 model.forward(features),因为前者还会执行模块中注册的钩子 (hook) 等附加逻辑。
把各层的输出形状与参数量逐一列出,可以核对模型的规模。参数全部集中在三个线性层中,ReLU 与 Dropout 都不含参数:
此外,模型中还使用了 Dropout(Srivastava 等,2014)。它在训练时以概率 $p$ 把中间激活随机置零,并将保留下来的分量放大 $1/(1-p)$ 倍,从而使期望保持不变。这样做可以迫使网络不依赖于少数特定的单元,因此它是一种常用的正则化 (regularization) 方法。而在评价阶段,随机丢弃会被关闭,同一个输入将得到确定的输出。原始 Transformer 同样使用了 $p=0.1$ 的 Dropout。
下图以 $p=0.5$ 为例,对比了同一组激活在两种模式下的处理结果:
5. 损失:logits 与交叉熵
有了模型的输出之后,就可以计算损失。以一个样本为例,设其 logits 为 $z=[2,-1]$,经过 softmax 得到 $p_0\approx0.9526$、$p_1\approx0.0474$。如果真实标签为 1,那么交叉熵损失为:
可以先用给定的 logits 验证这个单样本损失:
1 | example_logits = torch.tensor([[2., -1.]]) |
运行结果:
1 | loss = 3.0486 |
在 PyTorch 中,对应的写法为:
1 | loss_fn = torch.nn.CrossEntropyLoss() |
需要注意的是,CrossEntropyLoss 直接接收 logits,并在内部以数值稳定的方式计算上式;如果预先做了 softmax,就会改变损失的含义(第 02 章)。在评价阶段,概率可以通过 logits.softmax(dim=1) 得到,而预测类别则可以直接用 logits.argmax(dim=1) 获得,因为 softmax 并不改变分数的大小顺序。
此外,二分类任务也可以只输出一个 logit,并配合 BCEWithLogitsLoss 使用,此时标签应为浮点型的 0/1。总之,输出形状、标签格式与损失函数三者必须相互匹配。
6. 自动求导与参数更新
6.1 计算图与 backward
计算出损失之后,下一步是求梯度。PyTorch 会在前向计算时记录所执行的运算,从而构成一张计算图 (computational graph);随后,backward() 沿着计算图反向应用链式法则,并把梯度写入各个参数的 .grad 属性中。前面的单参数例子可以直接用代码验证:
1 | w = torch.tensor(2.0, requires_grad=True) |
运行结果:
1 | 2.0 30.0 |
这段代码背后的计算过程可以用一张计算图来表示:前向传播自左向右依次求值,反向传播则自右向左,把每个节点的局部导数逐级相乘。
6.2 训练步
把上述各个环节组合起来,一个批次的完整训练步如下:
1 | optimizer.zero_grad(set_to_none=True) |
值得注意的是,PyTorch 默认会把新的梯度累加到已有的 .grad 上,因此在每一步开始之前都需要先清零;其中,set_to_none=True 会直接释放梯度张量,可以略微节省内存。反过来,利用这一累加行为也可以实现梯度累积 (gradient accumulation):连续几个小批次只执行 backward,最后再统一执行 step,从而模拟更大的批量。此时,损失需要相应地除以累积的次数。
为了更清楚地看到这一过程,下图跟踪了一个参数 $w$ 在训练步各阶段的状态,并在下方展示了梯度累积的调用顺序:
6.3 常见的断图错误
另外,反向传播要求损失与参数之间的计算图保持完整。例如,loss.item() 返回的是普通的 Python 数值,适合用来写日志,但无法再参与求导;同理,把中间张量转换为 NumPy 数组再转回来,或者对它调用 .detach(),都会切断梯度路径。切断部分梯度路径时,其他参数可能仍能得到梯度;若最终损失完全脱离可求导张量,backward() 则会报错。计算图的连通性决定哪些参数实际受到监督。
7. 训练模式、评价模式与梯度记录
在训练与评价之间切换时,有三个相互独立的开关分别控制不同的行为:
| 机制 | 控制对象 | 典型用法 |
|---|---|---|
model.train() / model.eval() |
Dropout、BatchNorm 等层的行为 | 训练时使用 train,验证与推理时使用 eval |
torch.no_grad() |
是否记录计算图 | 验证与推理时关闭,以节省内存 |
optimizer.step() |
是否更新参数 | 仅在训练步中调用 |
因此,验证时通常需要同时使用前两者:
1 | model.eval() |
需要注意的是,如果只调用 eval(),框架仍然会记录计算图;而如果只使用 no_grad(),Dropout 则仍然处于训练时的行为。缺少其中任何一个,都会导致验证结果或内存占用出现偏差。
此外,在统计整个数据集的平均损失时,还需要按样本数进行加权:先将每个批次的损失(即批内均值)乘以该批的样本数,累加之后再除以总样本数。如果直接对各批次的均值取平均,就会高估最后一个不足额批次中样本的权重。
完成一个 epoch 的参数更新后,再使用同一组参数,在评价模式下计算训练集和验证集的指标。与之不同,日志中的 update_loss 是训练过程中各批次损失的均值,它是在 Dropout 开启、参数不断变化的条件下得到的,因此与 epoch 结束后的 train_loss 的统计条件不同,数值通常也会偏高。
8. 实验配置与结果
训练命令如下:
1 | python 04-train.py --output-dir runs/transformer-04 |
该算例使用 40 个 epoch、批量大小 64、隐藏维度 32、Dropout 0.1 和 Adam 学习率 0.01。按验证损失选择检查点后,得到以下分类结果:
| 项目 | 数值 |
|---|---|
| 参数量 | 1218 |
| 选中的检查点 | 第 27 个 epoch(验证损失最低) |
| 验证损失 / 准确率 | 0.2502 / 0.9389 |
| 测试损失 / 准确率 | 0.2189 / 0.9500 |
测试准确率接近独立标签翻转下 95% 的期望准确率。四个象限中的探测结果还可以检验模型是否学到了同号与异号的划分,单独一个准确率数值不足以确定模型对噪声的拟合程度。进一步地,对于四个探测点 (0.8,0.6)、(-0.8,0.6)、(-0.8,-0.6)、(0.8,-0.6),模型预测其属于类别 1 的概率依次约为 0.9679、0.0726、0.9728、0.0619,与同号、异号的划分相符。
运行结束后,输出目录中包含 history.csv(逐轮指标)、summary.json(配置与最终结果)以及 best.pt(选中的检查点)。其中,检查点保存了模型参数、优化器状态、标准化参数和划分索引。需要注意的是,在对新输入进行预测时,必须沿用训练集上估计的标准化参数。
逐轮记录包含训练集与验证集的损失和准确率。读取 04-history.csv,可以绘制两类指标随训练轮数的变化。
1 | import csv |
运行结果:
1 | selected epoch = 27 |
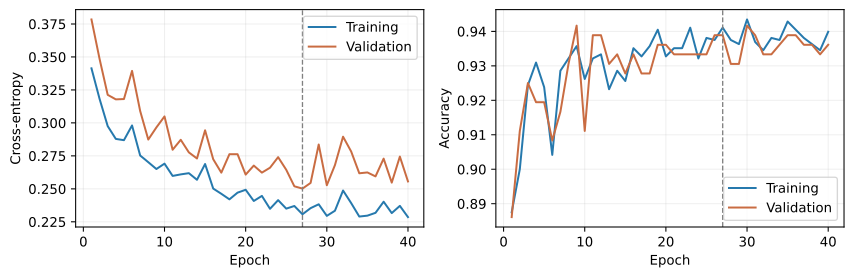
损失整体下降,但验证曲线有局部波动。验证损失最低点并不在最后一轮,因此保存中间检查点与直接使用最后一轮参数会得到不同结果。
9. 过拟合诊断与检查点选择
9.1 过拟合的信号
在训练过程中,如果训练损失持续下降,而验证损失却持续上升,那么这通常是过拟合 (overfitting) 的典型信号:模型正在记忆训练集中特有的细节,其中也包括噪声标签。不过,由于验证集的规模有限,单个 epoch 的波动并不足以下结论,需要观察多轮的变化趋势。此外,学习率过大、样本与标签错位、输出形状不匹配等问题同样会引起指标震荡,应当与过拟合分开排查。
为了直观地观察过拟合,可以通过缩小训练集、增大模型、去掉正则化的方式人为构造这一现象。以下命令保持验证集与测试集不变,只使用 64 个训练样本:
1 | python 04-train.py --train-limit 64 --hidden 128 --epochs 200 --dropout 0 --weight-decay 0 --output-dir runs/transformer-04-small |
在进行对比时,应重点关注两点:一是训练损失与验证损失之间的差距;二是验证损失最低的轮次与训练结束的轮次之间的距离。这两者都反映了模型容量、样本量与正则化三者之间的关系。
下图用示意曲线概括了过拟合的典型形态,以及早停式检查点选择的做法:
9.2 模型选择与断点续训
保存验证损失最低时的 state_dict,并在训练结束后重新加载这组参数来评价测试集,这种做法依据验证集选择训练过程中的检查点。Early stopping(早停)还需要在验证指标不再改善时提前结束训练;本算例完成全部训练轮次后恢复最佳参数,二者不应混为一谈。
需要区分的是,“选择模型”与“断点续训”对保存内容的要求并不相同。前者只需要恢复模型参数和预处理参数;而后者如果要精确地接着训练,还需要恢复优化器状态、学习率调度器、随机数状态以及数据遍历的位置。
9.3 从分类到序列
最后,把这套流程应用到 Transformer 上时,训练循环本身几乎不需要改变,变化主要集中在两处:一是输入由 [B,2] 的坐标变为 [B,L] 的 token 编号序列;二是输出由每个样本两个分数,变为每个位置一组词表分数 [B,L,V]。
参考资料
[1] Diederik P. Kingma and Jimmy Ba. Adam: A Method for Stochastic Optimization. International Conference on Learning Representations, 2015.
[2] Nitish Srivastava, Geoffrey Hinton, Alex Krizhevsky, Ilya Sutskever, and Ruslan Salakhutdinov. Dropout: A Simple Way to Prevent Neural Networks from Overfitting. Journal of Machine Learning Research 15, 1929–1958, 2014.
[3] PyTorch Contributors. Datasets & DataLoaders. PyTorch documentation.
[4] PyTorch Contributors. Optimizing Model Parameters. PyTorch documentation.
[5] PyTorch Contributors. Automatic Differentiation with torch.autograd. PyTorch documentation.
[6] PyTorch Contributors. CrossEntropyLoss. PyTorch documentation.
[7] PyTorch Contributors. Reproducibility. PyTorch documentation.
[8] PyTorch Contributors. Saving and Loading Models. PyTorch documentation.
- Code and experiment data: 04-train.py, 04-history.csv, 04-examples.py.