CH-05 自回归模型与序列建模
生成一段文本时,模型既要决定每个位置的内容,也要确定输出在何处结束。直接为所有可能句子建立概率表,会随长度和词表规模产生指数级的组合数量。Autoregressive modeling 将这一问题分解为根据已有前缀预测下一个 token 的条件分布。
“Autoregressive”一词来自时间序列分析。在统计学中,AR($p$) 模型用过去 $p$ 个时刻的观测值来线性预测当前值,例如,用最近几天的气温来预测今天的气温。由于变量是对“自身的过去”进行回归,因此得名。
在语言建模中,模型把同样的思想推广到离散的 token 序列上,并且去掉了“线性”与“固定窗口”两个限制:它用神经网络,根据可访问的已有前缀预测下一个 token 的概率分布。前缀的可用长度受模型配置与计算资源限制。GPT 系列、机器翻译中的解码器以及代码补全模型,均可采用这一条件预测方式。
下图对比了两者:左侧的 AR 模型只用固定窗口内的若干个观测值进行线性组合;右侧的语言模型则用神经网络读取任意长度的前缀,并输出整个词表上的概率分布。
1. 概率分解与训练目标
1.1 链式分解
首先从概率分解说起。设源序列为 $x$,目标序列为 $y_1,\ldots,y_T$,由第 02 章的链式法则可得:
需要强调的是,这是一个恒等式,并不依赖任何独立性假设。如果去掉条件 $x$,就得到了无条件的语言模型 $p_\theta(y_{1:T})$。所谓 autoregressive modeling,就是选定一个顺序,每一步都以已有的全部输出为条件,预测下一步的结果。这里的“顺序”通常就是文本的书写顺序,但并非必须如此,例如 XLNet 等工作就研究过其他的排列顺序。
这一分解的意义在于,它把“生成整段序列”这个指数级规模的问题,转化为了 $T$ 次在词表上的分类问题。由于每一步都是一个 $V$ 类分类问题,第 02 章介绍的 softmax 与交叉熵就可以直接使用。
1.2 序列表示与特殊标记
在具体实现中,token 序列需要经过 Embedding(将 token 编号映射为可学习向量的表示) 转换为张量:当批量大小为 $B$、序列补齐到长度 $T$ 时,编号张量的形状为 [B,T],查表之后变为 [B,T,d]。此外,还需要三类特殊标记来规定开始、结束与补齐位置:<bos> 表示开始,<eos> 表示结束,而 <pad> 用于补齐。
其中,<eos> 的作用常常被低估。模型必须学会何时停止,否则生成过程只能依靠长度上限来截断。因此,结束标记必须作为一个普通的预测目标计入概率和损失;与之不同,<pad> 只是批处理的产物,不应计入损失。
1.3 负对数似然
在此基础上,训练的目标是最小化目标序列的负对数似然:
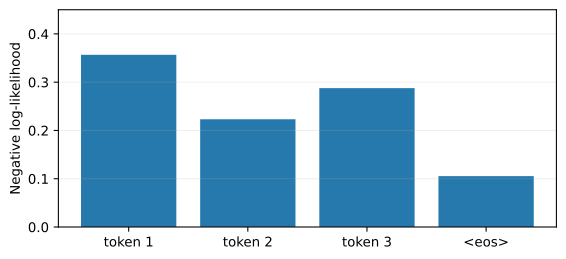
例如,对于一条包含 3 个普通 token 和 1 个 <eos> 的目标序列,如果各位置在正确前缀下的条件概率依次为 0.70、0.80、0.75、0.90,那么序列的概率为:
相应地,总损失为 $-\log0.378\approx0.9729$,按 4 个有效位置取平均约为 0.2432。
把每个位置的负对数概率单独画出来,可以看到序列损失的构成:每个位置都贡献一项,其中结束标记也不例外。
1 | import torch |
运行结果:
1 | P(sequence) = 0.3780 |
需要注意的是,每个条件概率都只属于特定的前缀。如果第二个 token 换成了别的词,那么第三步的条件也会随之改变,0.75 这个数值就不再适用。此外,在批量训练时,“对所有有效 token 求平均”会使长句贡献更多的项,而“先按句子平均、再对句子平均”则使每个句子的权重相同。由于两种做法的优化目标并不相同,因此需要明确地做出选择。
2. 循环神经网络的实现
2.1 状态递推
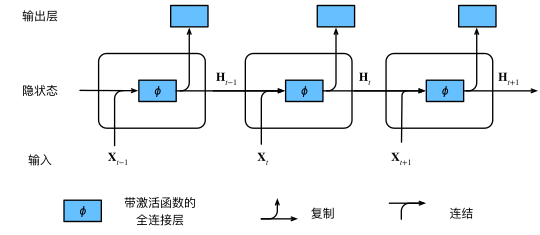
明确了概率分解之后,接下来的问题是如何用神经网络来计算这些条件概率。在 Transformer 出现之前,最主流的方案是 RNN,它用一个固定维度的隐藏状态来概括前缀。设当前的输入向量为 $e_t$、隐藏状态为 $h_t$,则有:
其中,$h_{t-1}$ 汇总了此前的前缀信息,$z_t$ 则是下一个 token 的 logits。由于所有时间步共享 $W_x,W_h,W_o$,同一组参数便可以处理任意长度的序列。对应的代码如下:
1 | import torch |
运行结果:
1 | torch.Size([1, 16]) |
这段代码使用的是随机初始化的参数,仅用于演示数据流:每读入一个 token,状态就更新一次,并给出一组下一个 token 的 logits。
把递推关系沿时间展开,RNN 的计算结构便清楚地呈现出来:同一组参数在每个时间步上重复使用,而隐藏状态则像一条传送带,把前缀的信息一步步向后传递。
2.2 梯度问题与门控
RNN 的训练通过时间反向传播 (Backpropagation Through Time, BPTT) 完成:先把递推过程展开为一个很深的前馈网络,再进行反向求导。损失对早期状态的梯度需要连乘许多个雅可比矩阵 $\partial h_t/\partial h_{t-1}$。若这些矩阵的算子范数都不超过同一个常数 $\rho<1$,那么沿该回传路径的梯度范数具有指数衰减的上界,可能出现梯度消失,使长距离依赖难以学习。梯度也可能在连续的变换中被放大,出现梯度爆炸,但放大量取决于梯度方向与各步矩阵的共同作用;仅有每个矩阵的范数大于 1,并不足以保证梯度指数增长。梯度裁剪可以限制爆炸梯度对单次参数更新的影响。
在一维标量递推的简化模型中,若每一步的局部导数均为同一个正数 $\lambda$,回传 $k$ 步后的梯度放缩倍率就等于 $\lambda^k$。这一算例排除了不同方向之间的旋转与混合,用于展示连续收缩或放大的累积效应。下图在对数坐标上画出了这一关系:
为了缓解这一问题,LSTM(Hochreiter & Schmidhuber, 1997)和 GRU(Cho 等, 2014)引入了门控机制,使状态可以通过近似加法的路径跨步传递,从而显著缓解了梯度消失。第 09 章介绍的残差连接与这一思路是相通的。
但是,门控机制并没有改变 RNN 的两个结构性质:一是第 $t$ 步必须等待第 $t-1$ 步计算完成,因此同一层内无法并行;二是所有的历史信息都要被压缩进一个固定维度的状态之中。而这两点,正是 Transformer 所要解决的问题。
3. Teacher forcing 与目标右移
3.1 构造输入与标签
在讨论了如何计算条件概率之后,接下来的问题是训练时如何构造输入与标签。Teacher forcing 指的是在训练时使用数据中的正确前缀作为条件,而不是使用模型自身的预测。具体的实现方式是,把目标序列右移一位作为解码器的输入。以英文 I like you 翻译为“我 / 喜欢 / 你”为例:
1 | decoder 输入:<bos> 我 喜欢 你 |
第一列用 <bos> 预测“我”,第二列用正确前缀“我”预测“喜欢”,依此类推。其中,输入在开头多了一个 <bos>,而标签在末尾多了一个 <eos>,二者恰好错开一位。这样一来,每个位置新读入的 token,都恰好是它所要预测的 token 的前一个。
在词表编号 <pad>=0、<bos>=1、<eos>=2、我=3、喜欢=4、你=5 的设定下,对应的代码为:
1 | target = torch.tensor([[3, 4, 5, 2]]) |
其中,reshape 把样本轴和位置轴合并在一起,使每个位置对应一次 $V$ 类分类;而 ignore_index=0 则排除了补齐位置的标签。
3.2 exposure bias
虽然 teacher forcing(训练时使用参考序列的正确前缀) 让训练过程稳定而高效,但它也带来了一个不一致的问题:训练时的条件总是正确前缀,而推理时的条件却是模型自己的输出。某一步预测错误后,后续条件会偏离当前参考序列的正确前缀;这种前缀可能在训练数据中较少出现,使后续条件预测更加困难,并可能形成累积错误。这一问题被称为exposure bias(训练与推理时前缀分布的差异)。对此,scheduled sampling(计划采样) 等方法尝试在训练中逐渐混入模型的预测,但标准的 autoregressive 最大似然训练仍使用 teacher forcing。这也意味着,逐 token 的验证损失与完整生成的质量需要分别进行评价。
下图对比了训练与推理时前缀的来源,可以直观地看到一次错误在推理中是如何被传递下去的:
4. causal mask 与训练并行
4.1 为什么右移还不够
对于 RNN 而言,仅仅右移就已经足够了,因为第 $t$ 步的状态天然只包含前 $t$ 个输入。然而,Transformer 的 self-attention(自注意力) 允许每个位置读取序列中的任意位置。例如,若不加任何限制,预测“喜欢”的第二列就可以直接读取第三列的输入,而第三列的输入恰恰就是“喜欢”本身,模型只需简单地抄写答案即可。
为此,需要引入causal mask(因果掩码),规定位置 $i$ 只能读取位置 $j\le i$。在加性形式中,允许的连接取 0,禁止的连接取 $-\infty$:
具体而言,掩码被加到注意力分数上之后再做 softmax,由于 $e^{-\infty}=0$,被禁止位置的权重就变为零(第 07 章)。由此可见,右移负责对齐输入与标签,而 causal mask 负责阻断向右的信息流,两者缺一都会造成标签泄露:如果缺少右移,当前位置的输入中就已经包含了答案;如果缺少掩码,答案则可以从右侧的位置传递回来。
下图以第 2 个位置为例,对比了三种设置下它能够读取的信息,从中可以清楚地看到右移与 causal mask 各自解决了什么问题:
长度为 4 时,可以直接构造禁止访问的右上三角。每一行对应一个查询,列对应它可能读取的位置:
1 | blocked = torch.ones(4, 4, dtype=torch.bool).triu(1) |
运行结果:
1 | tensor([[0, 1, 1, 1], |
第 0 行只能读取第 0 列;最后一行可以读取所有已有位置。这里假定输入已经右移,掩码本身不会替代右移操作。
4.2 并行性来自何处
那么,Transformer 的训练为什么比 RNN 更高效呢?在 teacher forcing 下,完整的正确前缀在训练开始之前就已经已知。此时,RNN 仍然需要逐步递推,而采用因果 self-attention 的 Transformer 则可以在一次矩阵运算中同时计算所有位置,并由掩码使每个位置只依赖其合法前缀。在参数固定、关闭 dropout 且计算约定一致时,这与逐步计算对应的条件预测在数学上等价;实际浮点结果可能存在舍入差异。所有位置可以并行执行,是 Transformer 训练的重要计算优势。
下图对比了两者在训练时的计算顺序:
然而,推理时的情况有所不同:必须先选出第 $t$ 个 token,才能把它作为输入去预测第 $t+1$ 个 token。因此,autoregressive generation 仍然是一个顺序过程,而第 11 章介绍的 KV 缓存正是为了降低这一过程中的重复计算。
下面的交互图展示了 I like you → 我 / 喜欢 / 你 的四个预测步骤。其中,$t$ 用于选择当前的预测位置,模式开关则用于切换输入的可用范围:“训练输入”包含完整的右移序列,而“生成前缀”只包含该步已经得到的 token。高亮行为当前的预测位置,上三角部分为禁止连接。生成模式以参考译文逐步构造前缀,用于展示不同预测位置的可访问范围。
可视化需要 JavaScript。
5. 解码策略
在推理阶段,模型每一步都会给出一个条件分布,而解码策略 (decoding strategy) 则决定了如何据此构造出输出序列。解码策略的选择虽然不影响模型参数,但对输出质量的影响很大。
5.1 greedy decoding
最简单的策略是greedy decoding(每一步选择概率最高的 token),即每一步都选择概率最大的 token。这种方法实现简单,但局部最优并不能保证整句最优。例如,设首词的两个候选概率分别为 0.6 和 0.4;沿着第一条路径,下一步最好的候选只有 0.5,而沿着第二条路径则有 0.9,之后两条路径都以概率 1 结束。那么,两条完整路径的概率分别为 $0.6\times0.5=0.30$ 与 $0.4\times0.9=0.36$,可见 greedy decoding 选择了概率较低的那一条。
5.2 beam search
为了缓解这一问题,beam search(每一步保留多个候选前缀的搜索) 在每一步都保留 $k$ 个累计对数概率最高的候选前缀,扩展之后再从中筛选出新的 $k$ 个;当 $k=1$ 时,它就退化为 greedy decoding。beam search 能够比较更多的路径,但有限的束宽仍然可能遗漏全局最优解。此外,由于每多生成一个 token 就要多乘一个小于 1 的概率,beam search 天然地偏好较短的序列,因此通常需要配合长度归一化或长度惩罚使用。原始 Transformer 在翻译任务中使用的束宽为 4。
下图用正文中的数值画出了这棵搜索树,并对比了 greedy decoding 与束宽为 2 的 beam search 在其上的选择过程:
5.3 随机采样
与上述确定性方法不同,开放式生成(如对话、写作)更加追求多样性,因此通常按分布进行随机采样,并借助以下几种方式来调整分布:
- 温度 (temperature) $\tau>0$:用 $\operatorname{softmax}(z/\tau)$ 进行采样。当 $\tau<1$ 时,分布更加尖锐,输出更加保守;当 $\tau>1$ 时,分布更加平坦,输出也更加多样。
- top-k:只保留概率最高的 $k$ 个候选,重新归一化之后再进行采样。
- top-p(又称 nucleus sampling):按概率从高到低依次累加,保留累计概率刚好达到 $p$ 的最小候选集合,再归一化并采样。与 top-k 相比,它的候选数量能够随分布的形状自适应地变化。
下图对同一个分布分别应用 top-k 与 top-p,可以看到二者保留的候选集合并不相同:
对翻译等需要保持源端内容的条件生成任务,beam search 和 greedy decoding 提供确定性的候选选择;对开放式生成,随机采样可以保留多样性。任务所需的忠实性、多样性与响应时间共同决定解码策略,参考译文也通常不是唯一的正确表达。
6. 贪心生成的实现
在确定解码策略之后,可以把 greedy decoding 写成如下循环。假设 model(source_ids, prefix) 返回每个前缀位置上的词表 logits:
1 |
|
这段代码的控制流可以概括为下面的循环:
这段代码中有几个实现细节值得注意:首先,只取最后一个位置的 logits,因为只有它对应于“下一个 token”;其次,max_new_tokens 的作用是防止模型始终不产生 <eos> 时陷入无限循环;最后,该实现限定批量大小为 1,如果要扩展到批量生成,还需要分别记录每个样本是否已经结束。
此外,这一实现每一步都会重新计算整个前缀,并且还会重复编码源句。复用源编码结果可以避免重复编码;KV 缓存则可以减少目标前缀的重复计算。
参考资料
[1] Aston Zhang, Zachary C. Lipton, Mu Li, and Alexander J. Smola. Dive into Deep Learning. Cambridge University Press, 2023. Online chapters: Language Models, Recurrent Neural Networks, Beam Search.
[2] Sepp Hochreiter and Jürgen Schmidhuber. Long Short-Term Memory. Neural Computation 9(8), 1735–1780, 1997.
[3] Samy Bengio, Oriol Vinyals, Navdeep Jaitly, and Noam Shazeer. Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks. Advances in Neural Information Processing Systems 28, 2015.
[4] Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes, and Yejin Choi. The Curious Case of Neural Text Degeneration. International Conference on Learning Representations, 2020.
[5] PyTorch Contributors. CrossEntropyLoss. PyTorch documentation.
[6] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, and Illia Polosukhin. Attention Is All You Need. Advances in Neural Information Processing Systems 30, 2017.
Code and experiment data: 05-examples.py.
Figure source: Aston Zhang, Zachary C. Lipton, Mu Li, and Alexander J. Smola, Dive into Deep Learning. rnn.svg, Original vector artwork, Reproduced without modification; Apache 2.0 license.