CH-02 概率论与数理统计
上一章的网络输出的是一组实数分数。然而,要把这些分数用于分类或文本生成,还需要回答三个问题:第一,分数如何转换为概率?第二,一整段序列的概率应该如何计算?第三,怎样衡量预测分布与真实数据之间的差距,从而得到一个可以优化的损失函数?
对应这三个问题,Softmax 将分类分数转换为归一化的分布,概率的 chain rule(链式法则)把序列概率分解为逐位置条件概率,cross entropy(交叉熵)则提供可优化的预测损失。它们分别规定 Transformer 的词表输出、序列建模方式与训练目标。本章还介绍期望和方差,为后续注意力中 $\sqrt{d_k}$ 缩放因子的推导作准备。
1. 联合概率与条件概率
1.1 定义
先以垃圾邮件分类为例,说明联合概率与条件概率。设一个邮箱中共有 100 封邮件,其统计情况如下:
- 30 封是垃圾邮件,70 封是正常邮件;
- 25 封包含关键词“中奖”;
- 在这 25 封邮件中,20 封是垃圾邮件。
现在从中等概率地抽取一封邮件。设事件 $A$ 为“是垃圾邮件”,事件 $B$ 为“邮件包含关键词‘中奖’”,则有:
其中,$P(A,B)$ 表示“邮件是垃圾邮件”和“关键词包含‘中奖’”两个事件同时发生的概率。数学上将这类概率称为联合概率 (joint probability)。如果已知邮件包含关键词“中奖”,那么抽取范围就缩小到了这 25 封邮件,其中垃圾邮件的比例为 $20/25=0.8$,这就是条件概率 (conditional probability):
等价地,上式也可以写作 $P(A,B)=P(A\mid B)P(B)$。
用方格表示这 100 封邮件,可以更直观地看到条件概率的含义:给定条件 $B$,相当于把统计范围从全部邮件缩小到含有关键词的那一部分,再在这一部分中重新计算比例。
1.2 条件方向与贝叶斯公式
需要注意的是,条件的方向不能互换。例如,已知是垃圾邮件时,包含“中奖”的比例为 $P(B\mid A)=20/30\approx0.667$,这与 $P(A\mid B)=0.8$ 并不相同,原因在于两者的统计范围分别是 30 封和 25 封邮件。两者之间的换算关系由贝叶斯公式 (Bayes’ theorem) 给出:
朴素贝叶斯分类器 (Naive Bayes Classifier) 正是利用这一公式,从“各类别中出现某个词的频率”推出“出现某个词时属于各类别的概率”。此外,条件概率描述的只是统计上的关联,本身并不表示因果关系。
1.3 模型中的条件分布
回到神经网络。在分类任务中,输入记为 $x$,类别记为 $y$,模型给出的预测分布写作 $p_\theta(y\mid x)$,其中 $\theta$ 表示模型参数。对于每个输入,模型都会在同一个候选类别集合上分配概率;而训练的目标,就是使这种条件分布与数据中的输入—标签关系相符。
2. 序列概率与链式法则
2.1 链式分解
在理解了条件概率之后,就可以讨论序列的概率。文本本质上是一个 token 序列。设三个位置的随机变量为 $Y_1,Y_2,Y_3$,它们的取值为 $y_1,y_2,y_3$。反复应用条件概率的定义,联合概率可以分解为:
这就是链式法则 (chain rule)。值得强调的是,它是一个恒等式,并不需要假设各位置相互独立:每个因子都可以依赖于前面的全部取值。反过来,如果直接把联合概率写成 $p(y_1)p(y_2)p(y_3)$,才是额外引入了独立性假设。独立性假设与词袋表示需要区分:前者限制随机变量之间的依赖,后者只记录 token 的出现情况,因此不保留次序。
下面以序列“猫/在/睡觉”为例,设模型给出:
那么,这三个 token 构成的前缀概率为 $0.4\times0.7\times0.5=0.14$。在这里,每个数都来自对应位置上的一个完整分布。例如,第二步的 0.7 表示“前缀为‘猫’时,下一个 token 为‘在’”的概率,其余候选则共同占据剩下的 0.3。因此,如果换一种排列方式,每一步的条件都会随之改变,不能通过简单交换这三个数来得到新序列的概率。
如果把每一步的候选都画出来,链式分解就对应于一棵概率树:从根节点出发,每经过一条边就乘上一个条件概率,而一条完整路径的概率就是沿途各边概率的乘积。
2.2 条件序列与结束标记
进一步地,机器翻译等任务还需要以源序列 $x$ 为条件:
其中,$T$ 是目标序列的长度,$y_{<t}$ 表示第 $t$ 个位置之前的前缀。这一分解把“生成一整段序列”的问题,转化为“反复预测下一个 token”的问题,它也是第 05 章 autoregressive model 的概率基础。
另外,如果要表示“序列恰好在此结束”,就必须把结束标记 <eos> 也作为一个预测目标计入乘积。例如,上例中的 0.14 只是三个普通 token 构成的前缀概率,并不包含结束事件。
3. 分类分布与 Softmax
3.1 定义
接下来讨论如何把网络输出的分数转换为概率。第 01 章的网络对输入 $x=[2,-1]$ 输出了 $z=[-1.4,1.4]$。假设这两个分量分别对应两个类别,那么这些分数(即 logits)可以取任意实数,还不满足概率非负、总和为 1 的要求。
对于 $K$ 个互斥且完备的类别,Softmax 函数将分数映射为:
其中,指数运算保证了每一项都为正,而除以总和则保证了归一化。对于上面的 logits,可以得到:
分数较高的类别获得了较大的概率。需要注意的是,如果一个样本可以同时属于多个类别(即多标签分类),就应该对每个类别单独使用 sigmoid,而不是用 softmax 在所有类别之间分配总和为 1 的概率。
用代码对照上面的两个类别,可以同时核对概率值及其总和:
1 | import torch |
运行结果:
1 | tensor([0.0573, 0.9427], dtype=torch.float64) |
为了更清楚地看到 softmax 的每一步做了什么,下面以四个类别为例,把“取指数”与“归一化”两步拆开展示。
3.2 平移不变性与数值稳定
Softmax 有一个重要的性质:它只依赖于分数之间的差。具体而言,如果给所有分量都加上同一个常数 $c$,那么公共因子 $\exp(c)$ 会在分子和分母中相互抵消:
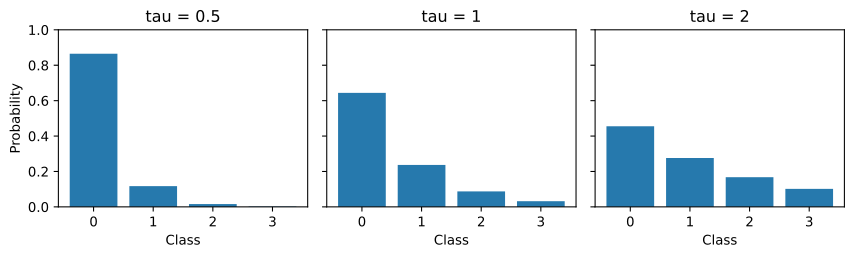
利用这一性质,实现中通常取 $c=-\max_jz_j$,使最大的指数输入为零,从而避免 exp 溢出。与平移不同,如果把所有分数都乘以一个大于 1 的数,就会放大分数之间的差距,使分布更加集中于最高分项,但类别的排名保持不变。后续第 05 章的采样温度与第 07 章的 $\sqrt{d_k}$ 缩放,都利用了这一性质。
例如,取四个候选的 logits 为 $[2,1,0,-1]$,计算 $\operatorname{softmax}(z/\tau)$,可以比较缩放的效果:除以一个小于 1 的数会放大差距,分布变得更尖锐;除以一个大于 1 的数则会缩小差距,分布变得更平坦。
1 | import matplotlib.pyplot as plt |
运行结果:
1 | tau=0.5: [0.865, 0.1171, 0.0158, 0.0021] |
3.3 归一化集合
此外,Softmax 的含义还取决于它在什么集合上进行归一化。在语言模型的输出层中,它在词表的所有 token 之间分配下一个 token 的概率;而在注意力中,它在可访问的序列位置之间分配加权系数。两者使用的是同一个运算,但表达的是不同的分布。
还需要注意的是,softmax 只保证输出具有概率分布的形式。例如,模型给某一类别 0.9 的概率,并不意味着这类预测在现实中有 90% 的正确率。预测概率与实际频率是否一致(称为校准 (calibration)),需要用数据另行检验。
4. 期望与方差
4.1 定义
期望与方差是描述随机变量的两个基本统计量,它们在注意力机制中也有直接的应用。以一个离散随机变量为例,设 $R$ 以 0.25 的概率取 0,以 0.75 的概率取 2。按概率对取值进行加权,就得到了期望 (expectation):
一般地,若 $R$ 取 $r_i$ 的概率为 $p_i$,则 $\mathbb E[R]=\sum_i p_ir_i$。在此基础上,方差 (variance) 被定义为取值偏离期望的平方的期望:
4.2 注意力中的加权平均
向量的期望可以逐分量计算。例如,令 $v_1=[1,0]$、$v_2=[0,2]$,对应的概率分别为 0.25 和 0.75,则:
注意力的输出具有完全相同的形式:它用 softmax 得到的权重对各个位置的 Value 向量进行加权求和。不过,这一运算是确定性的加权平均,并不会真的随机抽取某个 Value;把它称为期望,只是对其计算形式的一种解释。
4.3 点积的方差
此外,方差还可以用来解释注意力中的缩放因子。设 $q,k$ 都是 $d_k$ 维向量,且它们的所有分量相互独立、均值为 0、方差为 1。那么,每个乘积 $q_ik_i$ 的均值为 0、方差为 1,并且不同乘积之间也相互独立,因此:
由此可见,点积的标准差会随 $\sqrt{d_k}$ 增长,而除以 $\sqrt{d_k}$ 之后,方差便恢复为 1。这一推导并不要求正态分布,但依赖于独立性和上述矩条件。由于训练中的表示未必满足这些假设,所以它只能作为缩放设计的依据,而不是对实际分数分布的保证(第 07 章)。
5. 最大似然估计与交叉熵
5.1 似然函数
有了概率模型之后,接下来的问题是如何选择参数。设训练集包含 $N$ 个输入—标签对 $(x^{(n)},y^{(n)})$,并假设在给定输入的条件下,各样本的标签相互独立。那么,模型赋予这组观测标签的联合概率为:
如果固定数据,把上式看作参数 $\theta$ 的函数,它就被称为似然函数 (likelihood function)。最大似然估计 (Maximum Likelihood Estimation, MLE) 选择使似然最大的参数,即“使观测数据最有可能出现”的参数。需要注意的是,似然是比较不同参数的依据,它本身并不是参数的概率分布。
5.2 负对数似然
然而,直接连乘大量小于 1 的概率,会造成数值下溢。由于对数是严格递增函数,最大化 $L(\theta)$ 等价于最大化 $\log L(\theta)$。在此基础上取负号,并按样本数取平均,就得到了可以最小化的负对数似然 (Negative Log-Likelihood, NLL) 损失:
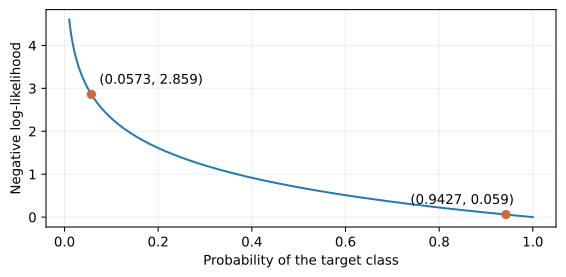
其中,$r_n$ 是模型为第 $n$ 个样本的观测标签分配的条件概率。仍以 logits $[-1.4,1.4]$ 为例:若标签是第二类,单样本损失为 $-\log0.9427\approx0.0590$;若标签是第一类,损失则为 $-\log0.0573\approx2.8590$。也就是说,模型给观测标签分配的概率越低,损失就越大;当这个概率趋于 0 时,损失趋于无穷。
负对数函数的形状决定了这种惩罚是不对称的:当概率接近 1 时,损失的变化很平缓;而当概率接近 0 时,损失会急剧增大。下图标出了上面两种情况在曲线上的位置。
1 | probability = torch.linspace(.01, 1., 300, dtype=torch.float64) |
5.3 与交叉熵的关系
分类任务常用的 cross entropy 与负对数似然可以通过目标分布联系起来。把类别标签 $y$ 表示为一个 one-hot(以单个非零分量表示类别身份) 分布 $r$,即 $r_y=1$,其余分量为 0。若模型的预测分布为 $p_1,\ldots,p_K$,则有:
上式左侧正是目标分布与预测分布之间的交叉熵 (cross entropy)。因此,当目标为 one-hot 分布时,交叉熵恰好等于负对数似然,这也是分类任务普遍使用交叉熵损失的原因。
进一步地,对序列使用链式分解之后,负对数乘积就变成了逐位置负对数概率之和。以“猫/在/睡觉”为例,总损失为 $-\log0.14\approx1.9661$,按三个位置取平均则为 0.6554。需要注意的是,当序列长度不同时,“按所有 token 平均”与“先按句子平均、再对句子平均”会赋予长句不同的权重;此外,填充位置是否计入损失,也会改变最终结果(第 03、05 章)。
最后,最大似然只优化训练集上的目标。模型在新数据上的表现属于泛化问题,需要在未参与训练的数据上进行评价(第 04 章)。
5.4 交叉熵的计算
设两个样本的 logits 分别为 $[-1.4,1.4]$ 和 $[1.85,1.65]$(即第 01 章两个输入的网络输出)。由于 PyTorch 的类别编号从 0 开始,目标 $[1,0]$ 表示第一个样本属于第二类,第二个样本属于第一类:
1 | import torch |
运行结果:
1 | tensor([[0.0573, 0.9427], |
运行后,两行概率分别约为 $[0.0573,0.9427]$ 和 $[0.5498,0.4502]$;单样本损失约为 $[0.0590,0.5981]$,平均损失为 0.3286。
其中,最常见的错误是在调用之前先做一次 softmax。下图对比了正确与错误两条路径:
在使用这一接口时,有以下三点需要注意:
- 输入原始 logits。
cross_entropy在内部等价于log_softmax加负对数似然。如果先调用 softmax 再传入,概率就会被当作新的 logits 再归一化一次,损失的含义也随之改变,而且代码并不会报错。 - 数值稳定。
log_softmax直接计算对数概率,从而避免了先取指数得到极小的概率、再对其取对数所造成的精度损失。 - 类别轴与索引。 类别索引必须对应 logits 的类别轴。对于序列任务,logits 的形状通常是
[B,T,V],需要展平为[B·T,V],或者把类别轴移到第 1 维,第 05 章会给出具体的写法。此外,reduction="none"会保留每个样本的损失,便于后续按掩码进行加权。
6. 熵、KL 散度与困惑度
6.1 熵
交叉熵这个名称来自信息论。为了理解它的含义,首先需要引入熵的概念。对于有限类别的分布 $P=(p_1,\ldots,p_K)$,熵 (entropy) 定义为:
并约定 $0\log0=0$。当全部概率集中于一个结果时,熵为 0;而均匀分布的熵最大,为 $\log K$。可见,熵刻画的是分布本身的不确定性,它并不需要真实标签。换言之,一个确信但错误的预测分布,同样可以具有很低的熵。
6.2 KL 散度
在此基础上,设 $P$ 为目标分布,$Q=(q_1,\ldots,q_K)$ 为模型分布,则交叉熵与 KL 散度 (Kullback–Leibler divergence) 分别定义为:
当所有满足 $p_i>0$ 的位置都有 $q_i>0$ 时,两者均为有限值,并且满足:
例如,当 $P=[0.5,0.5]$、$Q=[0.9,0.1]$ 时,$H(P)\approx0.6931$,$H(P,Q)\approx1.2040$,$D_{\mathrm{KL}}(P\Vert Q)\approx0.5108$。使用自然对数时,它们的单位为 nat;以 2 为底时,单位则为 bit。
直接按定义计算三个量,并核对分解等式:
1 | P = torch.tensor([.5, .5], dtype=torch.float64) |
运行结果:
1 | H(P) = 0.6931, H(P,Q) = 1.2040, KL = 0.5108 |
将三个量绘为堆叠柱,可以直接比较交叉熵的两个组成部分:交叉熵由两部分组成,下半部分是目标分布自身的熵,上半部分则是模型分布偏离目标分布所带来的额外代价。
由于 $P$ 固定时 $H(P)$ 是一个常数,因此最小化交叉熵等价于最小化 KL 散度。KL 散度是非负的,当且仅当两个分布相同时为零;但它一般不对称,因此不满足距离的定义。此外,如果某个 $p_i>0$ 而 $q_i=0$,KL 散度就会变为无穷大,这相当于模型把实际可能出现的结果判定为不可能。后续第 10 章介绍的 label smoothing(对目标分布分配少量非目标概率质量),就是把 one-hot 目标替换为一个略微分散的 $P$。
6.3 困惑度
在语言建模任务中,研究者通常用困惑度 (perplexity, PPL) 来报告模型效果。它是每个 token 平均负对数似然的指数:
沿用第 5.3 节“猫/在/睡觉”的序列算例,平均损失为 0.6554,对应的困惑度约为 $e^{0.6554}\approx1.93$。直观上,困惑度相当于模型在每一步“平均在多少个等可能的候选之间犹豫”:如果均匀地从 $K$ 个 token 中猜测,困惑度恰好为 $K$。需要注意的是,不同分词方式下的 token 数量不同,因此困惑度不能直接跨词表进行比较。
参考资料
[1] Aston Zhang, Zachary C. Lipton, Mu Li, and Alexander J. Smola. Dive into Deep Learning. Cambridge University Press, 2023. Online chapters: Probability and Statistics, Softmax Regression.
[2] Claude E. Shannon. A Mathematical Theory of Communication. The Bell System Technical Journal 27, 379–423 and 623–656, 1948.
[3] Chuan Guo, Geoff Pleiss, Yu Sun, and Kilian Q. Weinberger. On Calibration of Modern Neural Networks. Proceedings of the 34th International Conference on Machine Learning, 2017.
[4] PyTorch Contributors. CrossEntropyLoss. PyTorch documentation.
[5] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, and Illia Polosukhin. Attention Is All You Need. Advances in Neural Information Processing Systems 30, 2017.
- Code and experiment data: 02-examples.py.