CH-09 残差网络、LayerNorm 与 FFN
前两章讨论的注意力机制解决了“位置之间如何交换信息”的问题。然而,Transformer 需要把注意力与特征变换组合为多层网络;原始模型使用六层编码器和六层解码器,后续模型还会增加堆叠深度。增加层数扩大了可组合的特征变换,但也延长了信号与梯度的传播路径。各层 Jacobian(雅可比矩阵)的连乘可能压缩或放大梯度,激活值的尺度也可能随层数变化,使深层网络难以优化。
原始 Transformer 用三类组件组织上述计算:残差连接 (Residual Connection) 为信号和梯度提供跨层的直接通路;LayerNorm(逐位置的特征归一化) 对每个位置的特征向量进行归一化;FFN(逐位置前馈网络) 则为每个位置提供非线性特征变换。这三个组件与注意力子层共同构成可堆叠的编码器层。
1. 深层网络的退化与残差连接
1.1 退化问题
直觉上,更深的网络至少不应该比浅的网络更差:因为多出来的层只要学成恒等映射,深层网络就能够复现浅层网络的结果。然而,He 等人在 2015 年的实验中观察到了相反的现象:在 CIFAR-10 数据集上,56 层的普通卷积网络,其训练误差反而高于 20 层的网络。
需要强调的是,这并不是过拟合。过拟合的表现是训练误差低而测试误差高;而这里连训练误差都变高了,这说明问题出在优化上。换言之,一堆带有非线性的层很难恰好学成恒等映射,这种现象被称为退化 (degradation)。
下图用示意曲线对比了这一现象以及引入残差连接之后的变化:
1.2 残差参数化
针对这一问题,ResNet 的解决方法是改变网络的参数化方式。设目标映射为 $H(x)$,与其让网络直接拟合它,不如让网络去拟合残差 $F(x)=H(x)-x$:
这样一来,如果最优映射接近于恒等映射,网络只需要把 $F$ 推向零即可,这比用多层非线性去拟合一个恒等映射要容易得多。例如,当输入为 $x=[1,2]$、目标为 $[1.1,1.8]$ 时,残差分支只需要学习 $[0.1,-0.2]$ 这个修正量。残差连接本身既不增加参数,也几乎不增加计算量,却使训练上百层乃至上千层的网络成为可能。凭借一个 152 层的网络,ResNet 赢得了 ILSVRC 2015 图像分类比赛的冠军。
下图用上面的数值例子画出了残差块的结构:
1.3 短路投影与维度匹配
需要注意的是,残差相加要求两条分支的形状相同。例如,如果 $x$ 有 64 个通道,而 $F(x)$ 有 128 个通道,就需要用一个投影 $P$ 把短路分支映射到相同的空间:
在卷积网络中,$P$ 通常是一个带步幅的 $1\times1$ 卷积。而在 Transformer 中,各个子层的输入和输出都保持 $d_{\mathrm{model}}$ 维,因此可以直接相加。前一章中,multi-head attention(多头注意力) 的 $W^O$ 之所以要把拼接结果映射回模型维度,正是为了满足这一条件。
下图以通道数从 64 变为 128、空间尺寸减半的情形为例:
2. 残差块与梯度传播
2.1 卷积残差块
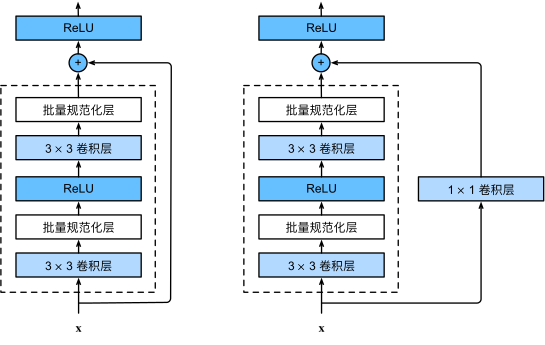
为了更具体地理解残差连接,下面先来看 ResNet 中的基本块。它由两次 $3\times3$ 卷积构成残差分支,分支内部使用 BatchNorm,相加之后再施加 ReLU:
1 | import torch |
运行结果:
1 | torch.Size([2, 32, 16, 16]) |
在这个例子中,两条分支都必须把空间尺寸从 $32\times32$ 降为 $16\times16$,并将通道数变为 32,才能够相加。此外,50 层及更深的 ResNet 改用了bottleneck block(先降维再恢复通道数的残差块):先用 $1\times1$ 卷积降低通道数,再用 $3\times3$ 卷积处理空间信息,最后用 $1\times1$ 卷积恢复通道数,从而减少计算量。但无论分支如何设计,相加节点的形状约束始终不变。
下图对比恒等短路与带投影的短路。上面代码中的 BasicBlock 使用右侧结构,投影分支负责匹配通道数与空间尺寸:
ResNet 的基本块与原始 Transformer 都会在相加之后接一个操作:前者是 ReLU,而后者是 LayerNorm。
2.2 恒等路径的梯度项
那么,残差连接为什么能够改善优化呢?答案在于梯度的传播方式。对于纯相加节点 $y=x+F(x)$,设 $J_F$ 为 $F$ 对输入的雅可比矩阵,则有:
第一项不经过残差分支内部的任何矩阵,因此构成了一条直接的梯度通路。进一步地,对于一组维度相同、并且相加之后没有额外变换的残差单元,逐层展开可以得到:
也就是说,最终的表示等于输入加上各层修正量之和,因此梯度可以从 $x_L$ 直接流回 $x_0$,而不必经过 $L$ 次矩阵连乘。这与第 05 章中 LSTM 缓解梯度消失的思路是一致的:用加法路径来替代纯乘法路径。
下图左侧展开了三个残差单元,右侧用一个简化模型对比了有无残差时梯度范数随层数的变化:
不过,这里还有两点需要注意。首先,两项梯度仍然可能相互抵消,因此恒等项并不能保证梯度的范数存在正的下界。其次,由于每个 $F_\ell$ 都作用于已经更新过的 $x_\ell$,各层之间仍然构成复合函数。此外,如果相加之后还接有 ReLU 或 LayerNorm,那么反向传播时还需要乘以它们的雅可比矩阵,上面的求和展开也就不再直接成立。而这一点,正是第 5 节讨论 Post-LN 与 Pre-LN 差异的出发点。
3. LayerNorm
3.1 为什么需要归一化
在深层网络中,每一层的输入分布都会随着前面各层参数的更新而改变,激活值的尺度也可能逐层放大或缩小。为此,归一化 (normalization) 操作会对激活值进行中心化和缩放,再通过可学习参数调整输出尺度,从而减轻特征幅度变化对后续计算的影响。控制局部特征尺度通常有助于改善优化条件,但合适的学习率和实际收敛速度仍取决于归一化位置、参数初始化与训练目标。
3.2 定义
具体而言,LayerNorm 对每个位置的特征向量单独计算统计量。对于一个 $d$ 维向量 $r$,有:
其中,$\epsilon>0$ 用于防止分母为零;$\gamma,\beta$ 是每个特征维度上可学习的缩放与平移参数,它们使网络在必要时能够恢复原有的尺度。此外,这些统计量是在每次前向计算中由当前输入实时求得的。
3.3 数值示例
下面沿用第 08 章的三位置算例进行说明。第三个位置的输入为 $x=[0,0,1,0]$,multi-head attention 的输出为 $m\approx[0.0911,1.1757,0.0819,0.5796]$,残差相加之后得到:
取 $\epsilon=10^{-5}$、$\gamma=1$、$\beta=0$,并使用未经四舍五入的 $r$ 进行计算,可以得到:
下图把这一计算拆成了几个步骤:
此时,输出的均值为 0,方差为 $\sigma^2/(\sigma^2+\epsilon)$,非常接近但并不严格等于 1。归一化保留了各个分量相对于均值的差异:第二、三个分量为正,第一、四个分量为负。此外,LayerNorm 对所有分量的共同平移保持不变,即 $r$ 与 $r+c\mathbf 1$ 会得到相同的结果。对应的代码如下:
1 | r = torch.tensor([ |
运行结果:
1 | tensor([-1.4770, 1.0223, 0.8060, -0.3513], dtype=torch.float64) |
需要注意的是,这里的方差使用的是分母为 $d$ 的定义,对应于 unbiased=False。对于形状为 $[B,L,d]$ 的输入,nn.LayerNorm(d) 会分别处理每个样本、每个位置的最后 $d$ 个特征,而所有位置共享同一组 $\gamma,\beta$。
3.4 LayerNorm 与 BatchNorm
在卷积网络中,更常用的归一化方法是 BatchNorm。二者的主要区别在于沿哪个轴计算统计量:
| BatchNorm | LayerNorm | |
|---|---|---|
| 统计范围 | 同一通道,跨批量(与空间位置) | 同一样本、同一位置,跨特征 |
| 训练与推理 | 训练时使用批统计量,推理时使用滑动平均 | 始终使用当前输入 |
| 是否依赖批量大小 | 是 | 否 |
下图以序列张量为例,直观地对比了两者的统计范围:
虽然 BatchNorm 在卷积网络中非常成功,但将其用于序列模型存在明显的不便:首先,批内序列的长度不一,填充位置会污染统计量;其次,当批量较小时,统计量的噪声较大;此外,在自回归推理时,批量大小常常为 1。相比之下,LayerNorm 只依赖于单个位置自身的特征,因此不存在这些问题,这也使它成为了 Transformer 的标准选择。
后来的大语言模型大多采用了一种简化的变体,即 RMSNorm(Zhang & Sennrich, 2019)。它去掉了均值中心化,只使用均方根进行缩放:
因此,RMSNorm 减少了均值计算,但是否能够替代 LayerNorm,需要结合模型结构与训练设置判断。
4. FFN
4.1 结构
在讨论了残差连接与归一化之后,接下来介绍编码器层中的另一个子层。FFN 会对序列的每一行独立地应用同一个两层 MLP:
在原始的基础模型中,FFN 的维度变化为 $512\to2048\to512$,即中间层扩大了 4 倍。因此,FFN 占据了每一层约三分之二的参数:注意力的四个投影共有 $4d^2$ 个参数,而 FFN 则有 $2\cdot d\cdot4d=8d^2$ 个参数。
下图画出了 FFN 的维度变化,以及它在每一层参数中所占的比例:
另外,所有位置共享 $W_1,b_1,W_2,b_2$,并且第 $i$ 行的输出只依赖于第 $i$ 行的输入。虽然该行可能已经通过注意力汇聚了其他位置的信息,但 FFN 自身并不引入任何跨位置的交互。由此可见,这两个子层的分工十分明确:注意力负责在位置之间混合信息,而 FFN 负责在每个位置内部变换特征。
4.2 分段仿射结构
从函数的角度来看,令 $D_z$ 为一个对角线上取 0 或 1 的矩阵,用于记录 $zW_1+b_1$ 的哪些分量为正。那么,在这些分量的符号保持不变的区域内,有:
也就是说,当 $D_z$ 固定时,FFN 是一个仿射变换;而当输入越过某个中间单元的零点时,$D_z$ 就会改变,局部映射也随之改变。因此,与第 01 章的 MLP 一样,ReLU FFN 是一个分段仿射函数,并且中间维度越大,可以划分出的区域就越多。此外,Geva 等人(2021)的分析表明,FFN 的第一层可以看作一组“键”,用于匹配输入中的特定模式,而第二层则是与之对应的“值”,这为理解 FFN 存储知识的方式提供了一种解释。对应的代码如下:
1 | ffn = nn.Sequential( |
运行结果:
1 | torch.Size([2, 3, 4]) |
输出形状保持为 [2,3,4];只改动第一个位置的输入,其余位置的输出保持不变,验证了 FFN 不混合位置。
后续模型还使用 GELU 或 SwiGLU。其中,SwiGLU 以两个独立投影的逐元素乘积替代单一激活分支。省略偏置,可写为:
其中,$\odot$ 表示逐元素乘法,$\sigma$ 是 sigmoid,$W_o$ 将中间维度映射回模型维度。两条投影分支都由当前 token 的特征产生,因此门控随输入变化;位置之间仍使用相同的参数,SwiGLU 本身不引入跨位置交互。
5. 编码器层的组织:Post-LN 与 Pre-LN
5.1 Post-LN
在介绍了三个组件之后,最后需要讨论如何把它们组织在一起。在原始 Transformer 的编码器层中,两个子层都采用“子层—dropout—残差相加—LayerNorm”的顺序:
由于归一化位于残差相加之后,这种结构被称为 Post-LN。其中,两处 LayerNorm 各自拥有独立的参数。
下面继续前面的数值算例(关闭 dropout,两处 LayerNorm 均取 $\gamma=1,\beta=0$)。第一次归一化得到的 $z$ 经过 FFN 变换之后,得到:
而第二次残差的短路输入是 FFN 的输入 $z$,相加并归一化之后得到:
在下面的交互图中,每一行对应一个计算阶段,四根棒分别表示四个特征,并且所有阶段共用同一个数值尺度。其中,右侧的两条旁路分别表示把 $X$ 加到 MHA 的输出上、把 $Z$ 加到 FFN 的输出上。此外,Query 选择器用于切换显示的位置,而参数保持不变。
可视化需要 JavaScript。
5.2 Pre-LN
然而,Post-LN 存在一个副作用:由于 LayerNorm 位于残差主干上,即使子层的输出 $F(x)=0$,整层的输出也是 $\operatorname{LN}(x)$,而不是 $x$。这意味着,第 2.2 节所讨论的恒等梯度通路被每一层的归一化打断了。Xiong 等人(2020)的分析表明,Post-LN 在初始化时靠近输出层的梯度较大,因此训练过程对学习率非常敏感,在其分析和实验设置下,学习率 warmup(训练初期逐渐提高学习率) 有助于避免初期的不稳定更新(第 10 章)。
针对这一问题,Pre-LN 把归一化移到了子层之前:
这样一来,残差主干上就不再有任何归一化操作,恒等路径可以从输入一直通到输出,因此深层模型的训练更加稳定。不过,这种结构通常还需要在整个堆栈的末尾再加一个 LayerNorm。GPT-2 及其后的大多数大语言模型都采用了 Pre-LN。这种组织方式改变了每层修正量相对于残差主干的尺度,因此训练稳定性与最终任务质量需要分别评价,不能由归一化的位置直接推断哪一种结构更优。在 PyTorch 中,TransformerEncoderLayer 可以通过 norm_first 参数在这两种结构之间切换。
下图对比了两种结构中 LayerNorm 的位置:
原始 Transformer 采用 Post-LN 结构:self-attention(自注意力) 负责跨位置的交互,FFN 负责逐位置的变换,而残差连接与 LayerNorm 则把这两个子层组织成了可以堆叠的单元。
参考文献
[1] Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. Deep Residual Learning for Image Recognition. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2016.
[2] Sergey Ioffe and Christian Szegedy. Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift. Proceedings of the 32nd International Conference on Machine Learning, 2015.
[3] Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E. Hinton. Layer Normalization. arXiv:1607.06450, 2016.
[4] Biao Zhang and Rico Sennrich. Root Mean Square Layer Normalization. Advances in Neural Information Processing Systems 32, 2019.
[5] Ruibin Xiong et al. On Layer Normalization in the Transformer Architecture. Proceedings of the 37th International Conference on Machine Learning, 2020.
[6] Mor Geva, Roei Schuster, Jonathan Berant, and Omer Levy. Transformer Feed-Forward Layers Are Key-Value Memories. Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing, 2021.
[7] Noam Shazeer. GLU Variants Improve Transformer. arXiv:2002.05202, 2020.
[8] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, and Illia Polosukhin. Attention Is All You Need. Advances in Neural Information Processing Systems 30, 2017.
[9] PyTorch Contributors. LayerNorm. PyTorch documentation.
[10] PyTorch Contributors. BatchNorm2d. PyTorch documentation.
Code and experiment data: 09-examples.py.
Figure source: Aston Zhang, Zachary C. Lipton, Mu Li, and Alexander J. Smola, Dive into Deep Learning. resnet-block.svg, Original vector artwork, Reproduced without modification; Apache 2.0 license.