CH-11 Transformer 的工程实现与应用
实现 Transformer 时,除了网络层本身,还需要正确组织输入、掩码、训练目标与推理过程。PyTorch 已经提供了现成的编码器层与解码器层,实现时仍需要明确各组件之间的数据约定,例如掩码的方向与形状、输入与标签的对齐、填充是否混入了损失,以及推理时的前缀管理。部分错误不会触发形状异常,例如缺失 causal mask(因果掩码) 时,模型可能读取包含标签的未来输入并降低训练损失,却不能按正确前缀生成。本章用规则明确的序列转换任务,把数据准备、条件预测与生成循环对应起来,再用因果性和填充不变性检验这一对应关系。
1. 受控的序列转换任务
1.1 为什么使用合成数据
在验证实现的正确性时,真实的翻译数据存在两个缺点:一是训练成本高;二是当结果不理想时,很难判断究竟是实现有误、数据不足,还是模型太小。相比之下,合成数据集的规则已知、规模可控,可以先检查模型是否具备学习该规则的能力;若没有学会,还需区分实现错误、优化设置、模型容量和训练轮数等因素。这与软件测试中先用简单输入来验证逻辑的思路是相同的。
1.2 句型规则
具体而言,源序列由主语、动词、宾语以及可选的 today 组成:
1 | 主语:i / you / we / they |
而目标序列则按照固定的词表逐词映射,同时把句末的 today 移到中文序列的开头:
1 | i like you → 我 / 喜欢 / 你 |
根据上述规则,一共可以得到 $4\times3\times4\times2=96$ 种组合。这一任务刻意包含了一处语序调整:today 从源序列的末尾移到了目标序列的开头。因此,仅靠逐位置替换无法完成全部样本,模型需要利用源端信息调整目标次序,cross-attention(交叉注意力) 为目标位置读取非对应位置的源表示提供了通路。该任务依据固定词表映射 token;语序调整是其需要学习的主要序列关系。
下图以一个包含 today 的样本为例,展示了这一任务的结构以及数据的划分方式:
1.3 数据划分与特殊标记
数据准备包括样本划分、特殊标记与批次构造。首先,这 96 个句对打乱后,被分为 72 个训练样本、12 个验证样本和 12 个测试样本。此外,词表只从训练集中建立,并且验证集与测试集中不包含未知词。因此,测试所评价的是同一规则下未见过的组合,而不涵盖更长的句子、新词或新的规则。
接着,源侧添加 <eos>,而目标侧同时添加 <bos> 与 <eos>:
1 | source i like you <eos> |
将这些序列组成批次时,源序列与目标序列分别补齐到各自批次内的最大长度,因此两者的长度可以不同。此外,固定编号为 PAD=0、BOS=1、EOS=2、UNK=3,其余编号则在源词表与目标词表中分别建立,二者不能混用。对应的右移操作如下:
下图以两个样本组成的批次为例,展示了补齐与右移之后的张量内容:
1 | import torch |
运行结果:
1 | tensor([[1, 4, 5, 6], |
2. 模型实现
2.1 配置
准备好数据之后,接下来确定模型的配置:
| 项目 | 取值 |
|---|---|
| $d_{\mathrm{model}}$ / 头数 / 每头维度 | 32 / 4 / 8 |
| 编码器层数 / 解码器层数 | 1 / 1 |
| FFN(逐位置前馈网络) 中间维度 | 64 |
| 激活 / 归一化位置 / Dropout | ReLU / Post-LN / 0.1 |
| 源词表 / 目标词表 | 15 / 12 |
| 总参数量 | 22,636 |
需要注意的是,这里的源嵌入、目标嵌入与输出投影各自独立,这一点与原始 Transformer 的三处权重共享不同,原因在于本任务的源端与目标端使用的是不同的词表。
按各模块逐项统计,可以核对 22,636 这个参数总数:
2.2 输入表示
在输入表示方面,记 $D=d_{\mathrm{model}}$,Embedding(将 token 编号映射为可学习向量的表示) 向量乘以 $\sqrt D$ 之后与固定的正余弦 positional encoding(位置编码) 相加,再进行 dropout:
其中,位置表通过 register_buffer 进行注册。这样一来,它会随着 model.to(device) 移动到相应的设备,也会被写入 state_dict,但它并不是参数,因此不会被优化器更新。此外,该实现预先生成了 64 个位置;当输入超过这一长度时,程序会直接触发异常,而不是静默地截断或越界。
2.3 编码器与解码器
在网络主体方面,编码器层与解码器层的定义如下:
1 | encoder_layer = nn.TransformerEncoderLayer( |
其中,batch_first=True 指定输入形状为 [B,L,D],norm_first=False 则对应于 Post-LN。此外,各层通过 ModuleList 逐个实例化,因此参数相互独立,并且堆栈的末尾不额外添加归一化层。
为把编码结果与目标生成连接起来,模型对外提供了三个接口:encode(source) 返回源表示 memory 和源 padding mask(填充掩码);decode(prefix, memory, src_pad) 返回目标前缀中各个位置的 logits;而 forward(source, prefix) 则依次调用前两者。这种拆分接口的设计,使得推理时只需要对源句编码一次(第 06 章)。
3. 掩码构造
3.1 三种掩码的分工
设源输入的形状为 [B,S],目标前缀的形状为 [B,T]。需要注意的是,在 PyTorch 的 Transformer 层中,布尔值 True 表示需要屏蔽:
1 | src_pad = source.eq(PAD) # [B,S] |
具体而言,三种注意力各自需要的掩码如下表所示:
| 注意力 | 查询来源 | 键值来源 | 需要的掩码 |
|---|---|---|---|
| 编码器 self-attention(自注意力) | 源 | 源 | src_key_padding_mask=src_pad |
| 解码器 self-attention | 目标 | 目标 | tgt_mask=causal,tgt_key_padding_mask=tgt_pad |
| cross-attention | 目标 | 源 | memory_key_padding_mask=src_pad |
对应的调用方式为:
1 | hidden = decoder_layer( |
其中,cross-attention 的掩码最容易被遗漏。由于它的键和值来自源端,因此需要的是源端的 padding mask,而不是目标端的 padding mask。
下图把三种注意力所需的掩码画在一起,便于对照检查:
3.2 掩码语义与输出处理
除了形状,掩码的作用位置与接口语义也必须一致:
- 掩码只作用于键。 填充位置作为查询时仍然会产生非零的输出,因为其表示会受到 positional encoding、偏置和归一化的影响。因此,这些位置的标签必须在损失中被排除。
- 布尔语义不统一。 在底层函数
F.scaled_dot_product_attention中,attn_mask=True表示允许参与计算,这与 Transformer 层中的约定恰好相反。所以,在替换注意力实现时,需要同时转换掩码的语义,并检查其广播形状。 - dropout 参数。
scaled_dot_product_attention会直接根据dropout_p执行 dropout,而并不感知model.eval()的状态,因此在评估时必须显式地传入dropout_p=0.0。
4. 训练
4.1 有效 token 上的交叉熵
构造好掩码之后,就可以开始训练。首先,输出投影会把形状为 [B,T,32] 的隐藏表示映射为形状为 [B,T,12] 的 logits。完整的训练循环如下:
1 | criterion = nn.CrossEntropyLoss(ignore_index=PAD) |
在这里,损失按照批次内有效目标 token 的数量取平均。设有效位置的集合为 $\mathcal I$,则有:
以一个含两个有效标签和一个填充标签的批次为例,可以直接核对分母:
1 | import torch.nn.functional as F |
运行结果:
1 | tensor([0.1698, 0.1698, 0.0000]) |
第三项损失为零,平均时仍须除以有效标签数 2,而不是数组长度 3。
需要特别注意的是,掩码只屏蔽了作为键的填充位置,填充位置作为查询时仍然会产生输出。下图说明了这一点,以及损失函数如何排除这些位置:
其中,<eos> 代表需要学习的结束决策,因此需要计入损失;而 <pad> 只是占位符,因此不计入损失。此外,在统计整个 epoch 的损失时,应当先把每个批次的平均损失乘以该批次的有效 token 数,累加之后再除以总数,从而使每个有效 token 具有相同的权重。
把上面的训练循环按执行顺序展开,一个训练步包含以下环节:
另外,训练循环中还使用了梯度裁剪 (gradient clipping):当整体梯度的范数超过阈值时,按比例缩小梯度,以防止个别批次的大梯度破坏训练。梯度裁剪约束的是单次更新之前的梯度范数,不会直接保证损失下降。本算例使用固定学习率与普通交叉熵。
4.2 验证与检查点选择
在每个 epoch 结束之后,模型会在 eval() 模式下、关闭梯度记录的条件下计算验证损失;并且,每当验证损失创下新低时,就保存一份当前的参数。训练结束之后,载入验证损失最低的那组参数,再在测试集上进行评价。需要强调的是,测试集既不参与参数更新,也不参与检查点选择。
训练损失与验证损失随训练轮数的变化如下:
在保存参数时,需要使用 copy.deepcopy(model.state_dict()),或者立即将其写入文件。这是因为 state_dict() 返回的是参数张量的引用,如果只是把它赋值给另一个变量,那么后续的训练会继续修改这些张量,所谓“保存的最优参数”实际上始终是最新的参数。
此外,验证损失是在 teacher forcing(训练时使用参考序列的正确前缀) 的条件下计算的,因此它只能反映正确前缀下的预测质量,而完整生成的质量还需要单独进行评价。
5. 自回归推理
训练完成之后,就可以进行推理。由于源序列在一次生成过程中保持不变,它的编码结果 memory 只需要计算一次。在此基础上,greedy decoding(每一步选择概率最高的 token) 从 <bos> 开始,每一步都选择最后一个位置上得分最高的 token,并将其追加到前缀中,直到生成 <eos> 或达到长度上限为止:
1 | model.eval() |
其中,torch.inference_mode() 比 no_grad() 更进一步,关闭了部分用于自动求导的状态记录,例如版本计数,因此可以减少推理期间的相关开销。此外,12 是生成长度的上限,用于处理模型迟迟不产生 <eos> 的情况。需要注意的是,当模型位于 GPU 上时,source、prefix 以及掩码也都必须位于同一设备上。
在评价整句时,要求预测序列与参考序列完全一致,并且在正确的位置产生 <eos>。值得注意的是,即使逐 token 的准确率很高,整句仍然可能出错:一旦某一步选错,后续的条件就已经偏离了训练时的正确前缀(即第 05 章所讨论的 exposure bias(训练与推理时前缀分布的差异))。
另外,这一实现虽然复用了源编码,但并没有缓存目标侧的键和值,因此每一步仍然会重新计算整个前缀。第 7.3 节将讨论如何消除这部分重复计算。
6. 实验结果与行为测试
6.1 运行与结果
训练命令如下:
1 | python 11-transformer.py --epochs 160 --output transformer-run |
训练后,按验证损失选择的参数得到以下序列预测结果:
| 项目 | 结果 |
|---|---|
| 训练轮数 / 选中轮次 | 160 / 第 154 轮 |
| 验证集每 token 交叉熵 | 约 0.000585 |
| 测试集每 token 交叉熵 | 约 0.000453 |
| 测试集 teacher forcing token 准确率 | 100% |
| 测试集贪心生成整句精确匹配 | 12/12 |
11-history.json 记录每轮的训练损失、验证损失与验证 token 准确率,可用于绘制训练曲线。
1 | import json |
运行结果:
1 | selected epoch = 154 |
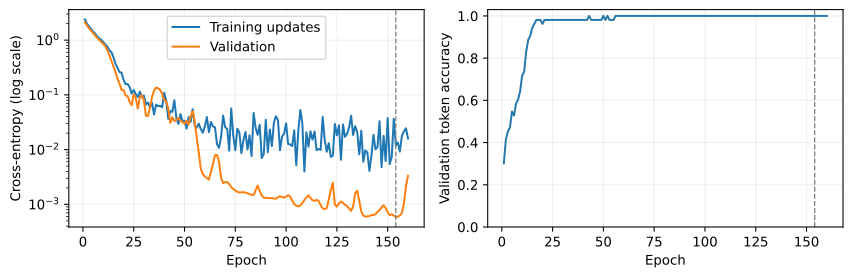
两条损失曲线的统计条件不同,不宜将它们的差值直接解释为泛化误差。验证准确率达到 1 后,损失仍可继续下降,因为正确 token 的预测概率还可以提高。
部分生成示例如下:
1 | 输入:they see them today |
模型正确地处理了全部 12 个未参与训练的组合,其中也包括需要移动 today 的样本。在该数据集上,测试评价的是既定词表和句型中的未见组合;更长输入、新词与新的语法规则属于不同的泛化问题。
6.2 行为一致性测试
然而,准确率高并不能证明实现是正确的:若模型能够访问包含当前目标的输入位置,那么在 teacher forcing 下也可能达到 100% 的准确率。实现还应满足以下三条不依赖于训练效果的性质:
- 因果性:修改目标前缀中较晚位置的 token,较早位置的 logits 应当保持不变。如果 causal mask 缺失或方向写反,这项测试就会失败。
- 源填充不变性:在源序列末尾追加填充之后,已有目标位置的 logits 应当在浮点误差范围内保持不变。这项测试同时检验了编码器与 cross-attention 是否正确地屏蔽了源端的填充。
- 保存与载入:保存参数、模型配置和两个词表,重新构造模型之后,同一输入得到的 logits 应当与保存之前一致。
下图概括了三项测试各自的做法与检测目标:
三项测试在评价模式下进行,以排除 dropout 的随机性,并可作为修改模型后的回归测试。
另外,当前的检查点主要用于恢复推理。如果需要精确地续训,还需要保存优化器、学习率调度器以及随机数的状态,并恢复数据遍历的进度。
7. 计算复杂度与推理优化
7.1 计算量与中间存储
在完成了基本实现之后,接下来分析它的计算开销。设批量大小为 $B$、序列长度为 $L$、隐藏维度为 $D$,那么每一层的主要开销如下:
| 部分 | 计算量 |
|---|---|
| Q/K/V 与输出投影 | $O(BLD^2)$ |
| 注意力分数与加权求和 | $O(BL^2D)$ |
| FFN | $O(BLDd_{\mathrm{ff}})$ |
由此可见,当序列较短时,投影与 FFN 在计算中占主导地位;而当 $L$ 超过 $D$ 的量级之后,注意力的二次项便会占据主导。
相比于计算量,存储上的压力往往更为突出。例如,如果显式存储每个头的注意力矩阵,就需要 $BhL^2$ 个元素:当 $B=8$、$h=8$、$L=1024$ 时,一共有 67,108,864 个元素,仅单个 float32 张量就要占用 256 MiB,这还不包括反向传播所需的其他激活、梯度以及优化器状态。对此,常用的缓解手段包括:
- 按长度分桶:把长度相近的样本放入同一个批次,从而减少填充所造成的无效计算。
- 混合精度:使用 float16 或 bfloat16 来存储和计算部分张量,从而降低显存与带宽的开销,但需要注意数值稳定性。
- 激活重计算 (gradient checkpointing):不保存部分中间激活,而是在反向传播时重新计算,以计算换取显存。
下图展示了注意力矩阵的显存占用随序列长度的增长:
另外,在评估性能时,需要分别记录吞吐量与峰值显存,并区分数据加载、首次初始化与稳定执行三个阶段。由于 GPU 是异步执行的,计时之前还需要先同步设备。
7.2 FlashAttention
在各种优化方法中,FlashAttention(Dao 等,2022)的出发点是:在现代 GPU 上,注意力的执行时间不仅取决于浮点运算,还取决于高带宽显存(HBM)与片上 SRAM 之间读写 $L\times L$ 的中间矩阵。为此,它把 Q、K、V 分块载入 SRAM,并用在线 softmax 逐块累积结果,从而不再需要在显存中存储完整的注意力矩阵;而在反向传播时,再按块重新计算。
值得强调的是,FlashAttention 计算的是精确的稠密注意力,只是浮点运算的顺序有所不同,因此可能带来极小的数值差异。它将额外的显存开销从 $O(L^2)$ 降低到了 $O(L)$,但运算量中仍然含有 $L^2$ 项。在 PyTorch 中,F.scaled_dot_product_attention 会在条件满足时自动选用这类高效内核。
这一分块计算依赖 Online softmax(在线 softmax),它使逐块累积仍能得到全体 Key 上的归一化结果。对一个 Query,设已经访问的 Key 集合为 $\mathcal P$,其分数最大值为 $m$,指数和为 $\ell$,未归一化的 Value 加权和为 $u$。加入新块 $\mathcal B$ 时,更新为:
新的最大值可能改变指数的基准,系数 $a$ 将旧的累积量重新缩放到同一基准。因而,逐块更新等价于对已访问的全部分数做一次 softmax,而无须保存所有权重。对每个 Query 保留这些累积量,便可把注意力计算组织为 SRAM 中的矩阵块运算。
下图对比了标准实现与 FlashAttention 的计算流程:
7.3 KV 缓存
除了训练阶段的优化之外,推理阶段同样存在优化空间。在 autoregressive generation 中,第 $t$ 步只需要最后一个位置的输出。由于 causal mask 的存在,已有位置的表示并不依赖于后续的 token;因此,在参数固定、dropout 关闭的情况下,追加新的 token 并不会改变各层中历史位置的键和值。基于这一性质,可以构建 KV cache(键值缓存),保存每一层已经计算过的 K、V,每一步只为新位置计算 Q、K、V,再用新的查询去读取缓存。同理,cross-attention 中源端的 K、V 也可以在生成开始之前按层计算好,并在后续步骤中复用。
这样一来,每一步的投影与 FFN 从处理完整前缀减少为只处理新位置,新的 Query 仍需读取历史 K/V,其代价则是一个随生成长度增长的缓存。具体而言,设前缀长度为 $T$,那么对于标准的 multi-head self-attention,每一层的缓存约为 $2BTD$ 个元素,其中系数 2 分别对应于 K 与 V。在长上下文场景中,KV 缓存常常会成为显存的主要占用者,并由此催生了一系列减少缓存的结构。例如,Multi-Query Attention(多查询注意力,MQA)让所有 Query heads 共享一组 K/V;Grouped-Query Attention(分组查询注意力,GQA)则让每组 Query heads 共享 K/V。若有 $H_q$ 个 Query heads 和 $H_{kv}$ 个 KV heads、每头维度为 $d_h$,单层缓存需要 $2BT H_{kv}d_h$ 个元素,MHA 则有 $H_{kv}=H_q$。GQA 可以从 MHA checkpoint 出发,对同组 K/V 投影权重取均值进行初始化,再通过继续预训练适应新的共享方式;因此它同时改变模型结构与已有参数的使用方式。
下图对比了有无 KV 缓存时,生成第 4 个 token 所需的计算:
此外,在实现 KV 缓存时,还需要处理 positional encoding 的偏移、批次中各个句子的有效长度与结束状态,以及 beam search(每一步保留多个候选前缀的搜索) 中缓存随候选的重新排列。需要特别注意的是,当每一步只输入一个查询时,掩码的形状会变为 $1\times T$,因此不能照搬训练时的方阵下三角掩码。
8. 结构变体与应用
8.1 三种结构
原始的编码器—解码器结构只是 Transformer 的一种用法。根据所保留的组件,可以将其分为以下三类:
| 结构 | 注意力模式 | 典型训练目标 | 代表模型 | 典型任务 |
|---|---|---|---|---|
| 仅编码器 | 双向 self-attention | 掩码语言建模 | BERT | 分类、序列标注、检索 |
| 仅解码器 | 因果 self-attention | 下一个 token 预测 | GPT 系列 | 文本生成、对话、代码 |
| 编码器—解码器 | 双向 + 因果 + 交叉 | 条件生成 | 原始 Transformer、T5 | 翻译、摘要 |
其中,仅编码器 (encoder-only) 模型可以利用完整输入的双向上下文。对于分类任务,通常取一个特殊位置(如 BERT 中的 [CLS])的表示,或者排除填充之后的平均表示,再接入分类头;而对于序列标注任务,则为每个有效位置输出一个标签。BERT 通过随机遮盖部分 token 并对其进行预测来完成预训练,而网络结构与训练目标是两个相互独立的设计选择。
与之不同,仅解码器 (decoder-only) 模型去掉了编码器与 cross-attention,只保留带 causal mask 的 self-attention,并使用第 05 章介绍的下一个 token 预测进行训练。由于它把“输入”也视为前缀的一部分,一个模型便可以统一处理续写、问答、翻译等多种任务,这也是当前大语言模型的主流结构。
从注意力模式上看,三种结构的区别一目了然:
8.2 视觉 Transformer
更进一步地,Transformer 层处理的是向量序列,因此输入单位并不一定是文字。视觉 Transformer (Vision Transformer, ViT)(Dosovitskiy 等,2020)就把图像切分为不重叠的 patch,并把每个 patch 视为一个 token。例如,对于一张 $224\times224$ 的 RGB 图像,按照 $16\times16$ 进行切分,可以得到 $14\times14=196$ 个 patch;每个 patch 展开后包含 $16\times16\times3=768$ 个数,再经过线性投影变为 $D$ 维,最终组成一个形状为 [B,196,D] 的序列。
在实现上,不重叠 patch 的线性投影可以用步幅等于卷积核大小的卷积来实现:
1 | import torch |
由于卷积核与步幅相同,并且没有填充,每个输出位置恰好对应于一个 patch 的线性投影,并且所有 patch 共享同一组投影参数。在此基础上,加入可学习的位置嵌入(否则模型无法感知空间布局,见第 08 章)以及一个分类 token 之后,长度为 197 的序列便可以送入标准的 Transformer 编码器,最后再由分类头把分类 token 的最终表示映射为类别分数。
下图概括了 ViT 从图像到分类结果的完整流程:
原始 ViT 使用不重叠 patch 和全局 self-attention,没有像 CNN 那样逐层规定局部感受野与空间平移的结构约束。在原论文的设置中,较大规模预训练有助于 ViT 学习这些视觉关系;使用何种数据规模和正则化方法,会显著影响它与 CNN 的比较。后续 Swin Transformer 则通过局部窗口与层级特征重新引入部分空间结构。
从文本到图像,Embedding、注意力、残差连接、LayerNorm(逐位置的特征归一化) 与 FFN 提供了可复用的向量序列计算。输入切分、位置关系、可访问范围和训练目标仍需随模态设计;这些约定决定了共享组件在具体任务中的信息流。
参考资料
[1] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, and Illia Polosukhin. Attention Is All You Need. Advances in Neural Information Processing Systems 30, 2017.
[2] Aston Zhang, Zachary C. Lipton, Mu Li, and Alexander J. Smola. Dive into Deep Learning. Cambridge University Press, 2023.
[3] PyTorch Contributors. TransformerEncoderLayer. PyTorch documentation.
[4] PyTorch Contributors. TransformerDecoderLayer. PyTorch documentation.
[5] PyTorch Contributors. scaled_dot_product_attention. PyTorch documentation.
[6] PyTorch Contributors. Saving and Loading Models. PyTorch documentation.
[7] PyTorch Contributors. Reproducibility. PyTorch documentation.
[8] Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. Advances in Neural Information Processing Systems 35, 2022.
[9] Noam Shazeer. Fast Transformer Decoding: One Write-Head is All You Need. arXiv:1911.02150, 2019.
[10] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, and Sumit Sanghai. GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, 2023.
[11] Jacob Devlin, Ming-Wei Chang, Kenton Lee, and Kristina Toutanova. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, 2019.
[12] Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, and Ilya Sutskever. Language Models are Unsupervised Multitask Learners. OpenAI technical report, 2019.
[13] Alexey Dosovitskiy et al. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. International Conference on Learning Representations, 2021.
- Code and experiment data: 11-transformer.py, 11-history.json, 11-results.json, 11-examples.py.