人体运动建模-绪论
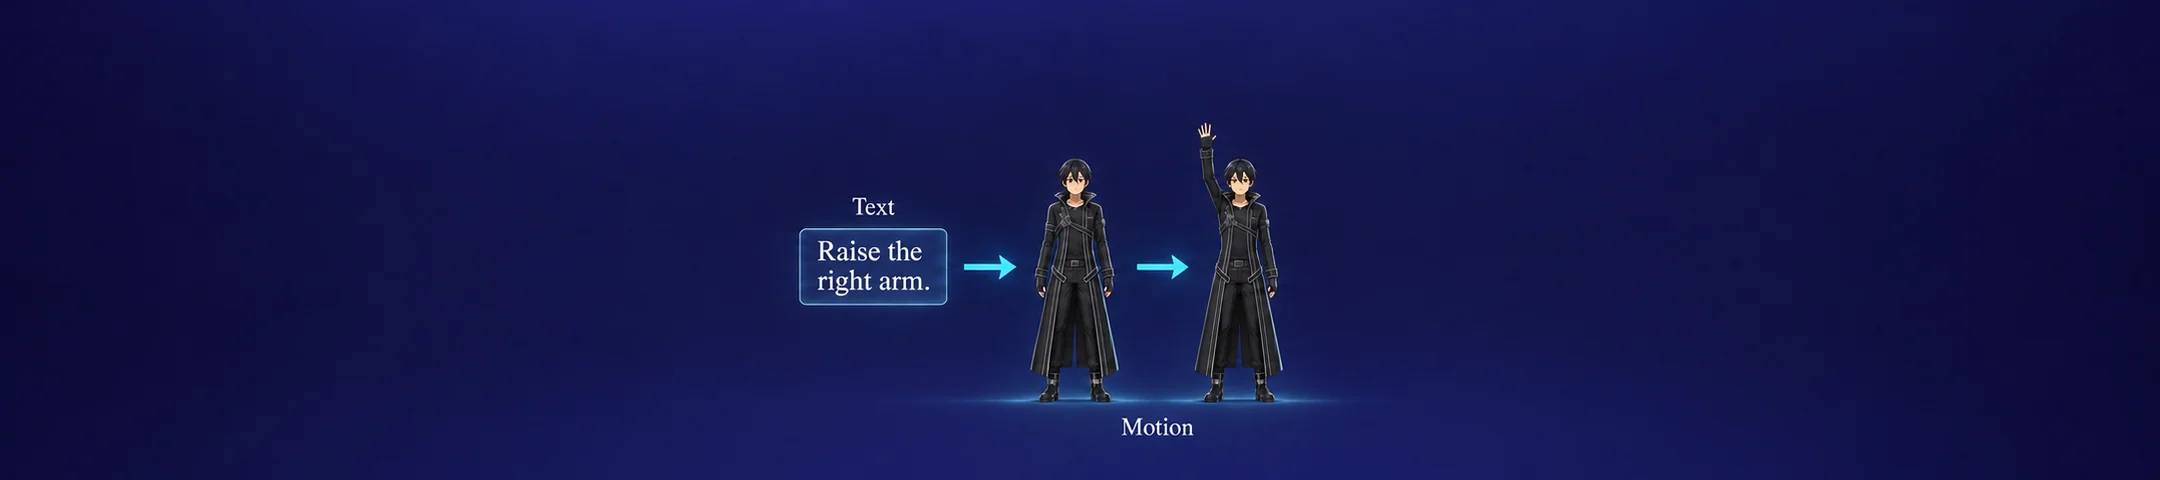
Human motion(人体动作)描述身体姿态及其整体位置、朝向随时间变化的过程。例如,行走需要下肢交替支撑与全身协调,搬运还需要手部运动与物体轨迹相配合,握手则涉及两个人的动作时序和接触位置。要在计算机中描述这些过程,需要把可见的身体运动转换为关节坐标、旋转或人体表面参数,并保留它们在时间上的联系。三维人体动作建模由此连接计算机视觉中的运动估计、计算机图形学中的角色动画,以及机器人学中的参考运动与反馈控制;自然语言、视觉观测和环境几何则为这些模型提供不同形式的任务条件。
1. 姿态、动作与行为
人体运动可以从三个相互联系的层次描述:单个时刻的几何配置、多个时刻组成的运动过程,以及运动在环境中的任务含义。以抬臂动作为例,右臂抬起时的关节角度属于几何配置;手臂从下垂到上举的变化属于时序过程;向他人示意或伸手取物则赋予这段运动不同的任务含义。以广义坐标 $q_t$ 表示第 $t$ 帧的身体配置时,kinematics(运动学)研究配置、速度和加速度之间的几何关系;dynamics(动力学)进一步研究质量、惯性、驱动力矩与接触力如何产生这些运动。
Pose(姿态)指某一时刻的身体配置,通常用关节位置或相对于父关节的旋转描述;motion 则记录姿态与整体位姿随时间的变化。单帧姿态往往不能唯一确定动作类别:“单臂上举”可以出现在挥手、防护、投掷或伸展过程中。区分这些动作,需要结合前后帧中的速度、运动方向与动作阶段,即 temporal context(时序上下文)。
完整运动同时包含身体内部的姿态变化与相对于环境的整体运动。骨盆附近的 root(根节点)通常用于记录整体平移和朝向,其随时间变化形成 root trajectory(根轨迹)。例如,向前行走与原地踏步可以具有相近的下肢摆动,但根的位移不同。在动画系统中,可以分别控制局部步态和角色位移,也可以由动画中的 root motion 驱动整体移动。如果步态的支撑阶段与角色移动速度不一致,接触地面的足部就可能发生 foot sliding(足部滑动)。
在几何与时序描述之外,Action(动作类别)与 behavior(行为)描述运动的语义,“搬运”这样的标签并不唯一确定每一帧的姿态。复杂行为还可能包含接近、接触、操作和离开等阶段。Interaction(交互)进一步要求参与者与环境之间的关系相容:握手需要双方手部在合适的时刻到达同一接触区域,搬运需要手部与物体协调运动,坐下则需要身体与座面保持支撑接触。这些关系首先表现为几何和时序约束;分析实际支撑或负载时,还需要引入接触力与动力学方程。
姿态、运动和行为之间通常不存在一一对应关系。同一段伸手运动可以用于取物、按键或示意,同一搬运目标也可以通过不同步幅和手部姿态完成。设运动为 $X$、环境与任务信息为 $E$,动作理解所估计的是语义分布 $p(Y\mid X,E)$,其中 $Y$ 可以是动作类别、文本描述或其他任务语义输出。当输入缺少物体或场景信息时,对操作对象与目的的判断会更不确定;模型应区分由运动观测支持的属性与依据统计先验推断的语义。
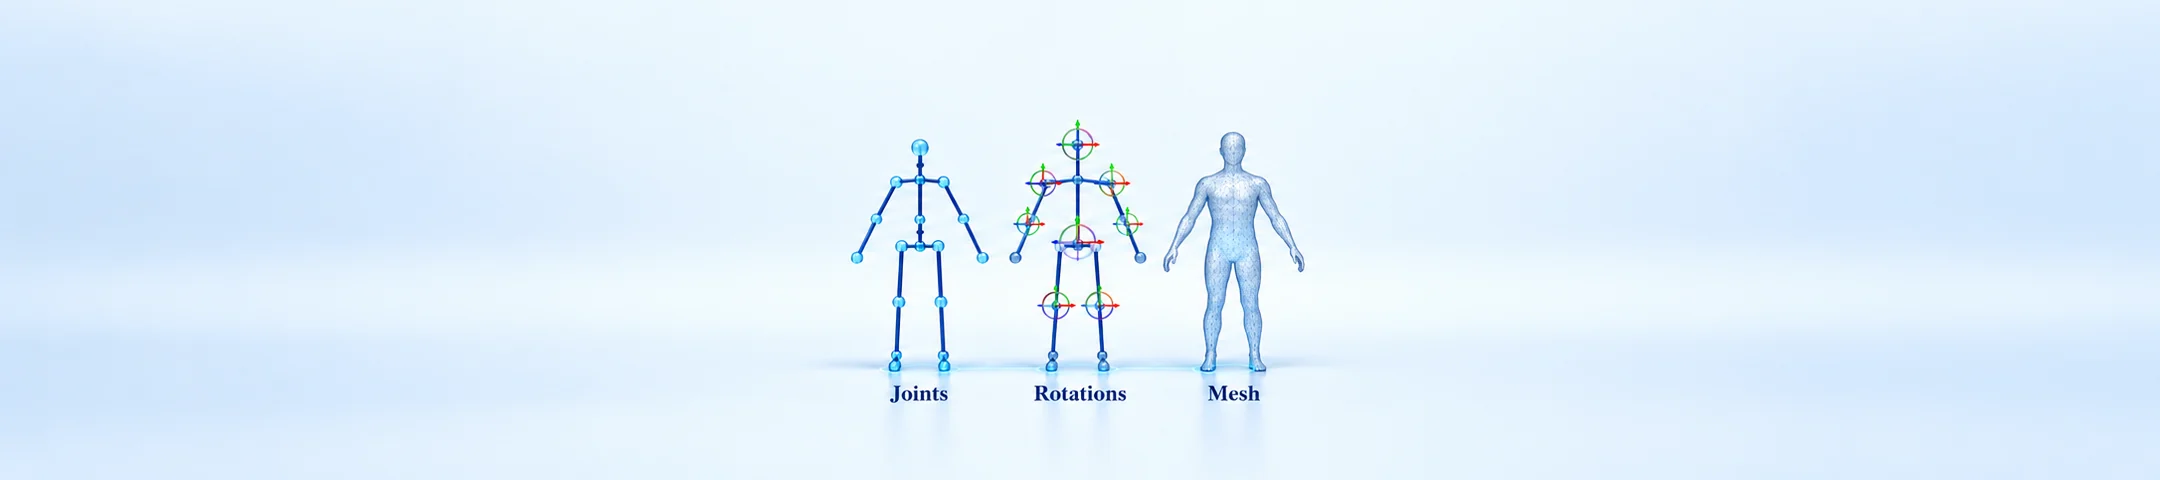
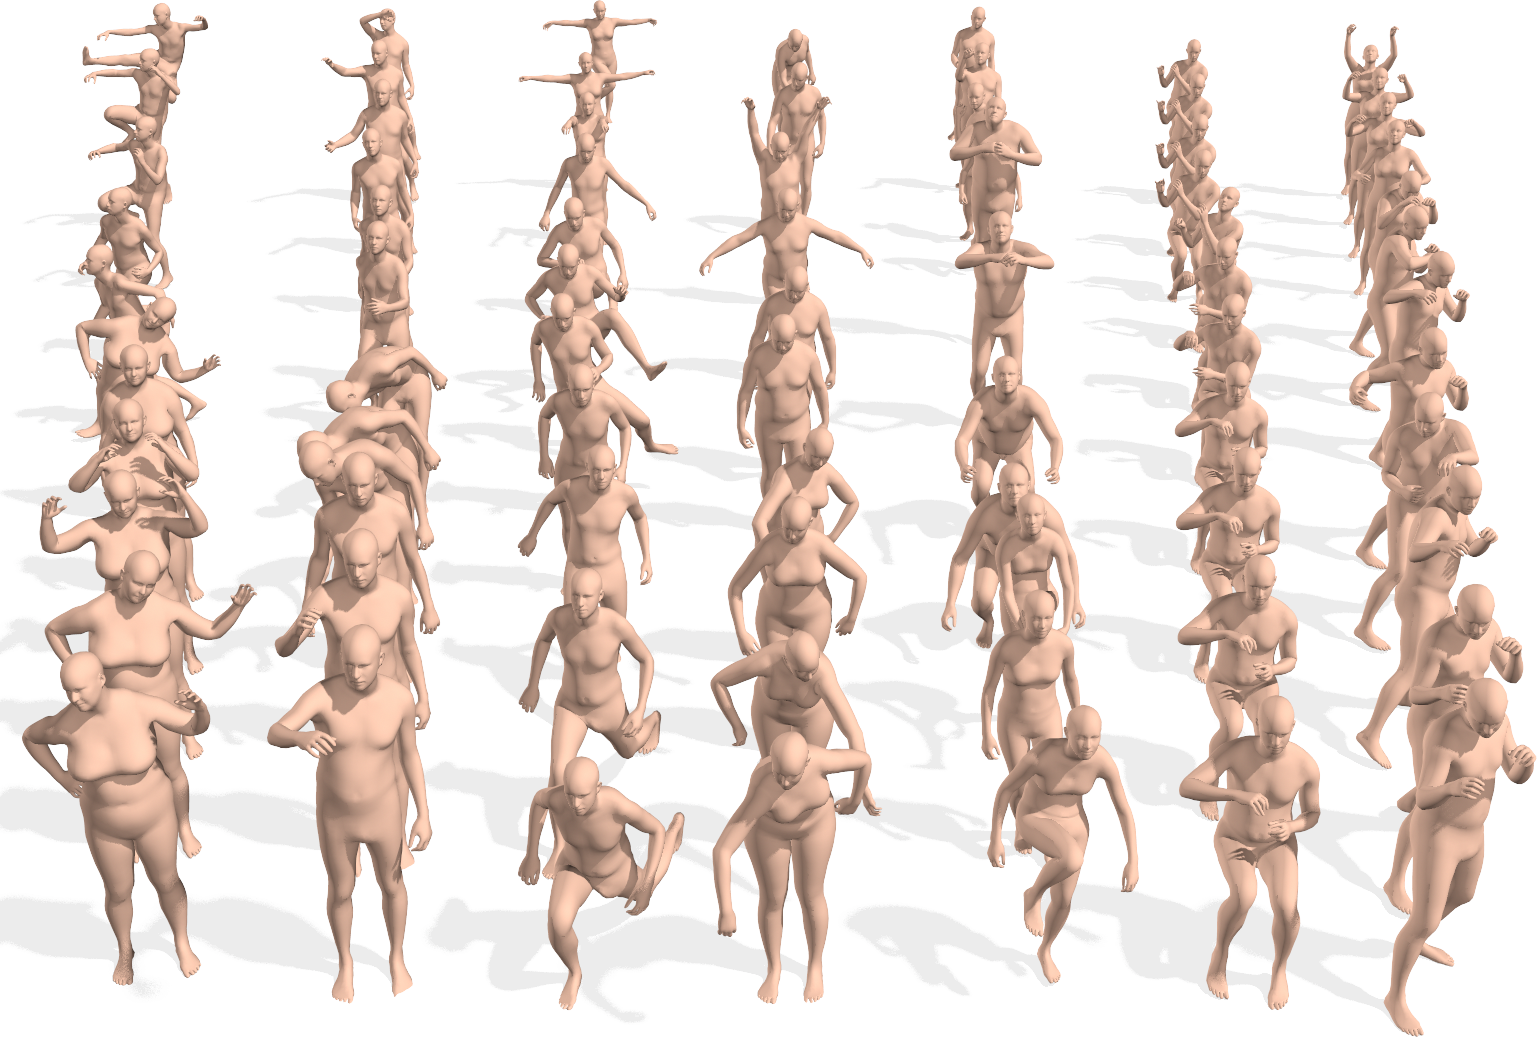
除了运动状态,人体模型还需要描述个体形态,因而通常分别参数化 shape(身体形状)与 pose。前者描述身高、肢体比例等个体差异,后者描述关节配置,根轨迹则记录整体运动;在 SMPL 等模型中,网格拓扑保持固定。参数能够分开存储,并不意味着它们对运动结果彼此独立:同一组关节角作用于不同骨长的身体,手脚的空间位置就会改变。跨角色迁移因此需要 motion retargeting(运动重定向),根据目标骨架重新组织姿态,并用 inverse kinematics(IK,逆运动学)等方法调整需要保留的接触位置。
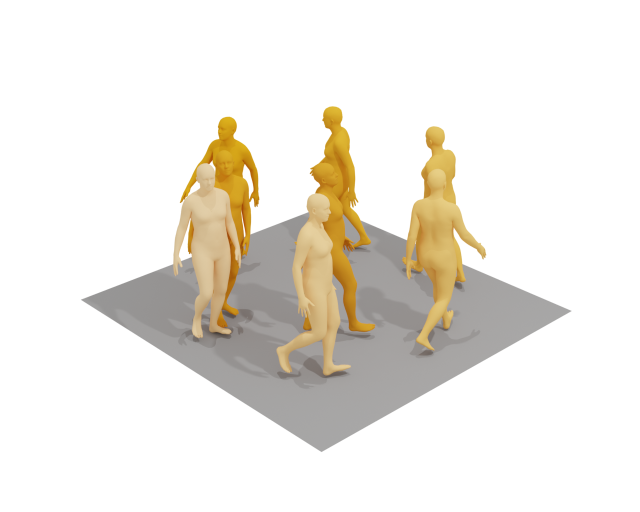
把不同时刻的人体网格放在同一世界坐标系中,可以同时观察姿态与整体路径。下图的环形行走中,根位置和朝向沿路径变化,四肢则交替完成步态周期。每个网格对应一个采样时刻;这些关键帧呈现运动的主要阶段,连续播放还需要它们之间的全部姿态与接触变化。
2. 动作数据的采集与整理
运动数据来自对真实身体的离散测量。不同采集系统能够直接观测的量不同,也会产生不同的遮挡、噪声和标定误差:相机测量投影或标记点位置,惯性传感器测量角速度与加速度,稀疏追踪设备则只记录少量身体部位。将这些测量转换成统一运动数据,需要明确哪些状态由传感器提供,哪些状态依赖人体模型和时序先验估计。
2.1 光学动作捕捉
Optical motion capture(光学动作捕捉)使用经过标定的多相机系统追踪身体表面的反光标记点,再通过三角测量恢复其三维轨迹。多视角能够减轻单视角的深度歧义,但仍可能出现身体遮挡、标记点身份混淆,以及皮肤相对于骨骼移动造成的误差。原始轨迹通常需要补点、去噪和身份校正,再通过骨架或人体表面模型拟合,转换为可用于动画和训练的动作参数。
高质量动作数据的成本不仅来自设备与场地,也来自演员组织、标定和后期校正。人—物或多人接触会增加遮挡,连续追踪同一个标记点以及标注接触阶段都更加困难。因此,录制时间并不直接等于有效训练数据量:可用片段还需要满足轨迹完整性、参数一致性和标注质量等要求。
2.2 惯性与稀疏追踪
Inertial measurement unit(IMU,惯性测量单元)测量局部角速度与加速度,部分设备还测量磁场;系统结合传感器融合和人体运动链估计身体朝向与姿态。这类设备不依赖固定相机的视野,但传感器偏差在积分过程中会累积,缺少外部位置参照时尤其难以稳定恢复整体平移。除积分误差外,安装方向、标定和磁场干扰也会影响估计结果。身体上的少量 IMU 并不能直接测得手指姿态、物体状态或足底接触力。
虚拟现实中的 sparse tracking(稀疏追踪)通常只提供头显与双手控制器的 6-DoF 位姿。设观测为 $y_t=h(q_t)+\varepsilon_t$,其中 $h$ 将全身配置映射到传感器位姿,$\varepsilon_t$ 表示测量误差。相同的头手位置可以对应不同的躯干和下肢姿态,因而从这些观测恢复全身运动是不适定的 inverse problem(逆问题)。在局部线性近似下,观测 Jacobian 的零空间刻画了不会改变当前测量的配置扰动,说明哪些身体变化不能由头手观测单独确定。
时序先验与人体约束可以为相容的全身运动赋予不同概率,从而估计后验 $p(q_{0:T-1}\mid y_{0:T-1})$。例如,连续性与常见步态先验能够减少突变,却不能使未观测的腿部姿态成为确定事实。实时恢复还需要区分仅利用过去观测的 causal filtering(因果滤波)与利用前后观测的 smoothing(平滑):后者能够使用更多时序信息,但输出需要等待相应的未来观测。
2.3 视频估计与数据归档
单目视频包含丰富的真实环境与行为,但从二维投影恢复三维运动存在深度歧义,并受到遮挡与未知相机运动的影响。多人接触时,身体重叠还会增加人物关联和姿态估计的难度。视频估计得到的 pseudo-ground truth(伪真值)有助于扩展数据规模,却可能包含系统性的姿态、尺度和接触误差;这些误差也会影响以它们作为监督的生成模型。
跨来源归档通过统一的人体模型、骨架拓扑与坐标约定建立共同的几何接口,并在其上关联动作类别、时间区间或自然语言语义。例如,AMASS 统一了庞大的光学动捕运动参数,BABEL 补充了行为与时间区间标注,HumanML3D 则整理了文本配对标准与规范化骨架。数据集之间的来源重叠意味着训练和测试划分需要严格追溯原始采集序列,以避免同源切片引发数据泄漏。
3. 数字角色与机器人中的应用
统一的运动表示为数据采集、统计学习与目标系统执行建立了共同接口,但不同应用对运动质量具有不同的约束。数字角色主要涉及视觉连续性、交互响应与资产可编辑性,沉浸式交互进一步要求虚拟身体与用户观测保持一致,机器人执行则受到真实接触动力学和执行器能力的限制。因此,人体动作建模的应用目标既包含运动序列本身的几何与时序属性,也包含该序列与外部系统之间的接口相容性。
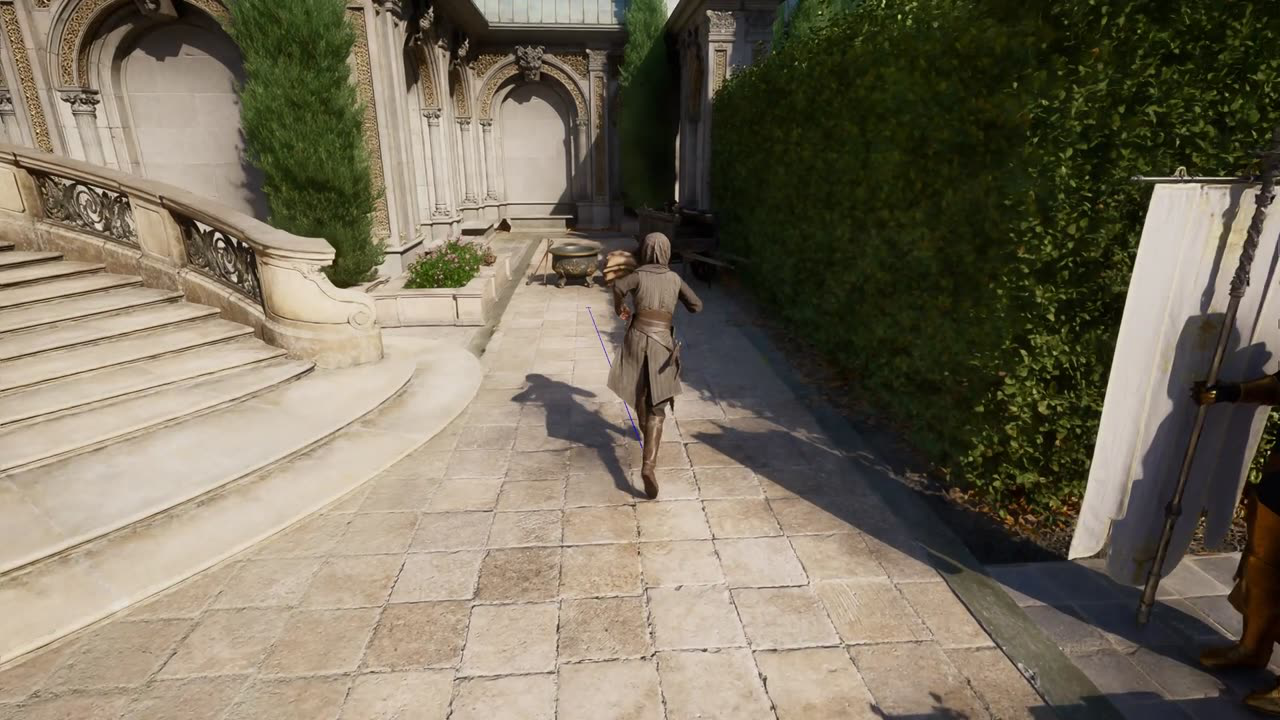
3.1 游戏:输入响应与运动连续性
交互式游戏中的角色运动由玩家输入、当前身体状态和环境约束共同决定。动画系统依据目标轨迹、历史姿态及动作上下文检索或合成后续运动,并通过姿态混合、足部接触修正和碰撞处理维持时空连续性。由于控制输入可在动作执行期间发生变化,运动规划必须持续更新;新旧轨迹在切换处的位姿与速度相容性,直接影响转向、启停及动作衔接的视觉质量。
生成模型能够扩展动作组合与条件控制的覆盖范围,其交互性能则取决于从输入采样到动画呈现的端到端延迟。具体而言,生成窗口规定参考轨迹的规划范围,计划刷新策略与播放缓冲共同决定新指令进入执行序列的时刻,root motion 接口则规定动画系统与角色移动系统对全局位移的控制权限。攻击命中、抓取闭合和足底着地等离散事件还需与游戏逻辑保持时间同步;连续姿态的平滑性与离散事件的时序正确性构成两个不同的评价维度。
3.2 影视:表演、镜头与可编辑性
影视角色动画以叙事语义与镜头表达为目标,要求运动同时传达动作意图、节奏、力度及角色特征。视线、手部构型和停顿时长等局部变量,即使只发生小幅变化,也可能改变观众对情绪或交互意图的判断。因此,制作过程通常需要在指定时间区间和身体部位施加编辑约束,例如固定接触时刻、延长过渡阶段,或在保持下肢步态的条件下调整上肢表演。
生成式方法可提供预演素材、基础运动及多样化表演候选,进入后续制作流程的动作还需保留可操作的几何与时序结构。角色绑定、关节动画曲线和接触约束使局部修改能够传播至最终形变表面;图像或视频输出则主要保留投影后的视觉结果。运动资产的可编辑性因而取决于输出表示及其与角色绑定的对应关系,并受到镜头连续性、目标角色形体和环境接触条件的共同约束。
3.3 虚拟现实:身体一致性与延迟
虚拟现实中的全身动画通常由局部追踪观测与运动先验共同确定。对于头显及手部控制器驱动的虚拟身体,观测到的末端位姿构成直接约束,躯干与下肢则需要在人体运动学可行域内推断。生成结果既应满足头手观测一致性,也应保持关节活动范围、身体协调及足底接触的合理性。传感采样、状态估计、运动补全与显示刷新共同构成反馈链路,其累计延迟会改变用户自身运动与虚拟身体响应之间的时间对应关系。
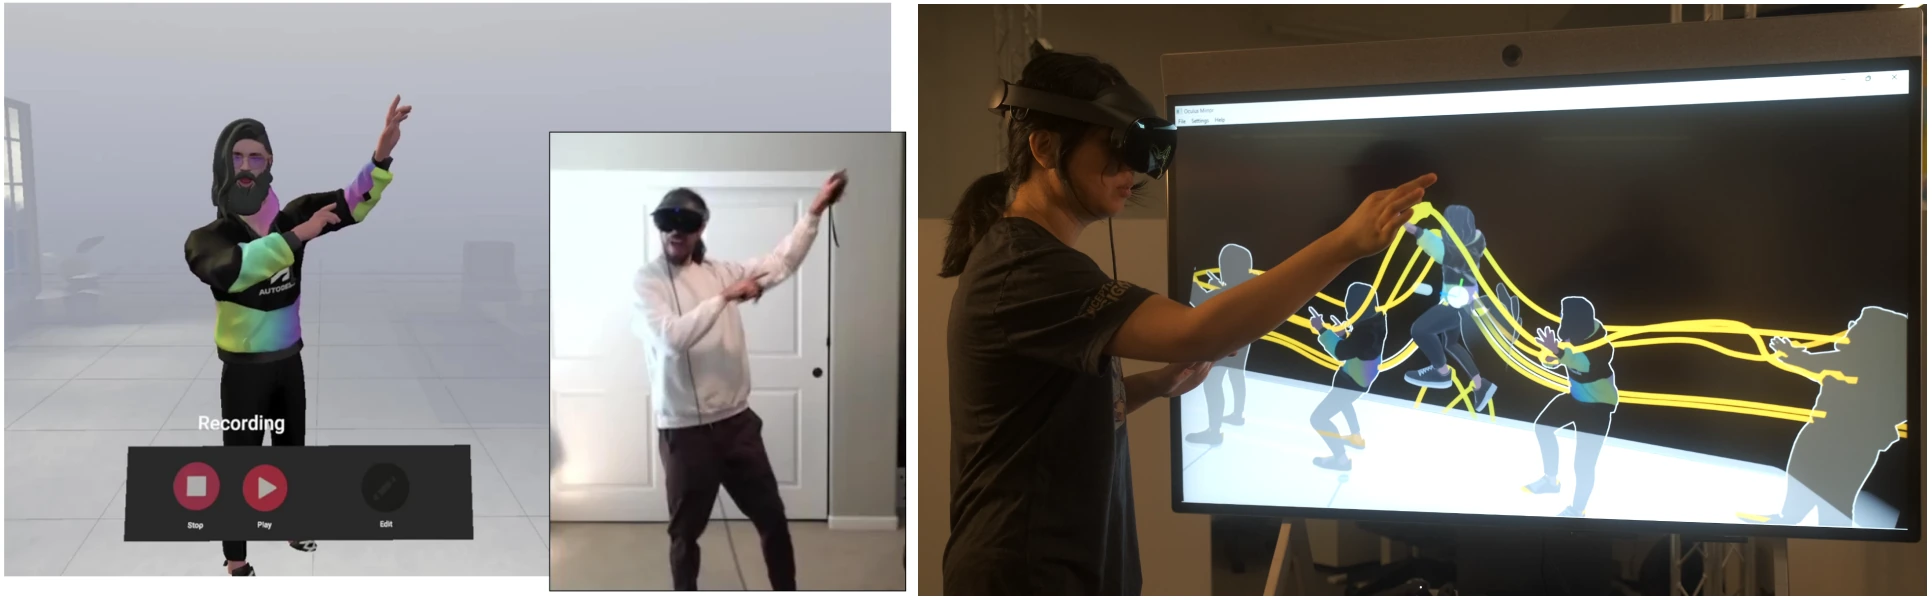
除实时身体映射外,VR 还提供了具有空间对应关系的动作创作界面。用户表演建立初始运动序列,虚拟空间中的轨迹操作和关键姿态编辑进一步施加局部控制。将此类交互结果转换为可复用动画资产,需要保留观测坐标系、角色绑定以及采样时间之间的对应关系,使空间编辑能够准确作用于目标关节和时间区间。
例如,TimeTunnel Live 将身体运动录制与空间轨迹编辑结合,体现了上述表示与交互接口之间的联系。录制阶段建立用户运动与角色姿态的对应,编辑阶段通过关键姿态及关节轨迹呈现运动的时空结构。对末端轨迹施加的局部位移约束经 IK 求解传播至相关关节,从而在保留动画时序组织的条件下调整身体构型。
3.4 机器人:参考运动与物理执行
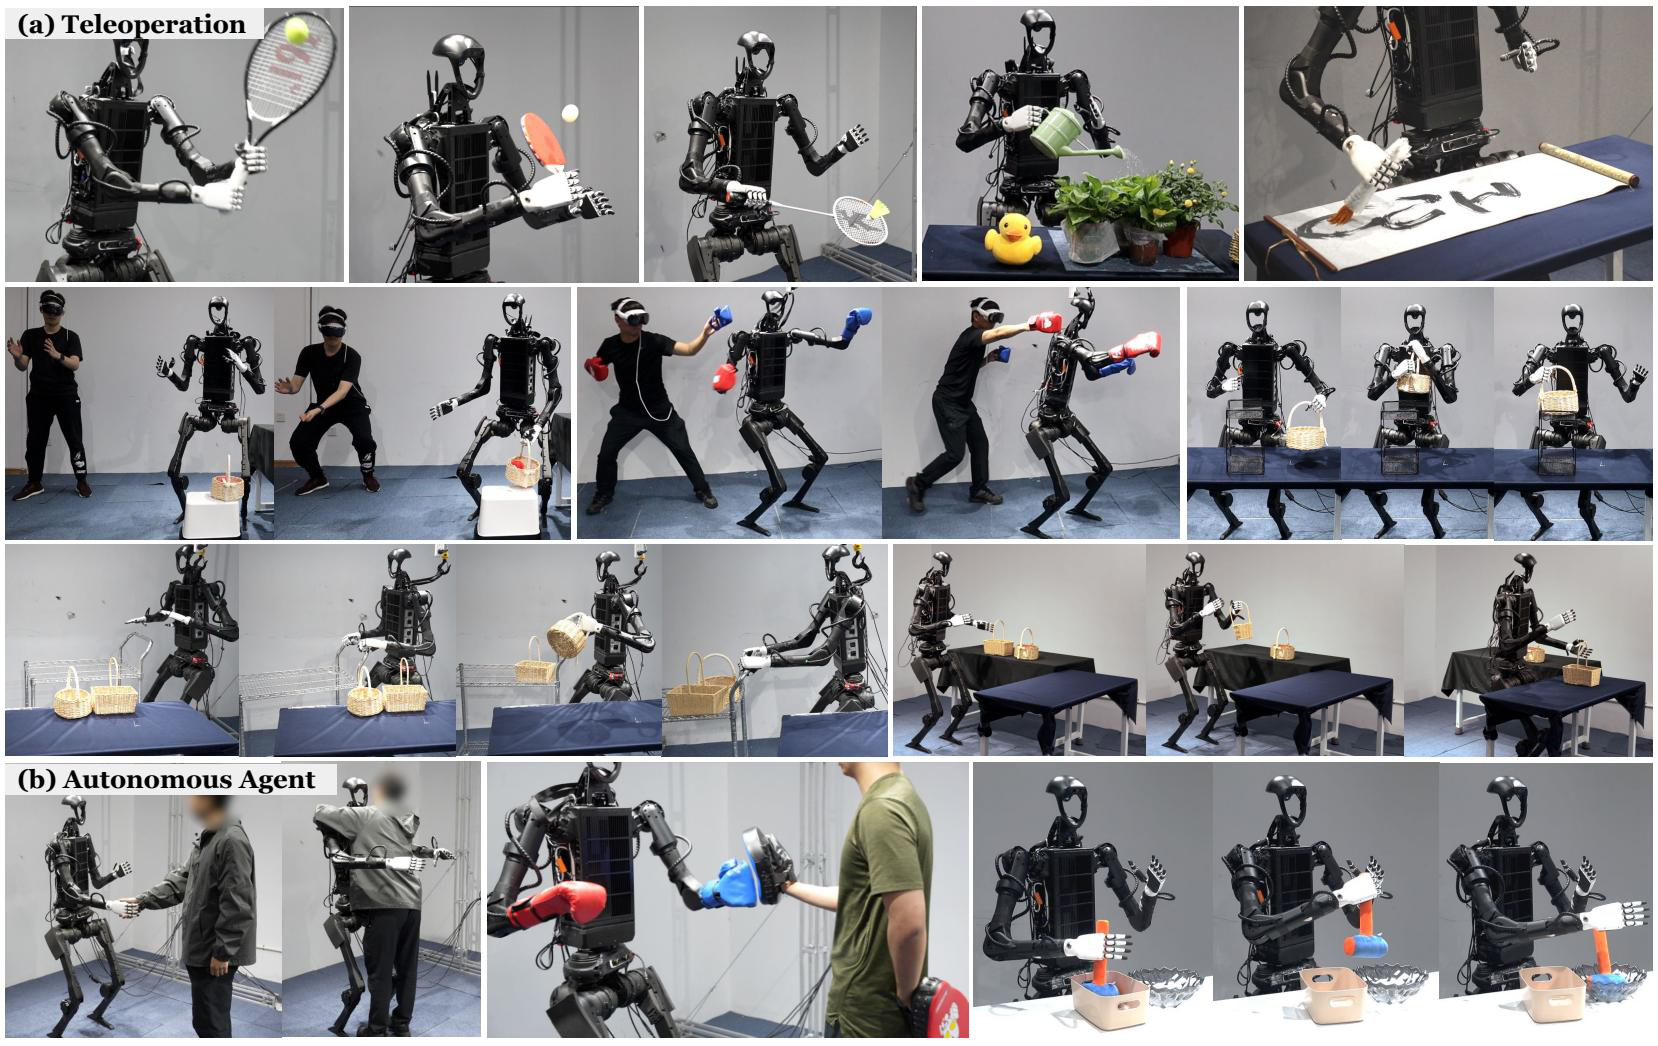
人体运动为人形机器人提供了姿态协调、接触切换和任务阶段组织的参考,但两类系统具有不同的构型空间与动力学参数。关节数量、活动范围、连杆尺度、质量分布及执行器能力的差异,使人体轨迹无法直接等同于机器人控制指令。运动重定向首先建立与目标机构相容的参考轨迹,状态反馈控制进一步根据实际位姿、速度及接触状态计算可执行的控制输入。
以搬运任务为例,高层规划确定目标对象、移动路径及接触阶段,参考运动组织躯干与四肢的协调关系,底层控制则通过接触反作用力与关节驱动力矩调节实际运动。末端可达性属于运动学约束,负载支撑与全身平衡则取决于运动方程、摩擦条件和执行器限幅。对于浮动基座系统,基座不具有独立的直接驱动,其运动由全身动力学、重力及可用接触共同决定。因此,参考轨迹的几何合理性、动力学可行性与闭环跟踪性能需要分别界定。
4. 生成、理解与动作恢复
上述应用可依据可观测输入、待求变量及优化目标进一步划分为动作生成、动作理解和动作恢复三类基本任务。这一划分描述的是推断目标与信息条件,而非互斥的网络架构;同一运动表示或生成先验可以参与多个任务,但其观测约束与评价对象有所不同。
其一,Motion generation(动作生成)在给定语义、几何或历史状态条件下估计并采样运动分布。文本指令、关键姿态、物体轨迹和场景目标对解空间施加不同程度的约束,但通常无法唯一确定全部运动自由度。例如,“向前行走”并未完全规定速度、步幅、起始支撑脚及上肢协调方式,因而对应多个相容的时序实现。条件生成的核心目标是在满足输入约束的同时刻画这种多模态性,兼顾运动质量与条件内的样本多样性。
其二,Motion understanding(动作理解)由运动观测推断动作类别、事件区间、自然语言描述或任务相关答案,建立几何时序状态与高层语义之间的映射。不同输出形式对应不同的推断结构:分类估计预定义标签,时序定位确定事件边界,motion captioning 生成语言序列,跨模态检索则依据运动与文本的匹配关系对候选集合排序。因此,检索相关性、描述准确性与事件定位精度应对应各自的任务定义。
动作语义的可辨识范围受输入信息约束。例如,单独的手臂伸展轨迹可以支持肢体方向和运动阶段的判断,却通常不足以确定交互对象的身份及具体操作目的。缺少对象状态或场景观测时,模型只能借助统计先验推断相关语义;若将此类推断表述为由观测唯一确定的事实,便会形成语义幻觉。理解任务的标注粒度和评价协议应与可用证据保持一致,区分运动中可辨识的属性与依赖外部上下文的推测。
其三,Motion reconstruction / estimation(动作恢复或估计)依据图像、视频、标记点轨迹或惯性测量推断对应的三维运动状态,属于受观测退化影响的逆问题。与条件生成侧重构造合理运动不同,恢复任务要求估计结果与特定测量过程相容,并刻画遮挡、噪声及不可观测自由度引起的不确定性。生成先验可用于正则化相容解空间,但不会消除观测映射本身的多解性。此类方法既服务于动作数据构建,也构成实时追踪、遥操作和三维人体重建的基础。
5. 预测、补全、编辑与重定向
当条件输入包含部分运动状态时,未知变量在时间轴、身体部位及特征通道上的分布进一步决定任务结构。历史片段约束未来预测,区间边界约束中间运动补全,参考序列与局部修改目标共同约束动作编辑。运动重定向则额外涉及源、目标人体结构之间的映射,要求明确哪些几何或交互属性在迁移过程中应被保留。
Motion prediction(动作预测)依据已观测历史估计未来状态分布。人体运动既受当前位姿和速度约束,也受未观测意图及后续环境交互影响,因此相同历史可以对应多个合理未来。例如,接近路口的运动片段既可能延续为直行,也可能转向或停止。在缺乏额外目标约束的条件下,预测范围延长通常伴随更大的轨迹不确定性;评价因而需要同时考虑与观测后续的对应程度、样本的物理合理性及多模态覆盖。
Motion completion(动作补全)在保留已知观测的条件下估计缺失时间区间或未观测身体部位。时间区间补全可同时利用缺口两侧的上下文,因果在线预测则仅依赖当前及此前信息,两者具有不同的条件可见范围。对于给定端点的 motion in-betweening,连接轨迹还需满足指定持续时间及边界姿态约束,并协调过渡处的速度、接触阶段和全身运动连续性。
Motion editing(动作编辑)在参考运动上施加局部几何或语义修改,同时约束非目标区域的变化。编辑区域与保持区域在张量索引上可以分离,但在人体运动学链和接触关系中仍然相互耦合。例如,上肢动作替换可将根轨迹与下肢序列作为保持目标;改变下肢运动则可能改变支撑条件,并引起躯干姿态的协调调整。局部控制的可行性因此取决于修改目标、保持约束与全身耦合关系是否相容。
Motion retargeting(运动重定向)在源、目标骨架及形体参数之间建立运动映射。局部关节旋转、世界坐标下的末端轨迹和实体间接触关系分别定义不同的保持目标,受骨长、关节拓扑及活动范围限制,这些目标未必能够同时精确满足。例如,较短的目标手臂若需到达相同物体位置,通常必须通过躯干姿态或根位置调整补偿可达范围的变化。重定向问题因而同时涉及动作特征的对应关系和目标构型空间中的约束求解。
预测、区间补全和部位编辑可以共享运动编码器与生成骨干,并通过观测 mask、条件信息及保持约束区分求解目标。具体而言,前缀观测定义未来预测,两端观测定义中间补全,固定下肢序列并求解上肢变化则定义部位编辑。跨骨架重定向还需显式提供源、目标结构及其对应关系,不能仅由时间或通道 mask 完整定义。
将上述共同结构写成条件分布,设 $\mathcal O$ 与 $\mathcal U$ 分别为已观测变量与待生成变量的索引集合,生成目标为 $p_\theta(X_{\mathcal U}\mid X_{\mathcal O},C)$。其中,索引集合可沿时间、关节或特征轴划分,附加条件 $C$ 则规定语义目标及其他约束。特征通道的固定并不必然保持对应的世界坐标位置:上游关节旋转或根位姿的变化仍会经运动学链传播至末端。保持目标需要通过坐标恢复或 forward kinematics(FK,正向运动学)映射至任务空间,以判定局部参数约束与实际几何目标之间的相容性。
6. 输入条件与参与者
在上述任务定义之外,条件信息来源与参与实体构成两个不同的描述维度。条件信息规定模型可利用的观测、目标及先验,参与实体则规定联合状态空间的组成,以及需要维护的相对位姿、时序同步和接触关系。这两个维度共同决定条件接口与运动输出的组织方式。
从条件信息的来源看,自然语言通常提供动作类别、操作目标及风格等语义条件,关键姿态规定局部或全身的几何目标,历史运动提供状态演化的时序上下文。图像和视频通过成像过程提供部分可观测证据,场景几何限定障碍物、支撑表面及可达区域,音频则提供节奏或语音相关的手势条件。多条件生成进一步要求这些信息在共同坐标系与时间基准下建立对应,例如同时满足目标椅子的位置、到达时刻及坐下过程的速度要求。
对于能够明确写出的几何与执行约束,可以定义相应的可行集合:
其中,等式约束表示指定位置或保持关系,不等式约束表示非穿透间隙、关节限位等条件。文本风格及语义偏好通常以概率条件或软目标参与优化,并不天然等价于精确的代数约束。若手腕目标超出可达范围,或接触时刻与给定根轨迹相冲突,硬约束对应的可行集合可能为空,此时需要通过优先级、约束松弛或目标调整重新定义相容的求解问题。
按参与实体划分,单人动作主要描述人体内部的关节协调与全局运动;多人动作进一步引入主体身份、相对位姿和交互阶段同步;人—物交互联合描述人体与对象状态及其接触切换;人—场景交互则依赖环境几何、目标位置和支撑关系。参与人数规定联合建模的主体数量,输入模态规定条件信息的来源,两者具有不同的含义。双人动作既可由文本驱动,也可由视频观测或一方已有运动条件化生成。
复杂任务通常同时包含多类实体关系。以物体交接为例,需要联合描述双方人体构型、对象刚体位姿、抓握关系及接触转移阶段,并在共同时间轴上维持实体身份与空间对应。其任务正确性既取决于各实体轨迹的合理性,也取决于相对运动和阶段顺序是否相容。因此,联合交互评价需要覆盖主体运动、对象状态及跨实体关系,单一姿态或轨迹指标仅能反映其中的部分属性。
7. 运动数据的时间含义
多实体同步、事件定位及运动预测均依赖明确的物理时间尺度。姿态数组中的索引首先定义离散样本的排列顺序,采样时刻才建立该顺序与持续时间、速度和接触阶段之间的对应。因此,帧数与采样频率共同构成运动数据的时间描述,二者不能相互替代。
三维动作记为 $X=(x_0,\ldots,x_{T-1})$,其中 $T$ 为采样帧数,物理帧索引为 $t\in\{0,\ldots,T-1\}$。在均匀采样条件下,采样步长 $\Delta t=1/f$ 将第 $t$ 帧关联到物理时刻 $t\Delta t$。若每帧显示一个采样周期,包括末帧的保持区间,播放时长为 $T\Delta t$;首末采样点之间的时间跨度则为 $(T-1)\Delta t$。这一区别规定了序列端点的时间含义,并直接影响事件标注及数值差分的定义。
以“向前行走并左转”的生成为例,MotionLCM 输出的序列包含 100 帧,每帧记录 22 个关节的三维坐标。在 20 fps 的播放约定下,完整显示时长为 5 秒,而首末样本之间的跨度为 4.95 秒。根关节在地面平面上的投影描述全局移动路径,右手腕的竖直坐标则描述特定末端的高度变化。对同一序列提取这两类观测,可以分别呈现空间轨迹与时间变化,而不改变其共享的采样基准。
1 | from pathlib import Path |
运行结果:
1 | frames=100, fps=20, playback=5.00s |
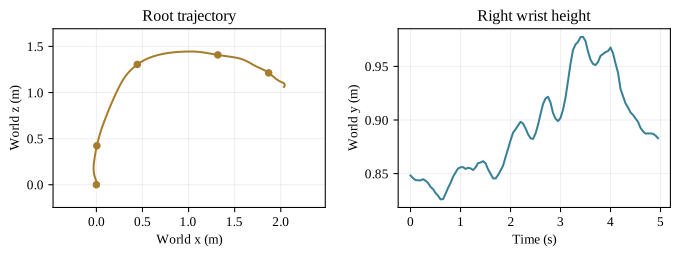
两条曲线分别对应高维运动状态在不同观测空间中的投影。根的水平投影保留整体路径,手腕高度保留竖直方向的局部变化,但二者均丢失了其余关节构型及部分空间信息,因此不能单独确定完整运动。采样频率进一步决定这些离散变化对应的物理速率:将相同的 100 帧按 30 fps 播放,会将显示时长缩短为约 3.33 秒,而非增加动作的时间细节。
对于关于连续物理时间 $u$ 足够光滑的构型轨迹,时间缩放 $\tilde q(u)=q(au)$ 在正比例因子 $a$ 下,使速度与加速度分别缩放为原轨迹在对应时刻的 $a$ 倍与 $a^2$ 倍。相应的惯性与接触载荷需求随之改变,重力项却不会按照同一比例缩放。因而,几何路径相同的两段运动可以具有不同的动力学可行性;面向物理执行的速度控制需要同时协调步幅、接触持续时间及全身姿态。
在关节坐标的基础上拟合参数化人体表面,可进一步呈现躯干朝向、肢体轮廓及足底与地面的几何关系。表面形态还取决于所采用的人体模型及拟合约束,关节观测本身并不唯一确定网格。下方交互视图与上述曲线对应同一运动序列,时间条用于对齐各帧状态;关闭整体移动时,显示变换移除根的水平位移,并保留其竖直变化及身体构型,以便对照全局路径和局部运动。
8. 技术发展的几条路线
人体运动合成的技术演进围绕运动表示、时序组织和条件约束逐步展开。动作库检索、关键帧插值与 motion graph 以已有运动资产及连接规则为基础,其可表达范围受到素材覆盖和过渡条件限制。数据驱动生成进一步通过统计学习估计条件运动分布,使姿态组合和时间变化能够以采样形式产生,而不必为每一种条件预先存储完整轨迹。由此,素材覆盖问题转化为训练分布覆盖、条件泛化及生成质量之间的联合问题。
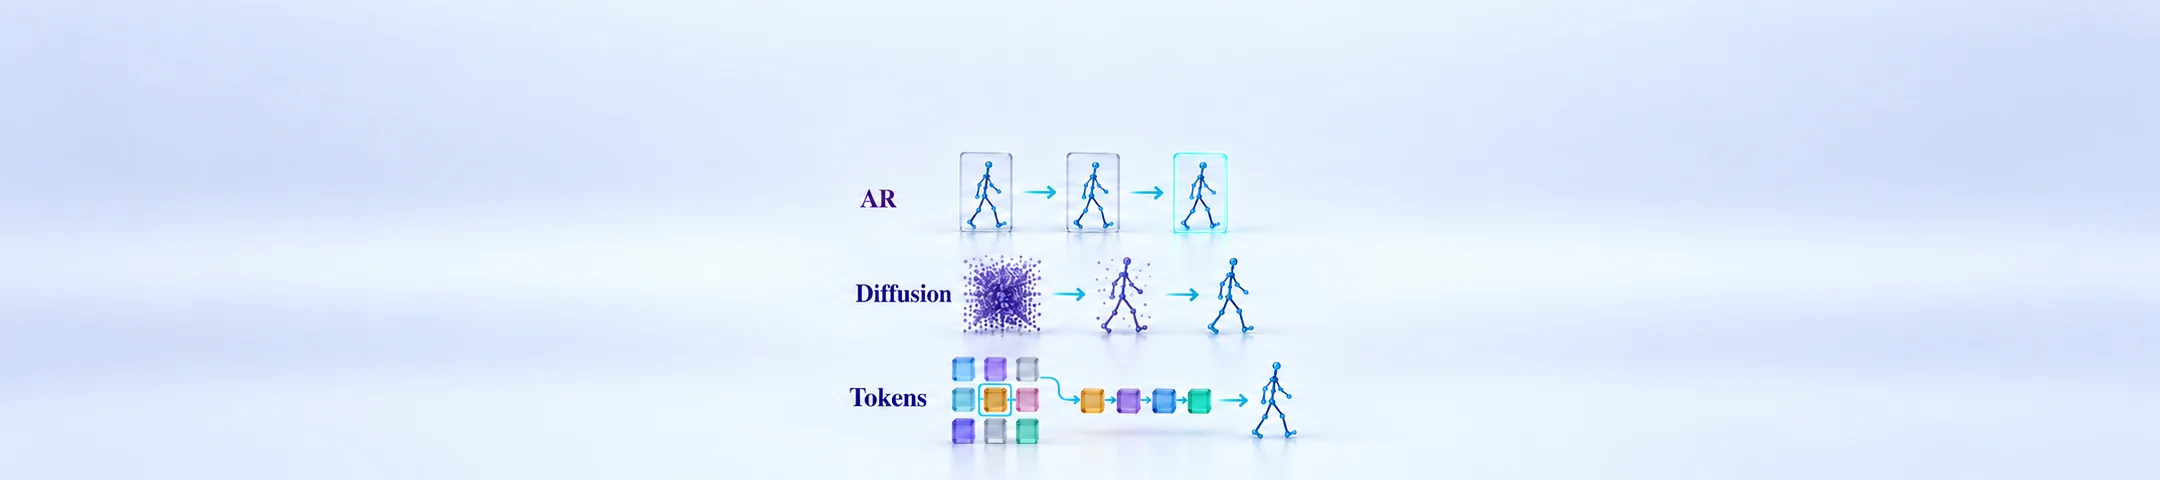
现代方法可从表示空间、概率依赖结构和分布生成机制三个相互交叉的维度分析。其一,连续潜变量表示与离散 tokenizer 规定运动信息的编码形式及压缩尺度,VAE 同时引入潜变量分布与重建目标;其二,自回归分解和 masked modeling 规定生成单元可利用的上下文及预测方式;其三,扩散与 flow matching 则通过不同的训练目标和演化过程构造连续样本。这些机制并不互斥,例如时序上采用自回归结构的模型,可以在每个动作块内部执行扩散采样。模型的具体组合决定信息传递范围、生成粒度与采样开销,并受到数据覆盖和条件约束方式的影响。
语言与运动的联合建模进一步将描述、生成、补全和编辑组织为共享表示下的条件任务。随着伙伴、物体及场景状态进入条件空间,生成目标扩展为跨实体时序关系与接触几何的联合建模;面向机器人执行时,还需满足动力学条件与执行器的能力限制。视觉上自然且运动学上连续的参考轨迹,并不必然对应可实现的接触力与驱动力矩。因此,运动生成、结构重定向和反馈控制分别承担分布建模、构型适配及物理执行等不同层次的功能。
上述模型还涉及三类含义不同的时间变量。运动帧索引 $t$ 与采样间隔 $\Delta t$ 描述人体状态沿物理时间的演化;扩散的离散步 $k$ 或 flow 的连续参数 $s\in[0,1]$ 参数化样本生成过程;实际推理耗时、高层参考刷新周期与底层控制周期则描述系统运行的时间尺度。生成过程中的一次去噪更新可以同时修改多个运动帧,其步骤数不能直接解释为动作持续时间。类似地,提高控制刷新频率改变的是状态反馈与控制输入的更新频率,而非原始运动数据的采样分辨率。严格区分这些变量,是分析生成效率、交互延迟和运动执行性能的基础。
9. 章节联系与符号
后续内容按照几何表示、概率建模与任务约束之间的依赖关系展开。运动表示建立关节坐标、旋转、运动学链及参数化人体网格的共同基础;建模范式据此讨论时空张量组织、概率目标和网络中的信息传递;单人动作生成进一步分析文本条件如何作用于运动分布,以及模型输出如何恢复为可解释的几何状态。
在上述基础上,控制与编辑研究局部条件和保持约束的相容性,奖励优化与偏好学习引入超出重建目标的质量信号,动作理解研究几何时序状态到语义的映射,统一建模则讨论理解与生成任务的表示共享。多人、人—物及人—场景交互逐步扩展联合状态空间与接触关系,机器人运动控制进一步将参考轨迹与闭环物理执行联系起来。最后一章围绕数据覆盖、评价有效性、实时反馈和应用约束,分析这些技术环节之间的系统性依赖。
- 003D 人体动作概述
- 013D 人体运动表示
- 023D 人体运动建模范式
- 03文本驱动的单人动作生成
- 04动作生成的细粒度控制与编辑
- 05动作生成的奖励优化与偏好学习
- 063D 人体动作理解
- 07动作理解与生成的统一建模
- 08文本驱动的多人交互动作生成
- 09人体与物体的交互动作
- 10人体与场景的交互动作
- 11人体动作与机器人运动控制
- 12人体动作建模的现实约束与研究方向
动作序列通常组织为形状 [T,J,3] 的关节坐标张量,或形状 [B,T,D] 的批量特征张量。其中,$T$ 为时间轴上的帧数,$J$ 为关节数,$D$ 为每帧特征维度,$B$ 为批量大小;变长序列经填充对齐形成 batch 时,时间轴容量包含填充帧,各样本的有效帧范围由 mask 区分。几何推导使用列向量,局部到世界的刚体变换写作 $p^{w}=Rp^{l}+r$,其中 $R$ 为旋转矩阵,$r$ 为平移向量。张量存储顺序与几何坐标约定分别定义,不能由数组形状推断旋转方向或坐标系含义。
运动特征的物理量纲同样取决于其具体定义。平移差分只有结合空间尺度与采样间隔,才能转换为具有长度每时间单位的速度;角变化则对应不同的量纲与坐标约定。数据集中名为 velocity 的通道可能记录帧间增量或归一化特征,解释此类数值时需要同时明确坐标系、时间步长、单位及预处理变换。
参考资料
Wentao Zhu, Xiaoxuan Ma, Dongwoo Ro, Hai Ci, Jinlu Zhang, Jiaxin Shi, Feng Gao, Qi Tian, and Yizhou Wang. Human Motion Generation: A Survey. arXiv preprint arXiv:2307.10894, 2023.
Kewei Sui, Anindita Ghosh, Inwoo Hwang, Bing Zhou, Jian Wang, and Chuan Guo. A Survey on Human Interaction Motion Generation. International Journal of Computer Vision, 2026.
Naureen Mahmood, Nima Ghorbani, Nikolaus F. Troje, Gerard Pons-Moll, and Michael J. Black. AMASS: Archive of Motion Capture as Surface Shapes. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 5442–5451, 2019.
Tairan He, Zhengyi Luo, Xialin He, Wenli Xiao, Chong Zhang, Weinan Zhang, Kris M. Kitani, Changliu Liu, and Guanya Shi. OmniH2O: Universal and Dexterous Human-to-Humanoid Whole-Body Teleoperation and Learning. In Proceedings of the 8th Conference on Robot Learning, volume 270 of Proceedings of Machine Learning Research, pages 1516–1540, 2025.
Wenxun Dai, Ling-Hao Chen, Jingbo Wang, Jinpeng Liu, Bo Dai, and Yansong Tang. MotionLCM: Real-Time Controllable Motion Generation via Latent Consistency Model. In Computer Vision – ECCV 2024, pages 390–408, Springer, 2025.
Matthew Loper, Naureen Mahmood, Javier Romero, Gerard Pons-Moll, and Michael J. Black. SMPL: A Skinned Multi-Person Linear Model. ACM Transactions on Graphics, 34(6):248:1–248:16, 2015.
Epic Games. Motion Matching in Unreal Engine. Unreal Engine 5.6 documentation; accessed October 5, 2026.
Tingwu Wang, Olivier Dionne, Michael De Ruyter, David Minor, Davis Rempe, Kaifeng Zhao, Mathis Petrovich, Ye Yuan, Chenran Li, Zhengyi Luo, Brian Robison, Xavier Blackwell, Bernardo Antoniazzi, Xue Bin Peng, Yuke Zhu, and Simon Yuen. MotionBricks: Scalable Real-Time Motions with Modular Latent Generative Model and Smart Primitives. ACM Transactions on Graphics, 45(4), Article 85, 2026.
Qian Zhou, Aniruddha Prithul, Hans Kellner, Brian Pene, David Ledo, Sebastian Herrera, Hilmar Koch, George Fitzmaurice, and Fraser Anderson. TimeTunnel Live: Recording and Editing Character Motion in Virtual Reality. In Extended Abstracts of the CHI Conference on Human Factors in Computing Systems, 2024.
ACM SIGGRAPH. Mastering Motion Magic in VR. ACM SIGGRAPH Blog, 2024.
Kaifeng Zhao, Mathis Petrovich, Haotian Zhang, Tingwu Wang, Siyu Tang, and Davis Rempe. ARDY: Autoregressive Diffusion with Hybrid Representation for Interactive Human Motion Generation. ACM Transactions on Graphics, 45(4), Article 86, 2026.
Resources and figure credits
- Numerical example; generated walking sequence.
- AMASS project: surface-shape illustration.
- MotionBricks project: animation preview frame.
- OmniH2O paper: Figure 1, teleoperation and autonomous-policy demonstrations.
- TimeTunnel Live paper: Figure 2, recording and editing interfaces.
- MotionLCM project; implementation and rendering: circular-walking sequence and generation model.
- Interactive body surfaces use SMPL-Body by the Max Planck Institute for Intelligent Systems, under CC BY 4.0; adaptations include motion fitting, coordinate alignment and browser rendering. SMPL-Body license.