Transformer-绪论
文字、声音和图像承载着人们交流与认识世界所需的信息。自计算机问世以来,让计算机处理这些信息,并完成识别、理解与生成任务,是人工智能长期研究的课题。例如,视频下方的自动字幕需要把连续的声音转换为文字;机器翻译需要在不同语言之间保留语义;图像描述需要把视觉内容组织成句子;人脸识别需要比较输入人脸与数据库中已登记身份的特征。这些任务的输入形式不同,却都需要根据上下文建立信息之间的联系。例如,翻译一个词时必须确定它在当前句子中的含义;识别语音时则需要结合相邻声学片段判断词语。因而,模型既要表示局部输入,也要建立跨位置的信息传递机制。
2017 年,Ashish Vaswani 等人提出 Transformer,以注意力替代序列内部的循环递推和卷积运算。此前,循环网络必须按位置依次计算隐藏状态;Transformer 则在训练时通过矩阵运算并行计算各位置的上下文表示。这一改变首先在机器翻译中得到验证,随后被用于 Large Language Model(大规模语言模型,LLM)、Automatic Speech Recognition(自动语音识别,ASR)和视觉建模。本系列从神经网络、条件概率与文本表示出发,逐步说明这些组件如何组合成一个可训练、可生成的序列模型。
1. 序列建模
1.1 序列数据与任务
序列 (Sequence),泛指按顺序排列的一组元素。例如,一段文本 (text) 可以看作由单个字符 (character),或者词元 (token) 组成的序列,语音 (audio) 可以看作是单帧音频信号在时间上的序列,股票行情 (K 线) 和传感器读数,也是在时间维度上的序列。按照输入与输出的形态划分,常见的序列任务可以分为以下四类:
| 任务形态 | 输入 → 输出 | 典型任务 |
|---|---|---|
| 序列分类 | 一个序列 → 一个类别 | 情感分析、垃圾邮件识别 |
| 序列标注 | 一个序列 → 等长的标签序列 | 命名实体识别、词性标注 |
| 序列到序列 | 一个序列 → 另一个变长序列 | 机器翻译、文本摘要、语音识别 |
| 语言建模 | 已有前缀序列 → 下一个元素的分布 | 文本续写、输入法联想 |
原始 Transformer 针对的是序列到序列 (Sequence to Sequence) 任务(即前文提到的机器翻译);其编码器部分可以单独用于分类与标注,解码器部分可以单独用于语言建模。
1.2 序列的属性与任务难点
序列的固有属性,给上述序列任务带来了一定的困难。具体而言,有以下三个序列任务都会面临的问题:
1. 序列长度可变。 以机器翻译任务为例:由于输入句子的长短不一,所以翻译前后的长度也不同。模型不能依赖固定的输入维度,并且由于不同语言的表达语序的不同,也不能假设输出与输入逐位置对应。
2. 序列的含义依赖上下文。 同一个词在不同语境中可以表达不同含义,例如:“苹果发布了新手机”和“把苹果削皮”中的“苹果”就表达了完全不一样的意思,前者代表美国的科技公司,而后者代表水果。因此,模型需要为同一个 token 在不同句子中产生不同的表示,这要求每个位置的 token 能够读取其他位置的上下文信息来理解这个 token 的实际含义。并且,随着上下文输入的信息越多,相关信息可能相距就越远。
3. 序列的顺序影响含义。 “狗咬人”与“人咬狗”,“我喜欢你”与“你喜欢我”,虽然包含相同的字,但是含义却不同。如果只统计序列中出现了哪些字符或者词语(即词袋表示),就不可避免会丢失序列中的信息。因此,对于序列级任务,模型的运算必须能够感知并利用元素之间的先后关系,要具备能够区分出不同意思的能力。
针对这些要求,需要分别设计序列的概率模型、跨位置的信息聚合方式和顺序表示方式。第 02、05 章用概率分解与 autoregressive generation 处理变长输出;第 06–08 章介绍如何用注意力读取上下文;第 08 章进一步说明 positional encoding(位置编码) 如何使网络利用元素的先后关系。这些设计相互配合,各自解决不同的问题。
2. 语言模型的演变
在 Transformer 出现之前,研究者已经围绕上述难点提出了多种建模方案。回顾这条技术演进路线,有助于理解 Transformer 的每一处设计分别是为了解决什么问题。
2.1 n-gram 语言模型
早期的统计语言模型 (Statistical Language Model) 采用马尔可夫假设 (Markov Assumption):下一个词只依赖于它前面固定的 $n-1$ 个词。在这一假设下,条件概率可以直接通过语料中的计数来估计。以三元模型 (trigram) 为例,它用“前两个词之后出现某个词”的相对频率来估计 $p(w_t\mid w_{t-2},w_{t-1})$。
n-gram 模型简单且可解释,但存在两个根本性的限制。首先,窗口之外的信息被完全截断,模型无法利用 $n-1$ 个词以外的上下文。其次,随着 $n$ 增大,绝大多数词组合在语料中从未出现过,计数估计会变得非常稀疏,只能依靠各类平滑 (smoothing) 技巧来弥补。此外,n-gram 模型无法在相似的词之间共享统计信息,例如,“猫在睡觉”的计数并不会帮助模型估计“狗在睡觉”的概率。
2.2 循环神经网络
为了突破固定窗口的限制,循环神经网络 (Recurrent Neural Network, RNN) 用一个隐藏状态 (hidden state) 来概括已经读过的前缀,每读入一个元素就更新一次状态。RNN 在每个位置复用相同的更新规则,不要求输入具有固定长度;可用的序列长度仍受计算资源和训练数据限制。与此同时,token Embedding(将 token 编号映射为可学习向量的表示) 使含义相近的词拥有相近的向量,统计信息因此得以在词之间共享,这也弥补了 n-gram 模型的另一项缺陷。
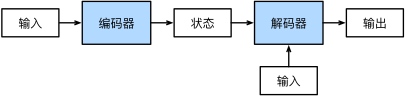
在此基础上,Sutskever 等人和 Cho 等人于 2014 年提出了基于 RNN 的编码器—解码器 (Encoder–Decoder) 结构:编码器读完整个源句后,把最后的隐藏状态作为整句的固定长度表示;解码器则以这一表示为条件,逐词生成译文。然而,这一结构存在以下两个问题:
- 固定长度表示的限制:不同长度的源句都通过同一个固定维度的状态传递给解码器。随着句子变长,模型需要在有限状态中保留更多内容,因而更难恢复完整的源端信息。
- 顺序计算:第 $t$ 步的状态依赖于第 $t-1$ 步,所以同一层内的各个位置无法并行计算;并且,序列首尾两个位置之间的信息需要经过 $O(n)$ 次状态传递才能到达。
长短期记忆网络 (Long Short-Term Memory, LSTM,1997) 和门控循环单元 (Gated Recurrent Unit, GRU,2014) 通过门控机制改善了长距离的梯度传播,但并没有改变上述两个结构性质。
以“今天/深圳/天气/很”为前缀,三元模型仅用“天气/很”预测下一词;RNN 则依次读取整个前缀,并通过隐藏状态传递信息。
2.3 注意力机制
针对固定长度上下文的限制,Bahdanau 等人在 2014 年为编码器—解码器引入了注意力机制 (Attention Mechanism)。具体而言,编码器不再只输出最后一个状态,而是保留每个源位置的状态;解码器每生成一个词,都会根据当前状态计算对各个源位置的权重,再对源状态加权求和。这样一来,解码器不再只能访问一个句末状态,而能够按当前预测需要读取不同的源位置。不过,编码器和解码器的内部仍然是循环结构,计算隐藏状态时的顺序依赖依旧存在。
Transformer 则在注意力机制的基础上更进一步:它完全去掉了循环结构,在编码器和解码器内部都使用self-attention(自注意力) 来处理位置之间的依赖关系。不同层结构的计算性质可以从三个角度比较(其中 $n$ 为序列长度,$d$ 为表示维度,$k$ 为卷积核宽度):
| 层类型 | 每层复杂度 | 顺序操作数 | 任意两位置间的最大路径长度 |
|---|---|---|---|
| self-attention | $O(n^2d)$ | $O(1)$ | $O(1)$ |
| 循环层 | $O(nd^2)$ | $O(n)$ | $O(n)$ |
| dilated convolution | $O(knd^2)$ | $O(1)$ | $O(\log_k n)$ |
表中的 dilated convolution(扩张卷积)假设 $k>1$,且各层的 dilation 随深度按 $k$ 倍增长,使感受野按几何级数扩大;普通固定核宽的局部卷积则需要约 $O(n/k)$ 层,才能连接序列首尾。
从表中可以看出,self-attention 让任意两个位置在一层之内直接交互,并且同一层的所有位置可以通过矩阵乘法并行计算,这使它非常适合在 GPU 上进行大规模训练。但与此同时,它的计算量和中间存储会随序列长度的平方增长。这一代价也成为了后续长序列优化工作的主要出发点(第 11 章)。
3. Transformer 的整体结构
3.1 文本表示
首先,文本需要被转换为神经网络能够处理的数值形式。具体而言,Tokenizer(分词器) 先将文本切分为 token,每个 token 在词表中对应一个整数编号;随后,Embedding table(嵌入参数表) 把编号映射为可学习的向量。由于 self-attention 本身对输入顺序不敏感(第 08 章),原始 Transformer 还需要为每个位置加上positional encoding。经过这一步,输入序列被表示为一个形状为 $L\times d_{\mathrm{model}}$ 的矩阵,其中 $L$ 是序列长度。
3.2 编码器与解码器
在输入表示之上,原始 Transformer 由各 6 层的编码器与解码器堆叠而成:
- 编码器层包含两个子层:multi-head self-attention(多头自注意力)与 FFN(逐位置前馈网络)。编码器读取完整的源序列,输出每个源位置的上下文表示。
- 解码器层包含三个子层:带 causal mask(因果掩码) 的 self-attention、读取编码器输出的 cross-attention(交叉注意力),以及 FFN。其中,causal mask 使每个预测位置只能读取右移输入中截至当前位置的内容,即预测标签之前的目标前缀。
此外,每个子层都包裹在残差连接 (Residual Connection) 和LayerNorm(逐位置的特征归一化) 之中。这些组件的分工十分明确:注意力负责位置之间的信息汇聚,FFN 负责每个位置内部的非线性变换,残差连接和 LayerNorm 则改善深层网络的信号传播与优化条件。最终,解码器最后一层的输出经过一个线性层和 softmax,得到目标词表上的概率分布。
以“雨停了。”的英译为例,编码器计算中文源序列的表示,解码器根据源表示和已有英文前缀生成译文。
3.3 训练与推理的计算差异
需要注意的是,Transformer 在训练和推理两个阶段的计算方式并不相同。
在训练阶段,完整的正确译文是已知的。解码器以右移一位的目标序列作为输入,并配合 causal mask,就能在一次前向计算中同时得到所有位置的预测,再用交叉熵损失更新参数(第 04、05 章)。
而在推理阶段,下一个 token 依赖于模型此前生成的 token,因此只能从开始标记出发逐步生成。由此可见,Transformer 在训练阶段消除的是逐位置执行计算的必要性;通过 causal mask 保留的概率依赖仍然存在,autoregressive generation也仍是一个顺序过程。工程上的 KV 缓存等优化正是针对这一点而设计的(第 11 章)。
4. 知识依赖
综合前文,理解 Transformer 所需的基础知识来自三个方面。首先,线性层与非线性激活构成特征变换;其次,条件概率与交叉熵定义预测方式与训练目标;最后,分词、嵌入与张量形状规定数据的表示方式。
在此基础上,序列建模又引入了 autoregressive generation 与编码器—解码器结构。其中,注意力、多头投影和 positional encoding 决定了位置之间如何交互;残差连接、LayerNorm 与前馈网络则决定了子层如何组织。这两组组件共同构成了完整的 Transformer,并最终落地为工程实现。
图中的箭头表示主要的知识依赖关系。值得注意的是,注意力与残差结构属于不同的分支,例如,理解残差连接并不需要以 multi-head attention(多头注意力) 为前提。章节编号给出了一种满足主要依赖关系的阅读顺序。
5. 符号约定
向量按行排列。$X\in\mathbb R^{L\times D}$ 表示一个包含 $L$ 个位置的序列,每个位置有 $D$ 个特征分量;批量张量的形状写作 [B,L,D],其中 $B$ 为批量大小。线性层写作 $XW+b$,其中 $W$ 的形状为“输入维度 × 输出维度”。需要注意的是,PyTorch 的 nn.Linear 按相反的方向存储权重,实际执行的是 X @ weight.T + bias。
对数默认取自然对数。代码中的索引与位置编号从 0 开始,而数学公式中的下标则按各式的定义给出。此外,token 编号只在所属的词表内有效,不同词表中的同一个整数不必表示同一个 token。
参考资料
[1] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, and Illia Polosukhin. Attention Is All You Need. Advances in Neural Information Processing Systems 30, 2017.
[2] Yoshua Bengio, Réjean Ducharme, Pascal Vincent, and Christian Jauvin. A Neural Probabilistic Language Model. Journal of Machine Learning Research 3, 1137–1155, 2003.
[3] Ilya Sutskever, Oriol Vinyals, and Quoc V. Le. Sequence to Sequence Learning with Neural Networks. Advances in Neural Information Processing Systems 27, 2014.
[4] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural Machine Translation by Jointly Learning to Align and Translate. International Conference on Learning Representations, 2015.
[5] Aston Zhang, Zachary C. Lipton, Mu Li, and Alexander J. Smola. Dive into Deep Learning. Cambridge University Press, 2023.
[6] Ian Goodfellow, Yoshua Bengio, and Aaron Courville. Deep Learning. MIT Press, 2016.
[7] John McCarthy, Marvin L. Minsky, Nathaniel Rochester, and Claude E. Shannon. A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence. Research proposal, 1955.
- Figure source: Aston Zhang, Zachary C. Lipton, Mu Li, and Alexander J. Smola, Dive into Deep Learning. encoder-decoder.svg, Original vector artwork, Reproduced without modification; Apache 2.0 license.