
CH-06 运动规划与最优控制
一台机械臂要绕过障碍,并在指定时间内放下物体。起点与终点之间有很多几何路径,每条路径又能采用不同速度;关节限位、力矩能力和制动距离会排除其中一部分运动。第 05 章的跟踪控制器需要一条参考轨迹,规划器的任务就是在这些限制下产生合适的参考。
规划可以求一段运动,也可以求不同状态下的动作规则。轨迹优化主要寻找从某个起点出发的运动,动态规划则比较不同状态下应采取的动作。下面先把任务写成代价与约束,再用小规模积分器算例核对两种求解方式,随后把这些关系用于机械臂时间缩放和在线 MPC。
1. 最优控制
搬运任务需要同时回答两个问题:运动是否可执行,以及在可执行的运动中怎样选择。动力学、力矩限幅和避障条件决定前者,任务代价决定后者;轨迹优化把它们写进同一个问题,求出供反馈控制跟踪的名义运动。
为了评价整段运动,最优控制使用一个标量代价。考虑确定性动力学 $\dot x=f(x,u,t)$,控制策略可以写为 $u=\pi(x,t)$。给定初始状态 $x(0)=x_0$ 后,策略决定状态和输入随时间怎样变化,代价函数再评价这段变化。
有限时域问题有明确的结束时刻 $T$。例如,一项装配工作需要在截止时间前完成,评价的是从现在到截止时刻的完整轨迹。常见代价具有可加结构:
$g$ 是运行代价,评价每一时刻的状态和输入;$h$ 是终端代价,评价任务结束时的位置。由于总代价由各时间段相加得到,可以把已经付出的代价与剩余代价分开。这是后面递归求解的基础。
代价函数表达任务对运动的偏好。若状态是位置与速度,可以用位置误差惩罚偏离目标,用输入平方惩罚较大的驱动命令;若任务强调时间,可以把运行代价设为常数一,并让结束时刻成为变量。输入平方小的运动通常愿意花更长时间,最短时间运动则可能长期处于输入限幅。因此,比较轨迹之前要先确定时间是否固定,以及终点是否必须精确达到。
权重的意义还取决于量纲和尺度。位置误差平方的单位是平方米,力矩平方的单位是牛顿米的平方;直接相加时,权重已经包含了单位换算与尺度选择。可以先用允许位置误差和额定力矩归一化,再给无量纲误差设置权重。
终点要求决定了终端代价与终端约束的用途。有限的终端惩罚鼓励到达,通常仍允许留下误差;若必须恰好停在目标,就需要终端等式。后面的两步算例会展示这种区别。
1.1 动力学约束
电机只能输出有限力矩,机器人也不能穿过障碍物。无论机械系统是全驱动还是欠驱动、$f$ 是线性还是非线性,这些限制都可以写成
平滑的位置曲线还需要动力学检验:必须存在合法输入,才能让机器人沿着它运动。因此,最优控制同时寻找状态轨迹和输入轨迹,在满足动力学与约束的条件下降低代价。用惩罚项表达偏好与要求约束成立,是两种不同的建模选择。
对机械臂,状态通常至少包含 $x=(q,\dot q)$,输入是力矩或底层执行器接受的其他命令;第 04 章的运动方程可以转成这里的一阶动力学。关节限位约束状态,驱动力矩限幅约束输入,避障则需要检查当前构型下的整个机构。
任务要求本身也需要可行性检查。有限驱动力可能无法让机器人在很短时间内跨越很长距离,此时问题不存在解。诊断这类失败时,要先区分任务不可行与求解器精度不足。
允许使用松弛变量时,必须明确哪些条件可被放宽。可以允许目标位置出现小偏差,并为松弛量设置代价;物理非穿透和执行器硬限幅通常需要另行处理。即使每个离散节点都避开障碍,节点之间的插值仍可能发生碰撞,因此约束检查还涉及轨迹连续区间和几何检查精度。
1.2 二次规划
先暂时把整段运动的决策变量汇总为向量 $z$。正定二次目标与线性约束组成的问题为
其中 $Q$ 正定,$A,E$ 为约束矩阵。这样的目标是严格凸的,可行集合也是凸的。引入不等式乘子 $\mu$ 和等式乘子 $\nu$,Lagrange 函数为
不等式乘子满足 $\mu\geq0$,等式乘子没有符号限制。原因是等式可以表示为方向相反的一对不等式,它们各有一个非负乘子,两者之差则可以是任意实数。
1.3 KKT 条件
对上述具有最优解的正定二次规划,原变量和乘子满足下列关系时,构成原问题与对偶问题的最优解:
第一行要求原问题可行;第二行包含对偶可行性和 Lagrange 函数的驻点条件;最后一行是互补松弛。若某条约束尚有余量,相应乘子必须为零;若乘子严格为正,相应约束必须恰好取等号。这组关系通常称为 Karush–Kuhn–Tucker 条件。
KKT 条件的保证取决于问题结构。对更一般的凸目标和凸不等式约束,强对偶还需要适当条件,例如存在严格满足不等式的可行点。这里的二次规划具有正定目标与线性约束;后面加入非线性动力学等式时,轨迹优化可能成为非凸问题,满足局部条件也就未必给出全局最优解。
用一次两步搬运来核对这些条件。把位置和控制量归一化,考虑 $x_{k+1}=x_k+u_k$,$x_0=4$,执行两步,且 $|u_k|\leq1$。目标为
消去状态后,$x_2=4+u_0+u_1$。无约束驻点满足 $u_0+x_2=u_1+x_2=0$,因此 $u_0=u_1=-4/3$、$x_2=4/3$、$J=8/3$;代价虽小,输入却不合法。加上限幅后,候选解是两个输入均为 $-1$,状态依次为 $4,3,2$,代价为 $3$。由于终点只被惩罚而非固定为零,残留位置并不违反问题定义;两步内最多移动两个单位,本来也无法到达原点。
把下界写成 $-u_i\leq1$,最优点的目标梯度为 $(1,1)$,取下界乘子 $(1,1)$、上界乘子为零,即满足驻点、非负性与互补松弛。正定 Hessian 保证这个可行点是全局最优解。
乘子还反映约束对性能的影响:单独把一个活动下界放宽一个很小的量,最优代价的一阶下降率为一。这个敏感度可以帮助识别主导性能的物理限制;执行计划仍须遵守实际额定输入。
2. 动态规划
如果机器人在途中偏离了计划,接下来的动作需要根据新状态重新选择。动态规划用剩余代价函数评价这些后续选择。
离散时间动力学写为 $x_{k+1}=F(x_k,u_k,k)$。有限时域的策略代价是
$J_\pi(x,m)$ 表示从时刻 $m$、状态 $x$ 出发,继续使用策略 $\pi$ 所产生的未来代价。对所有策略取最小值,得到最优剩余代价函数 $J^*$。终点之后没有进一步代价,因此先令
然后从后向前递推:
括号内的第一项是现在付出的代价,第二项是执行这个动作到达下一状态后,能够取得的最小未来代价。最小化它的输入,就是这个状态和时刻对应的最优动作。未来所有决策因此被压缩为一个标量函数,而不必枚举完整的动作序列。
计算顺序从终点向前推进:先给定最后时刻的代价,再计算倒数第二个时刻,逐步解决更早的决策。每个时刻都对可能的状态求动作,因此结果是一套状态反馈规则。机器人偏离原计划后,可以查找新状态对应的动作。
Bellman 分解成立的关键是状态包含决定未来所需的信息,且总代价能按时间相加。若电池温度影响后续力矩限幅,却没有进入状态,两次具有相同关节位置和速度的运动便可能拥有不同未来;仅以这些变量定义的剩余代价就不再充分。历史相关任务也可以扩充状态,例如加入剩余电量、已经完成的工序或上一时刻输入,使约束和代价重新具有所需的递推结构。
对上面的两步算例,最后一步先求 $\min_{|u|\leq1}\tfrac12u^2+\tfrac12(x+u)^2$。无约束解为 $u=-x/2$,若超限则取相应边界。所得一步剩余代价为
再把 $\tfrac12u_0^2+V_1(x_0+u_0)$ 最小化,两步首个动作在 $|x_0|\leq3$ 时为 $-x_0/3$,超出这个范围时取相应限幅。对 $x_0=4$,第一步取 $-1$,到达 $3$ 后最后一步仍取 $-1$,与 KKT 算例一致。这里的限幅结果来自求解这个特定凸标量问题;任意多关节系统直接把无约束 LQR 输入截断,一般不能得到受约束问题的最优策略。
2.1 离散化与 HJB 方程
当状态和动作都只有有限个取值时,可以在终端初始化后逐层回推。对连续系统,可以先把状态与动作离散化再使用相同思想。但所得解首先是离散模型的最优解;网格会引入近似,维数增加也会迅速扩大需要处理的状态数量。
连续时间中,可微的最优代价满足 Hamilton–Jacobi–Bellman 方程:
这个形式来自把很短时间内的当前代价与下一时刻的未来代价相加,再取极限。它也可用于验证猜测的代价函数和策略,但要求适当的可微性;并非所有最优控制问题的代价函数都处处光滑。
展开这个极限,可以把当前状态经过短时间 $dt$ 后的位置写为 $x+f(x,u,t)dt$。未来代价的一阶变化包含 $J_xf\,dt$ 和 $J_tdt$;加上这段时间的运行代价 $g\,dt$,再与当前代价相减并除以 $dt$,便得到方程中的三项。最小化仍对当前输入进行,未来策略的效果则已经包含在 $J$ 中。
状态维数决定了网格法的计算规模。若每个状态分量取一百个网格点,二维状态需要一万个点,六维状态就需要一万亿个点;每个点还要比较动作,并插值下一状态的价值。轨迹优化只在时间上参数化一条运动,计算更集中,但结果也只针对一个起点及其附近。两种方法的计算代价与求解对象相互对应:前者近似全域的反馈规则,后者首先提供一条可执行的名义轨迹。
2.2 线性二次问题
在线性动力学 $\dot x=Ax+Bu$ 下,令运行代价为 $x^TQx+u^TRu$,终端代价为 $x^TQ_fx$,其中 $Q,Q_f$ 半正定、$R$ 正定。猜测最优代价具有二次形式 $J^*=x^TS(t)x$,代入 HJB 方程后,关于输入的极小值可以直接求出:$u^*=-R^{-1}B^TSx$。
剩余状态二次项给出矩阵 Riccati 方程,并由终端条件 $S(T)=Q_f$ 决定解。这一算例说明,剩余代价函数并不总要存成一个庞大的网格;合适的模型和代价结构可以把整个函数压缩为一个随时间变化的矩阵。一般非线性问题缺少这种结构,所以数值方法才变得必要。
3. 最短时间控制
搬运轴越快到达,留给其他工序的时间就越多。先把它简化为单位质量、无摩擦的物体 $\ddot q=u$,输入限制为 $-1\leq u\leq1$,任务是尽快到达 $q=0,\dot q=0$。加速度上限固定后,加速和制动都需要时间,控制器必须安排二者的切换。
当 $u$ 为常数,从初始位置 $q_0$ 和速度 $v_0$ 出发,轨迹是
如果物体位于 $q>0$ 并朝原点运动,最后一段需要使用 $u=+1$ 制动。令停止时的速度与位置同时为零,可得到制动曲线
另一侧由对称性得到 $\dot q=+\sqrt{-2q}$。统一表示为
相平面中,这条曲线区分了两种动作:位于曲线上方时使用 $u=-1$,位于下方时使用 $u=+1$;到达切换曲线后,使用把物体恰好停在原点的制动输入。这里说明的是该算例的切换结构与几何推导,完整的最优性证明还需要最优控制条件。
在这个模型中,最快运动使用最大加速与最大制动,并在合适时刻切换。切换时刻由位置和速度共同决定,因为相同距离下,速度更大的物体需要更早刹车。
对静止到静止、总时长为 $T$ 的运动,可以用速度曲线的面积证明时间下界。速度的大小既不能超过从起点以最大加速度积累的 $u_{\max}t$,也不能超过为在终点停下所允许的 $u_{\max}(T-t)$。速度曲线因此被一个三角形包住,面积至多为 $u_{\max}T^2/4$。移动距离 $q_0$ 要求 $T\geq2\sqrt{q_0/u_{\max}}$;先最大加速、再最大制动恰好达到这个下界,因此在这些假设下是最短时间解。
驱动器的其他限制会改变速度包络。速度上限把三角形顶部截平,使长行程出现匀速段;jerk 限制则要求加速度连续变化,轨迹需要加减加速度段。这里的 bang-bang 描述简化模型中的加速度切换,实际电机命令还须服从驱动器与机构的限制。
3.1 切换轨迹
把搬运轴简化为上面的双积分器,取加速度上限 $u_{\max}=1\,\mathrm{m/s^2}$,初始速度为零。
短行程案例 A 的初始位置为 $1\,\mathrm m$。先用 $u=-1\,\mathrm{m/s^2}$ 加速 $1\,\mathrm s$,到达 $q=0.5\,\mathrm m$、$\dot q=-1\,\mathrm{m/s}$;此时满足 $\dot q=-\sqrt{2u_{\max}q}$。再用 $u=+1\,\mathrm{m/s^2}$ 制动 $1\,\mathrm s$,在总时间 $2\,\mathrm s$ 到达原点且速度为零。
长行程案例 B 的初始位置为 $4\,\mathrm m$。加速段持续 $2\,\mathrm s$,切换状态为 $q=2\,\mathrm m$、$\dot q=-2\,\mathrm{m/s}$;制动也持续 $2\,\mathrm s$,总时间为 $4\,\mathrm s$。两条轨迹都在输入界限内完成加速和制动,恰好停在目标。
对于这类正距离、静止到静止的运动,切换时间为 $\sqrt{q_0/u_{\max}}$,总时间为 $2\sqrt{q_0/u_{\max}}$。距离增为四倍,所需时间增为两倍。该比较只针对一维无摩擦模型;额外速度限幅、障碍和多关节耦合会改变规划问题。
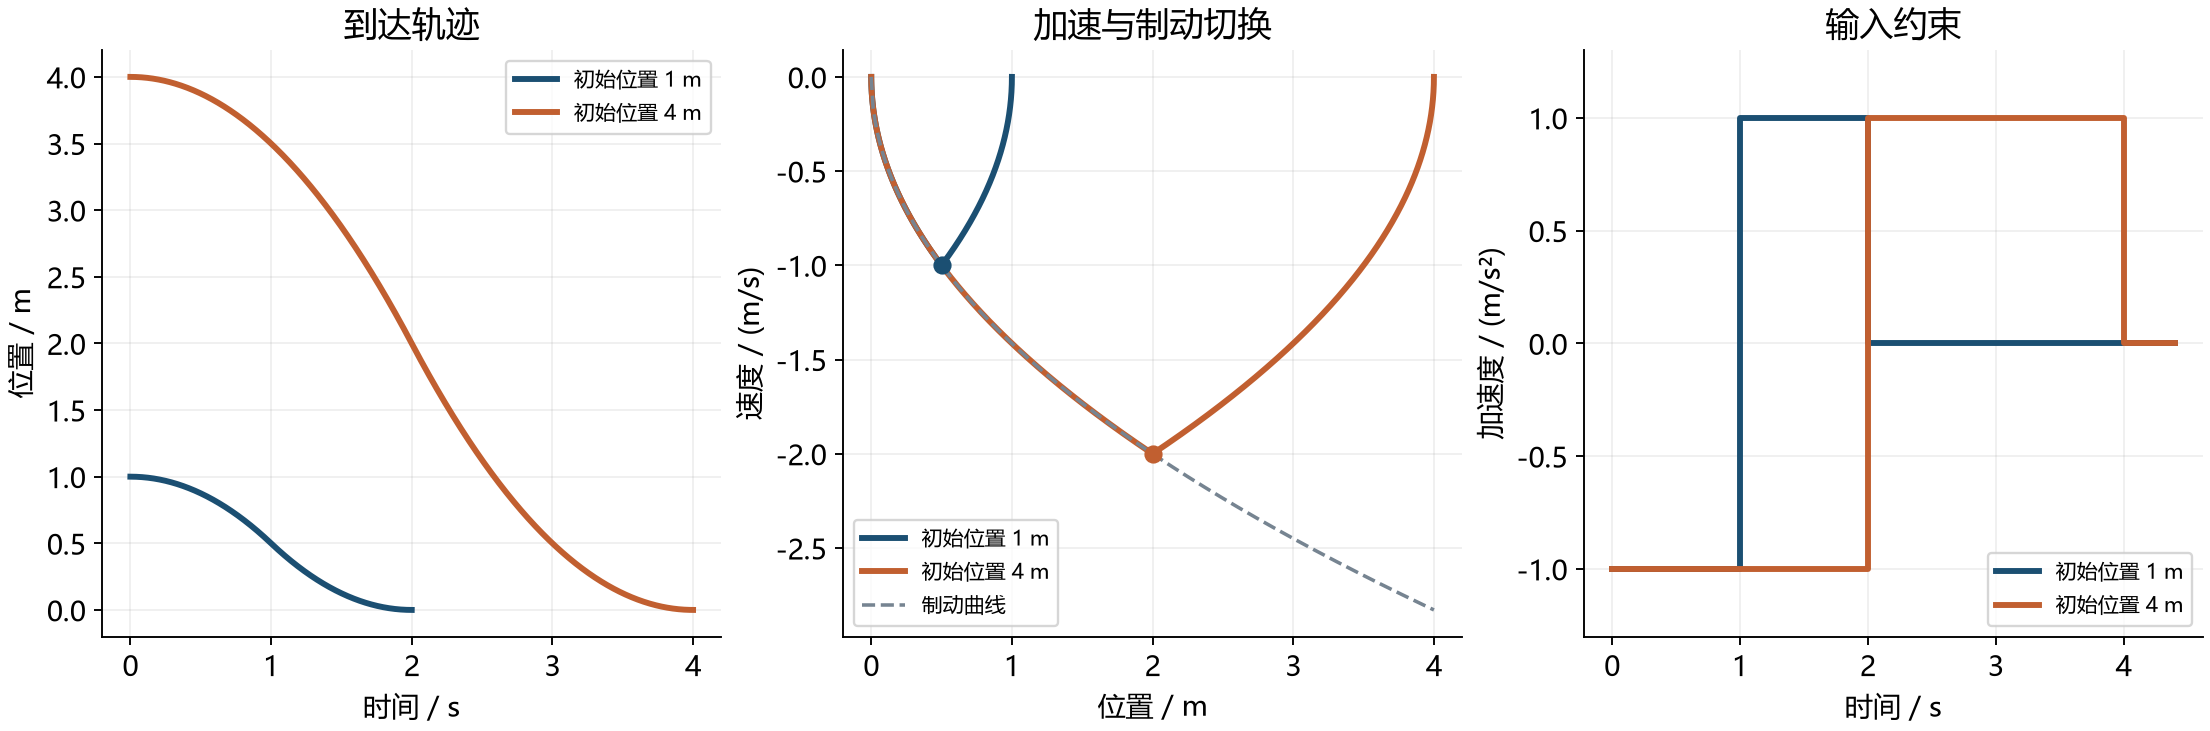
可下载轨迹计算与约束核验脚本。脚本检查起止状态、输入界限、制动曲线以及静止到静止的时间下界。
3.2 路径与时间缩放
搬运轴的切换控制同时决定经过哪里和何时经过。对于已经选好的机械臂路径,也可以先保留几何形状,再单独安排速度。用 $s\in[0,1]$ 表示路径进度,轨迹写成 $q(s(t))$;链式法则给出 $\dot q=q_s\dot s$、$\ddot q=q_s\ddot s+q_{ss}\dot s^2$。几何路径相同,时间缩放不同,执行器面对的速度、加速度和力矩需求也会不同。
对关节空间直线 $q(s)=q_0+s(q_1-q_0)$,取总时间 $T>0$、归一化时间 $r=t/T$。常用的三次和五次缩放分别为
两者都使起止速度为零;五次缩放还使起止加速度为零,便于与静止段衔接,但这不意味着起止 jerk 也为零。三次缩放的端点加速度通常非零,若前后立即接静止段,加速度会跳变。
让单关节在 $T=2\,\mathrm s$ 内从 $0$ 运动到 $\pi/2\,\mathrm{rad}$,可以比较两种缩放对驱动器的要求。三次与五次缩放的最大速度分别为约 $1.178097$、$1.472622\,\mathrm{rad/s}$;五次端点更平滑,却在相同时间内要求更高峰值速度。三次端点加速度为 $\pm2.356194\,\mathrm{rad/s^2}$,五次两端均为零。若速度上限为 $1.3\,\mathrm{rad/s}$,这个时长下三次满足该速度条件,五次需要延长时间;加速度和力矩还需分别检查。
峰值可以直接由多项式求出。五次缩放的导数为 $30r^2(1-r)^2/T$,在 $r=1/2$ 处达到 $15/(8T)$;乘以关节行程后,这个算例仅由速度限幅得到的时长下界约为 $2.265572\,\mathrm s$。该下界针对所选五次轨迹族,并不是所有合法轨迹的最短时间。把总时间加倍,会使惯性加速度项约缩小到四分之一、速度相关项也随速度平方缩小,但重力项不因此减小;延长时间仍不能解决一个静态负载已经超出驱动能力的问题。
1 | import modern_robotics as mr |
末端位姿不能逐元素线性插值后就假定仍在 $SE(3)$ 中。螺旋路径使用 $X(s)=X_0\exp(\log(X_0^{-1}X_1)s)$,在群上连接两个位姿;矩阵对数的向量化将角分量置前、线性分量置后,与六维运动的 $[\omega;v]$ 排列约定一致。这里的线性指数坐标一般不等于直接的位置差。固定螺旋轴并不要求末端原点走 Cartesian 直线。若分别插值位置和旋转,则可以让原点走直线,这对应另一种路径选择。
再比较两种末端路径:从单位位姿出发,到达绕 $z$ 轴转 $90^\circ$、位置 $(0.2,0.1,0.1)\,\mathrm m$ 的位姿。采用五次缩放,半程 $t=1\,\mathrm s$ 时,螺旋路径的位置约为 $(0.120711,0.008579,0.05)\,\mathrm m$,分离平移与旋转的路径为 $(0.1,0.05,0.05)\,\mathrm m$;两条路径的起点、终点相同,中间位置不同。
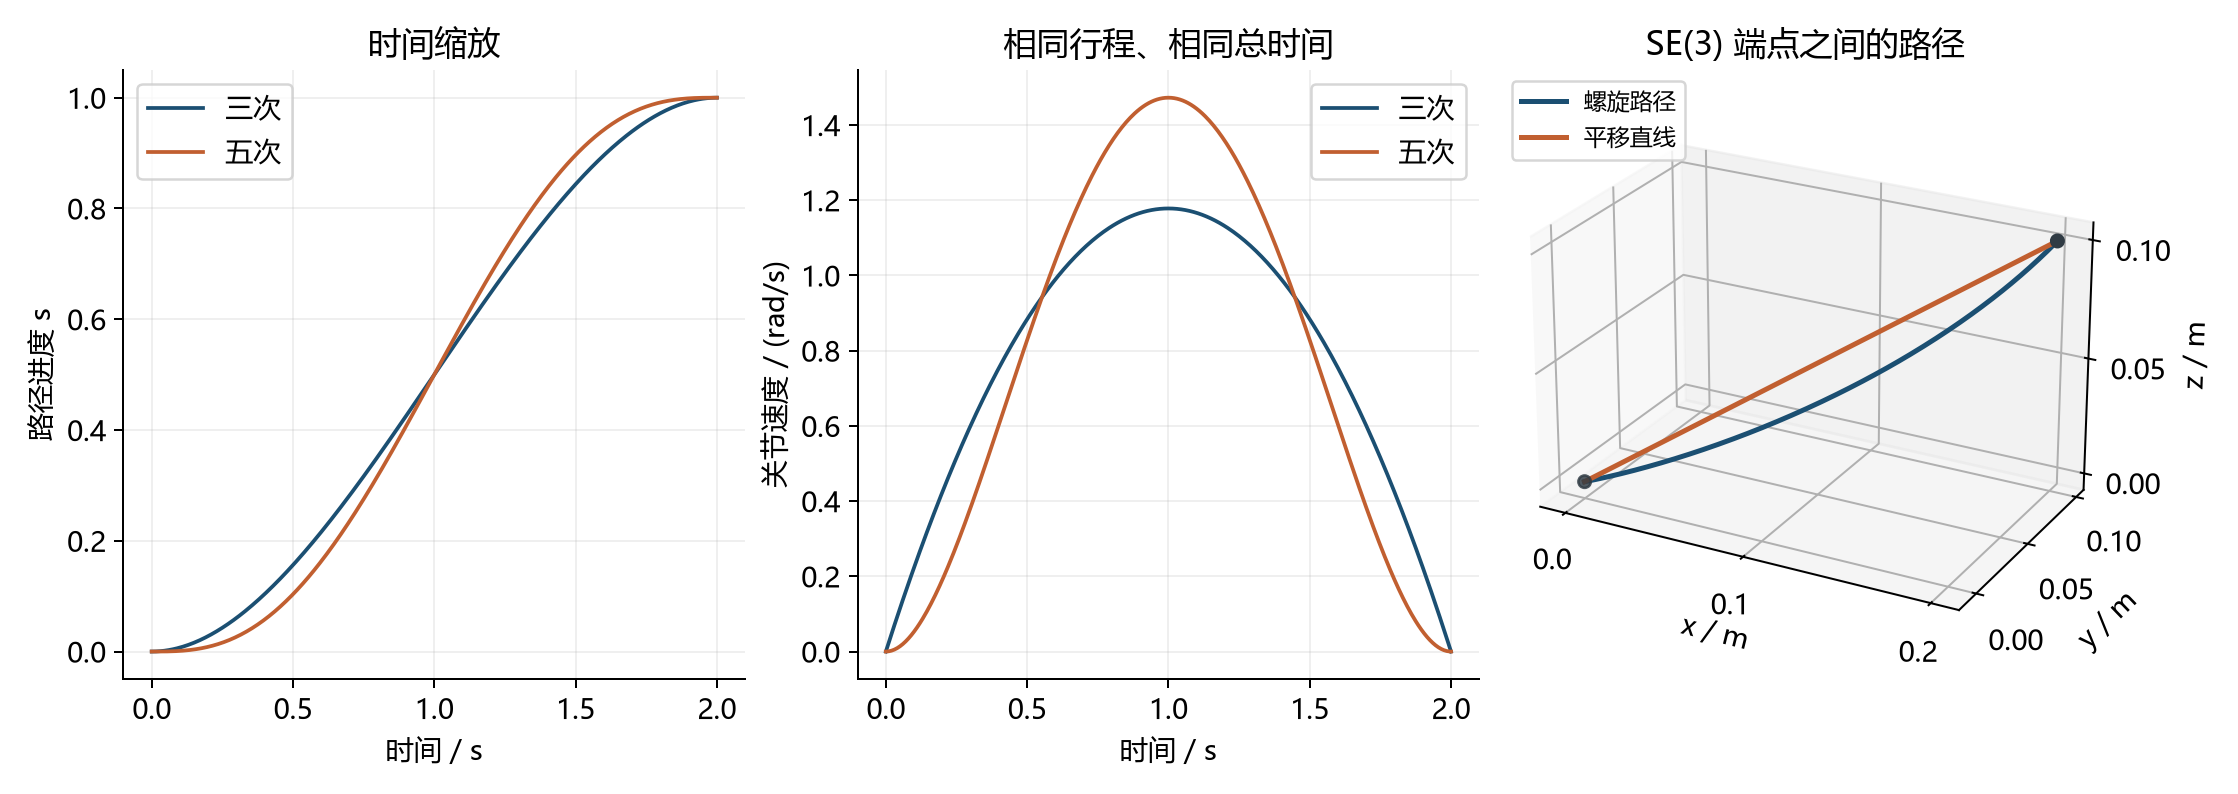
计算与核验脚本包含关节轨迹和位姿轨迹的端点检查。插值函数提供名义参考,碰撞、可达性和动力学约束还需要检验。执行过程中若状态偏离参考,也需要反馈调整;后面的 MPC 会根据当前状态重新求解约束优化。
4. 策略参数化
动态规划需要处理整个状态空间;另一种方法是给策略选定有限维参数 $\alpha$,直接最小化由参数产生的代价 $J_\alpha(x_0)$。例如:
- 线性策略 $u=-Kx$,以 $K$ 的元素为参数;
- 分段常值输入 $u(t)=\alpha_k$,每段持续一个固定时间间隔;
- 用样条或 Fourier 基函数表示输入;
- 用参数化的非线性函数表示状态到动作的映射。
选择参数化形式,等于选择优化器能够搜索的策略集合。更丰富的形式能表示更多运动,也会增加变量数与优化难度。直接优化可以处理比状态空间网格更高维的问题,但一般只保证得到一个局部结果;参数化本身也可能排除真正的全局最优策略。
分段常值输入便于理解这个过程:每个时间段有一组输入数值,把它们连成参数向量,就得到一条控制记录。模拟器根据记录计算运动,代价函数评价运动,优化器再调整记录。参数化反馈策略还把状态作为输入,因此同一组参数在不同状态下可以输出不同动作。
搜索范围解释了参数化方法与动态规划的区别。动态规划在所选离散状态和动作上比较决策,直接策略优化则只改变当前参数,通常沿局部代价下降方向搜索。紧凑的表示降低了计算规模,也限制了搜索范围;优化停止通常只说明当前搜索无法继续改善代价。
一阶梯度法沿代价减小的方向更新参数。它简单,但若不同方向的曲率差别很大,合适的步长就很难选择,可能需要许多次迭代。问题中存在多个局部极小值时,初始参数也会影响最终结果。
控制记录与反馈策略的区别在有扰动时尤其明显。优化得到十个未来输入,即使在名义模型中代价很低,也没有说明状态偏离时怎样调整这些输入;参数化 $u=\pi_\alpha(x)$ 则提供状态到输入的关系。前者可由轨迹跟踪器或 MPC 补上反馈,后者则在每次仿真中同时评价这个反馈关系。优化输入序列时,初始状态是问题的一部分;改变负载、起点或环境后,原解的可行性都需要重新检查。
5. 射击法
射击法把策略参数作为决策变量。对每组参数,从 $x_0$ 开始模拟动力学,得到状态轨迹并计算代价;优化器据此调整参数。与逐个扰动参数的有限差分相比,利用动力学的导数,可以更直接地计算代价梯度。
把闭环动力学和运行代价简写为 $\dot x=F(x,\alpha,t)$、$G(x,\alpha,t)$。为说明梯度计算,暂时令终端代价为零。先向前积分状态,保存 $x(t)$;再从终点向后积分伴随变量 $\lambda(t)$:
下标表示偏导数,$\lambda$ 表示未来代价对当前状态变化的敏感程度。参数梯度为
参数通过两条路径影响代价。直接改变运行代价的作用给出 $G_\alpha$;先改变动力学、再通过状态影响后续代价的作用给出伴随项。伴随变量汇总了后一条路径上的未来依赖,使梯度计算同时考虑当前与后续影响,并避免逐个参数重新模拟完整轨迹。
若存在终端代价 $h$,相应边界条件改为 $\lambda(T)=\nabla h(x(T))$。对含反馈的策略,$F_x$ 还需要包括策略随状态变化的部分,不能只对物理动力学求导。
可以用一个可解析的问题核对导数方向。设 $\dot x=\alpha x$、$x(0)=1$、$T=1$,只有终端代价 $h=\tfrac12x(T)^2$。解为 $x(T)=e^\alpha$,因此 $J=\tfrac12e^{2\alpha}$、$dJ/d\alpha=e^{2\alpha}$。取 $\alpha=0.2$,梯度约为 $1.491824698$。前向灵敏度给出 $P(t)=te^{\alpha t}$;伴随满足 $-\dot\lambda=\alpha\lambda$ 与 $\lambda(1)=e^\alpha$,把 $\lambda x$ 积分也得到同一结果。中心有限差分以 $10^{-6}$ 为扰动量,核对误差小于 $10^{-9}$。
长时间段的状态对早期输入可能极度敏感,单次射击的链式导数随之变得很大或很小。多重射击把时域分成若干段,各段独立积分,再用段末与下一段初值的连续性约束连接;它增加状态变量,却缩短了每次敏感度传播的距离。若轨迹包含接触切换,事件时间也依赖参数,平滑阶段的导数不能未经检查地覆盖碰撞和状态重置。
5.1 前向灵敏度
也可以定义 $P=\partial x/\partial\alpha$,沿状态轨迹同时积分
再把 $G_xP+G_\alpha$ 沿时间积分得到梯度。伴随法需要访问向前阶段的状态轨迹,前向灵敏度需要维护一个“状态维数乘参数维数”的矩阵。二者计算同一依赖关系,选择时主要比较状态维数、参数维数和轨迹长度带来的时间与存储开销。
如果初始状态不依赖参数,前向灵敏度的初值就是零。运动推进时,线性化矩阵 $F_x$ 传播已有的灵敏度,$F_\alpha$ 加入参数对当前动力学的直接作用。这样可以同步积累代价梯度,不必保存全部状态历史,但每个参数都需要维护一组状态灵敏度。
6. 直接配点
为了直接施加状态约束,可以把离散时刻的状态 $x_k$ 与控制输入一起作为决策变量,再用等式联系相邻状态。这是直接转写方法的基本框架:
同时加入初始条件、终端条件以及状态和输入的不等式约束。优化器因此在一个更大的变量空间中搜索,但不再要求每次评价目标都从初始状态进行完整的顺序模拟。
状态成为变量后,可以直接对节点位置施加避障或关节限位约束,也容易利用已知路径提供初值。如果大致知道希望机器人经过哪些位置,就可以把这段状态序列交给优化器,随后由优化过程修正不满足动力学的部分。
求得的离散序列满足的是选用的离散动力学。时间步长和积分公式决定近似精度;固定步长过大时,离散约束满足并不意味着连续运动已经准确。直接配点与射击法各有不同数值结构,不能仅按变量数量判断哪一种总是更好。
与射击法相比,直接转写改变了优化过程中处理状态的方式。射击法用模拟器生成状态,初始条件和参数确定后,后续状态也随之确定;直接转写允许节点状态暂时不满足动力学关系,再由等式约束逐渐消除差异。增加的状态变量用于表达数值问题,机器人的物理自由度仍由机构决定。
上面的 $x_{k+1}-F(x_k,u_k,k)=0$ 是直接转写的总框架,$F$ 的构造决定了具体方法。配点用分段多项式表示状态,并要求多项式的导数在指定节点满足连续动力学。以时间间隔 $h$ 的 Hermite–Simpson 形式为例,记两端导数为 $f_k,f_{k+1}$,有
中点状态来自匹配两端状态和导数的三次插值,第二式要求该插值的中点导数与真实动力学一致。MIT 的轨迹优化讲义用这一结构说明配点。每段约束主要涉及相邻节点,因此约束 Jacobian 具有稀疏性,求解器可以利用这种局部关系。
求解后的输入还需要放入独立积分器,比较连续轨迹与优化节点,并检查整段运动的约束余量。节点误差之外,节点之间的误差和障碍距离也会影响可执行性;接触瞬间、输入快速变化的区间通常需要更密的时间划分。独立积分检查补充了求解器的离散残差检查。
7. 轨迹优化与模型预测控制
7.1 迭代 LQR
对当前轨迹,在每个时刻线性化动力学,并对代价作二次展开,得到一个局部的时变线性二次问题。向后求解这个问题得到输入修正和反馈增益,再向前模拟新的轨迹,然后重复线性化与更新。这就是迭代 LQR 的基本结构。
每次近似只在当前轨迹附近可靠,因此输入更新需要控制幅度或选择合适步长,迭代所得结果通常是局部最优。微分动态规划使用类似的前向、后向结构,并进一步保留动力学的二阶信息。
局部策略通常写成 $\delta u_k=k_k+K_k\delta x_k$:前一项移动名义输入,后一项补偿状态对名义轨迹的偏离。向前更新时,不只把前一项加到旧输入,还需要用新仿真状态计算后一项,再通过线搜索判断总代价是否真的下降。输入限幅和碰撞等约束也不会因为用了 Riccati 递推而自动满足;需要受约束子问题、约束处理或单独的可行性检查。
7.2 模型预测控制
另一种产生反馈的方式,是反复求解一个短的有限时域问题。每次读取当前状态,规划未来一段时间,只执行计划最前面的一小段;下一次再以新的状态为起点重算。这称为滚动时域控制,也常称模型预测控制。
重新求解把新状态带入优化,使规划过程产生反馈。要在机器人上实现这种反馈,求解器必须在规定的控制间隔内给出可用解。因此,闭环运动质量同时取决于模型、代价、约束、状态估计和求解时间。
两步积分器可以展示重规划怎样改变动作。从 $x=2$ 规划得到两个输入均为 $-2/3$。执行首个输入后,名义状态为 $4/3$;若扰动把实测状态增加一,当前状态变为 $7/3$。继续执行旧第二个输入仍是 $-2/3$,重新规划两步问题的首个输入则为 $-7/9$。新动作由更新后的状态求得,同时新的两步时域向前移动;它与原固定终点问题的第二步属于不同的剩余优化问题。
递归可行性要求当前可行计划执行一步后,下一次仍能找到可行计划;稳定性要求反复重规划的状态收敛或满足所需的有界性质。终端集合、终端代价与可行备用控制可以用于建立这些性质,有限时域本身并不提供保证。工程实现还要定义超时或无解时执行什么,并考虑测量与通信延迟:求解器开始时的状态,可能已不是命令实际作用时的状态。
规划、KKT、Bellman 与梯度核验脚本使用 Python 标准库输出上述数值,检查最优候选的可行性、KKT 残差、独立网格比较和解析梯度。
机械臂放下物体或机器人脚掌落地时,接触会改变允许运动的方向和受力关系。要让计划跨过这些时刻,动力学模型还需要接触力约束与状态切换;下一章从这些任务继续讨论。
参考资料
Russ Tedrake. Underactuated Robotics. MIT OpenCourseWare, 2009. Chapter 1 (§1.4), Chapter 9 (§§9.1–9.3, 9.7.3), Chapter 10 (§10.1.1), Chapter 12 (§§12.1–12.7). © Massachusetts Institute of Technology;中文节选重排、记号校订与例题补充;译编采用 CC BY-NC-SA 4.0。
Dimitri P. Bertsekas. Convex Analysis and Optimization, Lecture 10. MIT OpenCourseWare, 2012. Slides 11–17: convex programming, quadratic programming and optimality conditions.
Kevin M. Lynch, Frank C. Park. Modern Robotics: Mechanics, Planning, and Control. Cambridge University Press, 2017; updated-first-edition preprint, December 2019. §§9.1–9.2.2.1 and §9.6, Eqs. (9.1)–(9.13), printed pp. 327–332, 348. 路径与时间缩放:概念整理与公式核对;参数算例另列代码来源。
NxRLab / Modern Robotics contributors. Modern Robotics Python Code Library. Fixed commit cbd41fdf0bf75dbd5e986d832ae14226964ff0ac, CubicTimeScaling / QuinticTimeScaling / JointTrajectory / ScrewTrajectory / CartesianTrajectory; Copyright © 2019 NxRLab, MIT License. 配套脚本为接口与公式的数值实例,MIT;轨迹算例图由本系列作者计算绘制,CC BY-NC-SA 4.0。
Tedrake, Russ. Underactuated Robotics: Trajectory Optimization; Dynamic Programming. Direct transcription, shooting, Hermite–Simpson collocation and feedback planning. Accessed 2026-10-08. 配点定义与数值结构核对;积分器和灵敏度算例为独立推导。