CH-13 模仿学习训练与评测
本章使用 Lift 示范完成 BC 训练、checkpoint 加载和 robosuite 仿真评测,无需真实机械臂。
现在已经有可计算的机器人模型、明确的动作接口与仿真循环,可以把第 09 章的行为克隆落到一次抓取任务上。网络需要从示范观测预测接近、闭合夹爪和提起物体的动作;离线拟合的误差会在环境里改变下一观测,最终决定能否抓取成功。本章从整条 episode 的数据划分与动作尺度开始,逐步走到训练、模型保存和独立闭环评测,使一次成功率报告能追溯到确切的数据、配置和权重。
1. 运行环境
robomimic 的安装分为学习框架和仿真依赖两部分。算法和数据工具可以在不安装仿真器时使用;闭环 rollout 则需要能重新创建采集数据时的环境。官方安装说明以 Linux 或 macOS 为基础,本章命令按 Linux 终端组织。
第 09 章把行为克隆写成观测到动作的监督学习,本章让“数据来自哪里、网络预测什么、预测如何执行”成为可检查的文件和程序。这里的 Lift 是一个完整闭环任务:末端靠近物体、夹爪闭合、物体随夹爪上升。仅把示范动作回归得像,不能保证经过前几步误差之后仍能完成抓取。robomimic 的原始研究正是围绕算法选择、示范质量和训练停止标准对任务表现的影响展开,工程流程因此必须把数据、损失与环境成功率一起保留。
本章固定 robomimic 提交 d309eaecc18acf4152a830a895a6984b8ac71b05,其 setup.py 版本为 0.5.0。仿真采用官方数据文档对应的 robosuite v1.5.1。
创建独立环境并安装 CPU 版 PyTorch:
1 | conda create -n robomimic_venv python=3.8.0 |
Python 与 PyTorch 版本沿用该项目安装文档的组合,CPU wheel 的索引按 PyTorch 官方历史版本页面核对。将来使用 CUDA 时,应按相应版本重新选择 PyTorch 构建。
在与 robomimic 并列的位置安装仿真器:
1 | cd .. |
本章余下命令都从 robomimic 仓库根目录运行。保存相机视频还需要可用的离屏渲染环境,按 robosuite 对应版本的安装说明配置。
2. Lift 示范数据
robomimic 数据覆盖不同难度的操作任务、不同质量的人类示范,以及仿真和真实机器人数据。
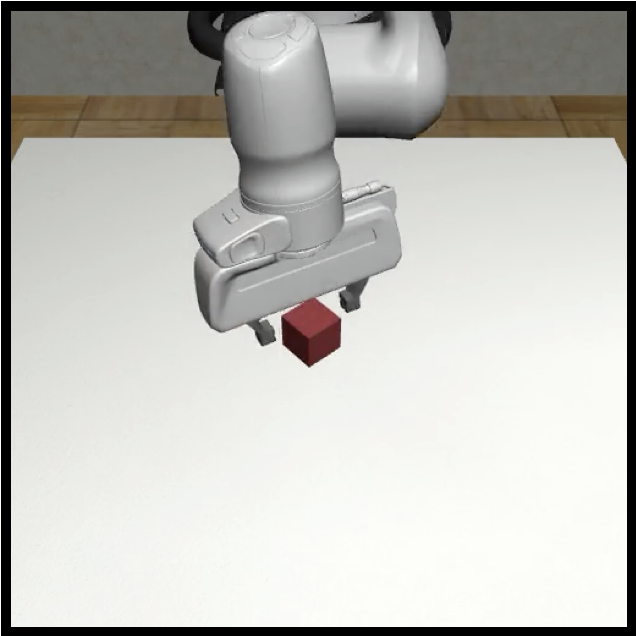
图 1:Lift 任务中,机械臂抓住物体并将其提起。
下载脚本支持任务、示范类型、HDF5 类型和输出目录。先进行 dry run,再下载:
1 | python robomimic/scripts/download_datasets.py --tasks lift --dataset_types ph --hdf5_types low_dim --dry_run |
本章固定版本的注册表指向 v1.5/lift/ph/low_dim_v15.hdf5,下载后路径为 datasets/lift/ph/low_dim_v15.hdf5。官方 Getting Started 的部分文本仍保留 low_dim_v141.hdf5,这里以当前数据页和注册表为准。
数据文档还说明:新版数据基于 robosuite v1.5.1,使用 DeepMind MuJoCo Python 绑定;CoRL 2021 原始实验使用较早的 offline_study 分支。新版能使用新功能,但学习结果不保证与早期论文完全一致。要严格复现论文,需使用论文对应的数据和环境。
这是环境动力学进入学习实验的具体位置。相同动作向量在不同控制器、控制周期或接触参数下,可能产生不同的下一观测。训练文件中的环境元数据与第 10、11 章的模型和时序相联系;版本号是必要记录,还应保存所用任务配置及数据文件身份。对“CPU 教学流程能运行”的检查与“某论文的成功率能复现”的检查,实验条件和计算预算不同。下面不预设任何训练成功率,指标必须来自实际 rollout 输出。
PH 示范由一位操作者使用 RoboTurk 平台采集,每个任务数据集包含 200 条成功轨迹。Multi-Human(MH)由六位熟练程度不同的操作者采集,每位提供 50 条,共计 300 条成功轨迹。Paired 是诊断数据集:一位熟练操作者在 Can 任务的每个初始条件下各采集一条好轨迹和一条坏轨迹,以检查算法从混合质量示范中学习的能力。
成功标签只说明整条示范最终完成了任务,不意味着每一帧动作都同样有效。不同操作者可能有不同抓取路径和停顿习惯,按帧采样还会给较长轨迹更高权重。若希望检验新初始条件上的能力,可以保留独立 episode;若希望检验新操作者上的能力,则应按操作者留出数据。随机分几条 MH 轨迹到验证集仍可能让同一个人的行为模式同时出现在训练和验证中,回答的泛化问题不同。
3. HDF5 数据结构
示范文件不仅保存动作,也保存训练输入和重建环境所需的信息。检查数据结构之后,才能确认 BC 学到的是哪种观测与动作接口,并在相应环境里执行保存的模型。
兼容 robomimic 的后处理数据使用统一 HDF5 结构。顶层 data 中的 total 是状态—动作样本总数,env_args 是创建环境所需的 JSON 元数据,包括环境名称、环境类型以及构造参数。每条轨迹具有独立的 demo_* 分组。
每条示范中的 actions 按时间排列,形状为 $(N,A)$,其中 $N$ 是轨迹长度,$A$ 是动作维度。states 保存展平的 MuJoCo 状态;rewards 和 dones 保存奖励与终止信号。obs 按名称保存各观测,next_obs 保存下一步观测。robosuite 轨迹还可保存对应 MJCF 模型字符串。
训练样本中的 $o_t,a_t,o_{t+1}$ 必须构成同一个控制间隔:$a_t$ 是基于 $o_t$ 作出的命令,$o_{t+1}$ 是执行后的反馈。若摄像头比关节状态慢,观测是否做了同步或保持,也属于数据定义。states 是重建仿真的内部状态,不一定是策略可在真实机器人上获得的输入;把内部物体位置无意加入策略输入,会改变任务的信息条件。检查数据时既要检查数组长度和缺失值,也要检查坐标系、控制频率、绝对或相对动作以及观测是否只用了允许的信息。
图像观测应按 uint8、通道在后的 $(H,W,C)$ 形式存储;标准数据约定中的动作通常归一化到 $[-1,1]$。检查脚本可检查动作范围,并报告异常。
运行数据检查:
1 | python robomimic/scripts/get_dataset_info.py --dataset datasets/lift/ph/low_dim_v15.hdf5 --verbose |
它报告轨迹数量、长度统计、过滤键、环境元数据,以及示范的数据结构。--verbose 还列出过滤键对应的具体轨迹。
mask 中的过滤键可以描述任意数据子集。创建十个百分点的验证轨迹:
1 | python robomimic/scripts/split_train_val.py --dataset datasets/lift/ph/low_dim_v15.hdf5 --ratio 0.1 |
默认生成 mask/train 和 mask/valid。
固定脚本以整条 demo_* 为单位,验证数量是 int(ratio * num_demos),命令行入口把 NumPy 随机种子设为 0。200 条示范的 0.1 比例给出 180 条训练、20 条验证,但验证帧数未必正好占全部帧数的 10%。重新运行拆分会写入过滤键,因此应保存实际列表和数据文件校验值,不能仅保存比率。若一个长为 100 帧的 episode 被逐帧独立随机拆分,训练概率 0.9、验证概率 0.1,则同一 episode 同时落入两组的概率为 $1-0.9^{100}-0.1^{100}\approx0.999973$。相邻画面与状态高度相关,这种验证容易高估对独立轨迹的泛化能力。
另一个小案例有十条轨迹,其中八条各 10 帧,两条各 100 帧。留出两条虽然是 20% 的 episode,若恰好留出两条长轨迹,验证帧占 $200/280\approx71.43\%$。这不是官方数据的长度统计,而是说明为什么日志要同时报告 episode 数和样本数。拆分、动作统计与成功率脚本复算这两种比例,不读取或修改 HDF5,也不模拟官方 NumPy 拆分顺序。
渲染可用时,先查看少量示范:
1 | python robomimic/scripts/playback_dataset.py --dataset datasets/lift/ph/low_dim_v15.hdf5 --render_image_names agentview robot0_eye_in_hand --video_path lift_demos.mp4 --n 5 |
这个命令通过记录的仿真状态查看轨迹;--use-actions 则让记录动作在环境中执行,是不同检查方式。对于已有图像的真实数据,可以用 --use-obs 查看观测,而不是尝试恢复不存在的仿真环境。
状态播放首先检查记录是否可解释、物体与机器人是否合理;动作播放还检验模型、初始状态和时序能否使相同命令产生预期轨迹。两者不一致时,应先查环境版本、控制器和采样间隔,再怀疑学习算法。把这些基础差异留到 rollout 后处理,会让模型表现和环境重建错误混在一起。
4. 实验配置
robomimic 用集中式配置描述训练、算法、观测、日志、保存和 rollout。官方建议通过 JSON 文件传给 train.py,而不是直接修改 bc_config.py 等默认配置。独立配置能明确记录某次实验改变了哪些参数。
下载BC 配置文件,保存到仓库根目录;下面内容可用于核对配置。它在 BC 默认配置上覆盖 CPU、数据划分和教学练习长度,其他设置仍采用代码中的默认值:
1 | { |
experiment.validate 打开验证,两个过滤键决定训练和验证分别访问哪些轨迹。rollout.n 是每次评测的轨迹数量,horizon 是每条轨迹最大步数,rate 是评测间隔。保存规则可以按固定周期,也可以按验证或 rollout 指标保存模型。
配置同时定义了优化问题和测量问题。训练与验证过滤键必须不重叠;评价策略时还应明确哪些随机初始条件用于选择 checkpoint,哪些用于最后报告。若在同一组测试 rollout 上反复挑最高分模型,再把该最高分当成最终泛化结果,会把评测噪声也纳入选择。教学流程可先验证所有路径和接口,再为正式比较固定模型选择规则及独立评价种子集合。
默认低维 BC 使用末端位置、末端四元数、夹爪位置和物体相关观测,具有普通前馈动作回归网络。
对于结构化动作,框架用 action_keys 规定使用哪些分量,用 action_config 规定每个分量如何处理。分量可以是末端位置、旋转和夹爪指令;它们不一定具有同样范围,也不一定采用同一种归一化。action_keys 的顺序决定拼接顺序,训练与部署必须保持一致,并在配置中记录预期次序。
normalization: null 采用单位尺度和零偏移,适合已经在所需范围内的动作;min_max 将有界值缩放到接近 $[-1,1]$ 的范围;gaussian 使用均值和标准差进行标准化。过小的范围或标准差需要数值稳定性处理,不能直接用很小的数作为分母。
旋转表示也可以在训练与执行之间转换。固定版本支持网络预测六维旋转表示,再在 rollout 时转换为轴角或欧拉格式。网络中的动作维度与环境接受的动作维度因而未必相同,转换必须由正确配置完成。
归一化流程先计算数据统计,再分别处理动作分量,最后按 action_keys 拼接。扩散策略对动作范围另有检查,官方建议使用 min_max 或预先把数据归一化到要求范围。
统计量定义了学习坐标,部署时必须使用训练时同一组统计做逆变换,不能对当前 rollout 临时重算。对于严格留出实验,还应核对统计计算实际遍历的是哪一组过滤后的样本,避免验证信息进入预处理。以训练动作 $(-0.2,0,0.2)$ 为例,按总体方差计算均值为 0、标准差为 $\sqrt{0.08/3}\approx0.163299$;一个留出值 $0.8$ 被标准化为约 $4.899$。若先把留出值也混入统计,均值变成 $0.2$、标准差约 $0.374166$,同一个留出值只剩约 $1.604$。复算脚本验证这种泄漏如何改变输入尺度。这是通用预处理案例,未假定本章默认的已归一化 Lift 动作启用了额外 Gaussian 标准化。
本章的 50 个 epoch 和每次 10 条 rollout 是教学练习设置,完整研究复现应使用发布的实验配置。
5. 行为克隆训练
启动一次带 --debug 的检查:
1 | python robomimic/scripts/train.py --config 13-bc-lift-cpu.json --dataset datasets/lift/ph/low_dim_v15.hdf5 --debug |
固定提交中的 debug 会把训练改为两个 epoch,每个训练 epoch 只运行三个梯度步骤,每个验证 epoch 只评估三个批次;rollout 改为每次两条、每条十步,并在每个 epoch 进行。它还把输出目录改为 /tmp/tmp_trained_models。因此,debug 结束后应检查该临时目录,而不是正式配置中的输出路径。
检查通过后,去掉 --debug:
默认前馈 BC 的主要目标可写成 $L(\theta)=\tfrac1{NA}\sum_{t,j}(\pi_\theta(o_t)_j-a_{t,j})^2$,固定模板的 L2 权重为 1,L1 与 cosine 权重为 0。梯度下降根据示范观测减少动作误差,验证阶段保持参数不变,在留出的示范上计算相同类统计。二者都没有让预测动作改变示范中的下一状态,所以验证损失是离线拟合检查。平方损失还会偏好条件均值:若相似观测对应向左、向右绕障两种可行示范,均值可能变成向障碍正前方移动。更丰富的策略分布或历史观测有助于处理多模态与部分可观测问题,但仍需闭环评价。
1 | python robomimic/scripts/train.py --config 13-bc-lift-cpu.json --dataset datasets/lift/ph/low_dim_v15.hdf5 |
训练输出位于 <train.output_dir>/<experiment.name>/<date>。里面包括本次实际配置 config.json、日志 logs/、视频 videos/ 以及模型 models/。
若作业中断,固定版本还支持在原命令后增加 --resume,从最近训练运行的 last.pth 恢复。恢复不仅加载模型权重,也加载优化器状态;指定微调 checkpoint 只初始化权重的过程与之不同。使用 resume 时,last.pth 的优先级高于配置中的 ckpt_path。
恢复训练还依赖数据、过滤键、软件与配置的一致性。权重可加载说明张量与网络结构匹配,不保证恢复了相同的实验输入;改变动作顺序甚至可能保持维度相同而悄悄交换物理语义。一次可复现运行应把实际配置、数据校验值、拆分列表、代码提交、随机种子以及所选 checkpoint 放在同一记录中。固定种子使实验更可追踪,但不应承诺不同硬件、依赖或并行路径逐位一致。
5.1 检查输出
debug 检查结束后,在 /tmp/tmp_trained_models/<experiment.name>/<date> 查看实际配置、日志和 models/last.pth。正式训练则查看 bc_trained_models/lift_ph_cpu/<date>。两次运行的输出位置不同,评测命令中的 --agent 应指向所选运行实际生成的文件。
6. 模型与日志
日志设置位于 experiment.logging。终端记录保存在 logs/log.txt,TensorBoard 数据保存在 logs/tb。查看本章实验的命令是:
1 | tensorboard --logdir bc_trained_models/lift_ph_cpu |
Train/ 记录训练统计,Validation/ 记录验证统计,Rollout/ 记录环境执行的奖励和成功率,Timing_Stats/ 记录数据读取、训练、rollout 等时间,系统统计还记录内存使用。
TensorBoard 中,横轴按 epoch 记录实验进展。Rollout/Success_Rate/{envname}-max 是运行到当前时刻的最大成功率,原研究使用这个量评价基线;它与最后一次 rollout 的成功率并非同一个字段。System/RAM Usage (MB) 以兆字节记录系统内存。日志文件和 TensorBoard 记录由不同配置项控制,可以分别开启。
on_best_validation 与 on_best_rollout_success_rate 可以各自触发保存。
解读 L2 时应回到动作的尺度。例如一个分量的归一化均方误差为 0.01,则其 RMSE 为 0.1;若逆变换尺度为 $0.05\,\mathrm m$,对应 $5\,\mathrm{mm}$,若另一分量尺度为 $0.5\,\mathrm{rad}$,则对应 $0.05\,\mathrm{rad}$。整体平均损失还可能被大量接近零的动作压低,而关键的闭合夹爪帧误差被掩盖。可以按动作分量和任务阶段检查,但这些诊断仍不能代替抓取成功率。Mandlekar 等人的原始研究特别讨论训练与评价目标不同造成的模型选择差异,正对应这里两个保存开关的用途。
配置中的训练 epoch 还可以用固定梯度步骤数定义,验证也可以限制每次执行的步骤数。因此,“一个 epoch”不一定等于把所有示范逐帧完整遍历一遍。
因此横轴上同为 50 个 epoch 的两次运行,可能具有不同的梯度更新数、batch 大小、读取帧数和 rollout 开销。比较学习效率时,应同时记录更新数与实际耗时;比较环境样本效率时,应记录产生了多少条闭环轨迹。BC 的离线训练帧来自固定数据,训练期间的评测 rollout 则是额外环境交互。把这两类样本相加再称为示范数量,会失去实验的含义。
固定提交中的训练代码每个 epoch 还保存 last.pth,并保存最新模型备份。
7. 仿真评测
验证集损失描述示范上的拟合,rollout 则让机器人环境真正响应预测动作。下面从一个保存的 checkpoint 开始,核对模型加载、环境重建和任务统计。
将下面的 /path/to/model.pth 替换为本次训练目录中实际存在的模型文件。先进行无视频评测:
1 | python robomimic/scripts/run_trained_agent.py --agent /path/to/model.pth --n_rollouts 50 --horizon 400 --seed 0 |
脚本读取 checkpoint、构造策略和环境,然后真正执行每条 rollout。它统计 Return、Horizon、Success_Rate,并汇总成功次数 Num_Success。
闭环分布为何会变,可以用一维误差传播理解。若每步有同方向的 $1\,\mathrm{mm}$ 位置偏差,并暂时忽略纠正与动力学耦合,20 步后可累积到 $20\,\mathrm{mm}$;下一观测已经不再是示范中的精确位置。真实误差不必线性累积,但这个简单模型解释了离线小损失仍可能错过抓取接触的原因。Ross、Gordon 与 Bagnell 的 DAgger 工作研究了预测动作改变未来观测的分布问题,通过收集策略访问状态上的专家标注扩充数据。本章仍是固定数据 BC,没有执行 DAgger;该理论联系帮助判断何时需要新示范或纠错数据。
每条 rollout 开始时,先调用 policy.start_episode() 清理策略的 episode 状态,再重置环境并读取初始仿真状态。对 robosuite,脚本还用 reset_to 重新设定该状态,以支持确定性动作播放。随后逐步把观测传给策略,把返回的动作交给 env.step,累加奖励,并读取 env.is_success()["task"]。遇到环境终止或任务成功时,循环提前结束;否则继续使用下一观测。
不传入 --horizon 时,脚本从 checkpoint 中的 experiment.rollout.horizon 读取最大时域;环境也依据保存的 checkpoint 创建,--env 可以覆盖环境名称。评测种子同时设置 NumPy 和 PyTorch 的随机数生成器。一次评测完成后,各轨迹指标取平均,成功次数则把每条轨迹的成功标志相加。
成功率是 episode 级别的统计。假设一份教学评测中 50 条独立、同分布初始条件的轨迹成功 40 条,则点估计 $\hat p=40/50=0.8$。用 $z=1.96$ 的 Wilson 二项比例区间,中心与半宽为
得到约 $[0.670,0.888]$,比单报“80%”更能体现有限样本的不确定性。即使十条全部成功,同一方法的下界也仅约 $0.722$。脚本复算这两个假想计数,没有生成任何策略评测结果。区间依赖独立 Bernoulli 试验假设;复制同一初始状态、多个轨迹共享强相关随机条件,或先按这些结果挑模型,会破坏这种简单解释。报告还须给出任务成功定义、时域和实际成功数。Return 衡量奖励累计,Horizon 受到成功或失败提前结束影响,三者应结合判断,不应互相替代。
视频录制与屏幕渲染不能同时启用。屏幕渲染只能使用一个相机;视频可以使用多个相机,每个相机生成 $512\times512$ 的图像后水平拼接。--video_skip 指定每隔多少控制步写入一帧,默认值为 5。
渲染可用后,再保存相机视频:
1 | python robomimic/scripts/run_trained_agent.py --agent /path/to/model.pth --n_rollouts 50 --horizon 400 --seed 0 --video_path lift_policy.mp4 --camera_names agentview robot0_eye_in_hand |
也可以把策略产生的轨迹保存为新 HDF5:
1 | python robomimic/scripts/run_trained_agent.py --agent /path/to/model.pth --n_rollouts 50 --horizon 400 --seed 0 --dataset_path lift_rollouts.hdf5 --dataset_obs |
--dataset_obs 保存显式观测;不使用它时仍可保存状态,之后再用对应工具提取观测。
7.1 模型加载检查
完整评测之前,可以先用同一脚本执行一条最多十步的 rollout:
1 | python robomimic/scripts/run_trained_agent.py --agent /path/to/model.pth --n_rollouts 1 --horizon 10 --seed 0 |
程序应能读取策略与环境信息,并输出 Average Rollout Stats 下的 Return、Horizon、Success_Rate 和 Num_Success。这一步检查加载和接口;任务评价仍使用上面的 50 条、400 步配置。十步检查中的成功率不能替代完整评测。
完成评测后,应能从每个 episode 的初始状态、长度、成功标志和视频定位失败阶段,并找到实际加载的 checkpoint。这样“没有抓住物体”才能继续拆成观测遗漏、接近偏差、夹爪时序或接触动力学问题。下一章保留数据—策略—控制—仿真的同一闭环结构,将示范动作换成人形参考运动;区别是参考轨迹用于奖励与目标观测,策略通过物理交互学习保持追踪,而不只是逐帧监督回归动作。
参考资料
Stanford Vision and Learning Lab. robomimic Installation; Getting Started. Install robomimic; Install simulators; Running experiments. Copyright (c) 2021 Stanford Vision and Learning Lab;中文节选重排,Lift 原图保留;配置调整为 CPU、小规模训练及显式数据划分,补全仓库脚本路径;MIT License。
Stanford Vision and Learning Lab. robomimic v0.1 Datasets; Dataset Overview. Downloading; Dataset Structure; Filter Keys.
Stanford Vision and Learning Lab. Dataset Contents and Visualization; Configuring and Launching Training Runs. Dataset inspection; Configuration.
Stanford Vision and Learning Lab. Action Configuration. Component order; Normalization; Rotation conversions.
Stanford Vision and Learning Lab. Logging and Viewing Training Results; Using Pretrained Models. Checkpoints; Rollout evaluation.
robomimic Contributors. robomimic Source. setup.py; Dataset registry; train.py; run_trained_agent.py.
PyTorch Contributors. Previous PyTorch Versions. PyTorch 2.0.0 CPU wheels.
Mandlekar, Ajay, et al. What Matters in Learning from Offline Human Demonstrations for Robot Manipulation. CoRL, 2021. Demonstration quality, algorithm choices and stopping criteria; training and evaluation objectives. 新增实验设计联系。
Ross, Stephane, Geoffrey Gordon, and Drew Bagnell. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, PMLR 15:627–635, 2011. Policy-induced observation distributions and DAgger. 新增闭环分布解释,本文训练流程仍为离线 BC。
NIST/SEMATECH. e-Handbook of Statistical Methods: Confidence Intervals for Proportions. Wilson interval and assumptions. 假想成功计数、episode 拆分及归一化案例为独立标准库复算,非学习评测结果。