CH-14 人形运动模仿与部署
本章使用 MimicKit 的 G1 步行动作配置,在 Isaac Lab 后端完成动作查看、策略训练、模型保存和仿真推理。
机械臂模仿学习关注一次抓取,人形运动还要在持续变化的接触中维持姿态与平衡。参考片段给出了步行的形状,却没有替机器人解决惯量、驱动和足底接触的问题。本章把第 04、05、07 章的动力学与控制接到 DeepMimic 风格的反馈学习,检查参考动作、双频率调度、奖励和模型接口,再讨论重定向与真实驱动需要补上的条件。仿真中完成训练和推理后,仍须通过实际硬件反馈才能评价真实部署效果。
1. 运行环境
MimicKit 提供 DeepMimic、AMP 等运动模仿控制方法,并以统一 engine 接口支持不同仿真后端。本章固定 MimicKit 提交 2ed1e6c093bb0829f55d33cb4f7a1731cfe6cb69。其 README 对 Isaac Lab 明确列出测试提交 2ed331acfcbb1b96c47b190564476511836c3754;该提交的 VERSION 为 2.3.0,安装文档对应 Isaac Sim 5.1.0 和 Python 3.11。
第 13 章从示范观测回归动作,这里则提供希望机器人完成的参考运动,再通过与物理环境交互学习反馈策略。DeepMimic 的核心联系是“运动作为目标,动力学作为约束”:参考骨架告诉系统某个时刻应当抬哪只脚,策略仍必须根据当前速度、姿态和接触状态决定关节目标,产生的运动由引擎计算。参考片段能播放、学习程序能输出权重、闭环角色能稳定追踪,是三项不同检查。下面的命令给出可复现的操作路径,训练回报与步行质量必须由实际运行产生。
以下是 Linux x86_64 路径。应先按 Isaac Sim 对应版本的系统要求确认 NVIDIA GPU 和驱动可用;pip 安装方式要求 GLIBC 2.35 或更新,Ubuntu 20.04 默认 GLIBC 2.31 不满足这一条件。
1 | conda create -n env_isaaclab python=3.11 |
--install none 安装 Isaac Lab 扩展,但不额外安装它提供的其他学习框架;MimicKit 使用自己的训练代码。最后一条命令是官方安装检查,预期打开黑色视口。出现 ModuleNotFoundError 时,应先核对已激活的环境及官方环境设置。安装检查完成后退出示例,再安装 MimicKit:
这个空场景检查只验证仿真应用启动、扩展导入和图形环境;它没有加载 G1、读取动作,也没有建立策略网络。逐层检查的作用是定位错误:先启动引擎,再确认机器人资产和运动数据,然后检查一次状态—命令—物理步,最后训练。GPU、驱动、Python 与引擎版本共同影响这条链,固定版本的安装命令应与该版本说明一起保存。并行环境数量是实验参数,不是仅凭显卡名称就能保证的训练吞吐量。
1 | cd .. |
从 MimicKit README 的官方链接 获取资产与动作包,按说明解压到 data/。以下命令都在 MimicKit 根目录运行。
2. 参考动作
参考动作给出了 G1 希望模仿的运动。先确认动作能够在对应骨架上播放,再训练根据当前机器人状态选择控制命令的反馈策略,能把动作文件问题和控制器问题分开。
运动数据保存在 data/motions/。环境配置中的 motion_file 指定参考片段,也可以指向 data/datasets/ 中包含多条动作的数据集定义。单条动作文件采用 Pickle 格式,由 Motion 类读取。
每帧按“根位置、根旋转、关节旋转”排列:根位置是三维向量,三维旋转采用指数映射,单自由度关节采用角度。关节顺序与模型 XML 中运动学树的深度优先顺序对应。
动作片段表示带时间的构型序列 $\hat q(t)$,并可据此得到参考速度与关键点位置。根位置通常描述整体在空间中的位移,关节旋转描述相对于父节点的局部运动;它们不能直接与世界中每个刚体的姿态逐项相减。第 02 章的旋转几何在这里决定插值和误差计算:跨越旋转表示分支时,对指数映射坐标简单平均可能与期望旋转路径不同,查看动作时应重点检查循环接缝与大幅转动。运动的帧率规定参考时间网格,控制频率规定策略调用时间,两者需要通过时间采样连接,而不是强制令一帧动作等于一步物理积分。
G1 查看环境使用 data/assets/g1/g1.xml 与 G1 动作。运行:
1 | python mimickit/run.py --mode test --num_envs 1 --engine_config data/engines/isaac_lab_engine.yaml --env_config data/envs/view_motion_g1_env.yaml --visualize true |
MimicKit 原始参数文件默认使用 Isaac Gym;本章按 README 的后端选择方式显式传入 Isaac Lab 配置,避免把两个后端混在一个命令中。
可视化窗口中,按住 Alt 并拖动鼠标左键平移相机,用滚轮缩放;Enter 暂停或继续,Space 单步推进。
2.1 资产检查
解压动作包后,先检查本章使用的机器人和参考动作文件:
1 | python -c "from pathlib import Path; files=['data/assets/g1/g1.xml','data/motions/g1/g1_walk.pkl']; print({f: Path(f).is_file() for f in files})" |
两个文件都存在时,各项结果为 True。查看窗口应能播放对应 G1 的参考动作;这一步检查骨架、动作文件和显示流程。
查看模式可把参考机器人置于指定姿态,因此即使脚穿地或某个加速度在力矩限制下不可实现,动画仍可能播放。进一步检查要看脚底高度、关节范围、根位移和循环接缝速度。参考轨迹若在站立阶段明显滑脚,追踪策略就同时面对姿态目标与接触约束的不一致;第 07 章的接触模型解释了为什么“视觉上像人走路”还不足以作为机器人可执行轨迹。参考动作的问题应先在独立副本中处理并记录,再比较训练策略。
3. 追踪控制配置
追踪控制同时涉及参考目标、当前物理状态和执行器。奖励衡量与参考动作的差异,控制模式决定输出如何作用到关节,频率决定一次策略更新之间推进多少物理步。
本章训练环境为 data/envs/deepmimic_g1_env.yaml,策略配置为 data/agents/deepmimic_g1_ppo_agent.yaml。G1 环境的默认参考文件是 data/motions/g1/g1_walk.pkl,单次 episode 时长为十秒,开启参考目标观测和随机重置。
环境配置分别列出 key_bodies 和 contact_bodies。前者标记用于追踪评价的头部、手腕与脚部等位置;后者列出允许与地面接触的刚体。更换为翻滚或侧手翻动作时,接触部位可能不同,官方配置也用注释展示了其他接触集合。
追踪奖励包含姿态、速度、根姿态、根速度和关键刚体位置。默认权重分别为 0.5、0.1、0.15、0.1、0.15,并具有各自误差缩放系数。关节误差还具有逐关节权重。
可以把这类奖励概括为 $r=\sum_iw_i\exp(-s_iE_i)$,其中 $E_i$ 是对应的平方误差,$s_i$ 决定误差增加时奖励衰减多快,$w_i$ 决定该分量的最大贡献。姿态相差应通过旋转角衡量,不能直接对四元数四项做普通相减;位置、角度和速度的不同单位也由各项定义与缩放处理。权重相加为 1 时,零误差的每步奖励上界为 1,但实际轨迹未必能实现所有参考量,累积回报还取决于持续步数。
用本配置关键点尺度 10 和权重 0.15 作量级案例:若根相对的关键点平方位置误差总和为 $0.01\,\mathrm{m^2}$,该项为 $0.15e^{-0.1}\approx0.135726$;误差总和增至 $0.09$ 时变为 $0.15e^{-0.9}\approx0.060985$。这里的误差是所用关键点的平方误差总和,不是每只脚都偏离 $0.1$ 或 $0.3$ 米。更低的速度误差可能补偿一部分位置奖励损失,所以单一回报不能指出机器人哪一部分追踪更好。控制与奖励复算脚本计算这些假设误差下的奖励,没有运行或评价学习策略。
pose_termination、姿态偏离阈值和早期终止决定哪些状态结束轨迹;rand_reset 决定是否随机化参考重置。
参考随机初始化使策略在训练早期就能访问片段中间和后半段的状态,避免必须先学会前半段才接触后面的目标;这是原始 DeepMimic 的 reference state initialization 思路。早期终止减少已经跌倒后无效挣扎的数据,也把失稳的后果放进学习问题。它改变训练分布与回报,不能在评测时随意关闭后仍用相同指标比较。随机参考状态下能追踪,未必说明从真实机器人的固定站立状态能够进入该运动;固定起点和运动切换需要另行评价。
Isaac Lab engine 配置使用位置控制 control_mode: pos,控制频率为 30 Hz,仿真频率为 120 Hz。实现要求仿真频率不小于控制频率,并能被控制频率整除;此时每个策略控制间隔推进四个物理步。
Isaac Lab 后端把位置模式命令传给关节位置目标接口;速度模式传给关节速度目标,力矩模式传给关节力目标。
位置模式的策略输出仍是目标位置,低层驱动把位置误差转成力矩。一个连续时间 PD 量级模型是 $\tau=k_p(q_d-q)-k_d\dot q$;但固定 Isaac Lab 后端的位置模式使用 ImplicitActuatorCfg,实际驱动由物理求解器处理,不能把下面的显式 PD 算术当作引擎内部精确积分公式。策略目标在四个物理步中保持,状态和接触仍每步变化,因此相同目标也会产生变化的作用力。第 05 章的增益、饱和与第 11 章的步长在这里共同决定闭环响应。
动作归一化器从环境的 Box 动作空间读取上下限,把两者中点作为初始均值、半个区间作为初始尺度。源码检查每个尺度严格大于零;若关节未开启限制,或边界没有非零宽度,会在这里触发检查。观测归一化器则按配置记录样本,更新均值和尺度,并把归一化观测限制在设定范围。
动作 Box 的边界应与模型机械限位区分。固定 CharEnv 为位置动作建立范围时,单自由度关节围绕所选中心扩展最大半宽的 1.4 倍;G1 配置启用 zero_center_action,中心取零。归一化器随后依据这个已经构造的 Box 计算尺度。因此不能直接使用机器人关节硬限位的中点和半宽重新实现策略接口。边界用于策略参数化和动作裁剪,模型约束仍负责实际运动限制;复制部署接口时应从保存配置和运行对象读取实际范围。
设教学关节的模型限位为 $[-0.6,1.0]\,\mathrm{rad}$,采用上述零中心单自由度规则,则动作 Box 为 $[-1.4,1.4]$,归一化输出 $z=0.5$ 对应目标 $q_d=0.7\,\mathrm{rad}$。若误用机械限位中点 $0.2$ 与半宽 $0.8$,会得到 $0.6\,\mathrm{rad}$,接口误差为 $0.1\,\mathrm{rad}$。若当前 $q=0.6$、$\dot q=-0.2$,教学 PD 增益 $k_p=40,k_d=2$,前一种目标请求 $4.4\,\mathrm{N\,m}$,假设力矩上限为 $3$ 则进入饱和。脚本复算这些自选关节参数;它们不是 G1 的实际限位、增益或力矩测量。
3.1 控制周期
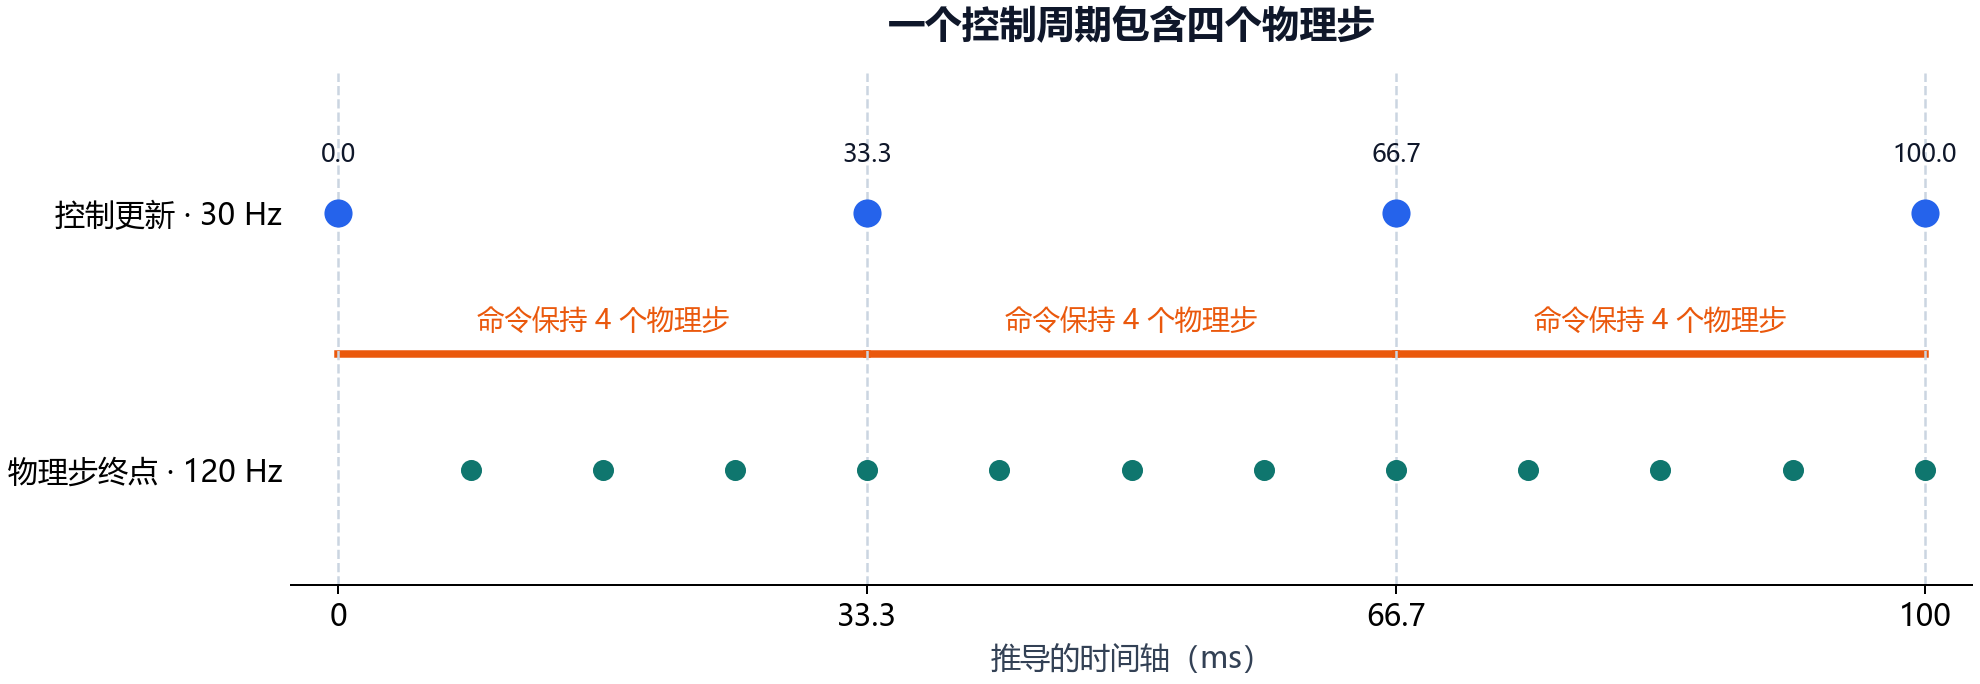
周期算例打印 4 个物理步、33.333 ms 控制周期和 8.333 ms 物理周期。位置目标在这些物理步中持续作用,下一次控制更新再使用新的机器人状态。
同一时间轴还有参考目标与观测延迟。固定环境按控制时间步解释 tar_obs_steps=[1,2,3],所以未来参考目标对应约 $33.333$、$66.667$ 与 $100\,\mathrm{ms}$;这不是未来传感器观测,而是已知参考片段的预览。如果实际推理加通信耗时 $12\,\mathrm{ms}$,它小于一个策略周期,却仍意味着控制依据更早的状态;恒定角速度 $2\,\mathrm{rad/s}$ 时,角度在此间变化 $0.024\,\mathrm{rad}$。复算脚本验证这个延迟量级。仅满足平均推理时间小于周期,还需检查最坏延迟和抖动,才能沿用训练时的反馈节奏。
4. 策略训练
官方示例使用 4096 个环境。
本章沿用官方 DeepMimic 训练参数,替换为 G1 配置与 Isaac Lab 后端,并加上有限样本预算和随机种子:
1 | python mimickit/run.py --mode train --num_envs 4 --devices cuda:0 --engine_config data/engines/isaac_lab_engine.yaml --env_config data/envs/deepmimic_g1_env.yaml --agent_config data/agents/deepmimic_g1_ppo_agent.yaml --visualize false --out_dir output/g1_walk_check/ --logger tb --rand_seed 0 --max_samples 1000000 --save_int_models true |
这是工作流检查预算。关闭 visualize 可以加快训练;可选 --video true 用于无窗口视频录制,并由日志器记录。
--engine_config 选择仿真后端,--env_config 选择任务与模型,--agent_config 选择学习算法,--out_dir 决定模型和日志位置。参数也可以放入 args/ 文件,与命令行参数按相同方式处理。
固定版本的 run.py 会在训练开始时复制 engine、environment 和 agent 配置到输出目录,分别命名为 engine_config.yaml、env_config.yaml 和 agent_config.yaml。
G1 的 PPO 配置使用两层、每层 1024 单元的 actor 和 critic。actor 输出初始缩放为 0.01,动作标准差类型为 FIXED,数值为 0.05;actor 与 critic 都使用学习率为 1e-4 的 SGD。折扣因子是 0.99,TD 的 $\lambda$ 为 0.95,PPO 裁剪比率为 0.2。
每次训练迭代先采集 32 个控制步,再构建训练数据和更新模型。默认每 100 次迭代输出一次模型,输出时测试 32 个 episode。训练循环按累计样本数判断是否结束;环境数增大时,同样的控制步数会收集更多样本。
本章四个并行环境每次采集 $4\times32=128$ 个状态—动作样本;32 个控制步对每个环境覆盖约 $1.067\,\mathrm s$ 的模拟时间,对应 128 个物理步。只按这个固定块计数,累计一百万样本至少需要 $\lceil10^6/128\rceil=7813$ 块,得到 1000064 个样本。真实运行还要按程序日志确认计数与终止时机,初始化、评测和更新均占墙钟时间,这个算术不能预测训练小时数。PPO 的一批数据在更新之后被下一批物理交互替代;它与第 13 章在固定示范文件上重复训练不同。
BaseAgent 把主要模型保存为 model.pt,日志保存为 log.txt;开启中间模型保存时,另建 int_models/。每到输出迭代或达到样本预算,执行测试、写日志并保存权重。
使用 TensorBoard 查看:
1 | tensorboard --logdir=output/g1_walk_check/ --port=6006 --samples_per_plugin scalars=999999 |
官方还提供 tools/plot_log/plot_log.py 绘制文本日志。
日志中的 Wall_Time 以小时记录,Samples_Per_Second 根据累计样本数和墙钟时间计算;Train_Return 与 Test_Return 分别来自训练和测试的回报跟踪器。它还记录两类 episode 长度、完成数量,以及观测归一化统计。
PPO 策略损失评价一次参数更新的代理目标,不能与追踪奖励直接视作同一量。回报上升还可能伴随 episode 延长,因此应同时看每步追踪误差与终止原因。一个持续十秒但一直偏离脚步位置的策略,与一个精准追踪两秒后跌倒的策略,单报总回报难以区分。可在独立评测配置启用追踪误差日志,记录每项物理误差和轨迹长度,再决定是否扩大预算;工作流检查没有给出这些实测结果,不能据此宣称已学会稳定步行。
分布式训练通过 --devices 指定多个设备,例如 --devices cuda:0 cuda:1。设备可以是 cpu 或 cuda:{i},多个设备让训练跨多个进程并行。
4.1 模型文件
输出目录应包含复制的三份配置、model.pt 和 log.txt;--save_int_models true 还会创建中间权重目录。模型与配置一起保存后,使用相同 G1 环境、agent 和 engine 加载,再检查测试回报与 episode 长度。生成权重文件只是流程输出,步行质量由推理执行决定。
5. 模型推理
用训练产出的 output/g1_walk_check/model.pt 加载策略。
1 | python mimickit/run.py --mode test --num_envs 4 --devices cuda:0 --engine_config data/engines/isaac_lab_engine.yaml --env_config data/envs/deepmimic_g1_env.yaml --agent_config data/agents/deepmimic_g1_ppo_agent.yaml --visualize true --model_file output/g1_walk_check/model.pt --test_episodes 8 --rand_seed 0 |
--model_file 指向 PyTorch 权重文件,--mode test 进入测试模式,--test_episodes 使评测具有有限结束条件。
无窗口评测可以把 --visualize true 改为 false,并增加测试 episode 数。源码输出 Mean Return、Mean Episode Length 和 Episodes,分别表示平均回报、平均轨迹长度和实际完成的 episode 数。
回报由第 3 节的多个追踪分量共同构成,episode 长度还受早期终止影响。
测试函数调用 eval(),把智能体与环境都切换到测试模式,并在 torch.no_grad() 中推进轨迹。并行环境分别完成最低数量的 episode 后才停止,避免只采集较短的轨迹而偏置均值。输出的实际 Episodes 因而可能大于请求数量。
model.pt 保存的是智能体的 state_dict。加载时使用目标设备的 map_location 恢复参数,随后同步优化器。这个文件适用于相同网络和归一化模块的加载;保存函数没有把训练迭代、经验缓冲区和完整优化器状态一起封装成恢复包。
因此加载成功首先检验网络与归一化张量匹配;精确续训还需要上述没有保存的运行状态。推理复现应固定机器人、参考片段、观测定义、动作缩放、控制频率和低层驱动,再保存实际测试种子与日志。更换机器人仍保持动作维度相同,也可能因关节排列或零位不同产生完全不同的命令。可视化参考角色通常不承受物理约束,判断政策效果必须观察受动力学驱动的机器人与记录的反馈状态。
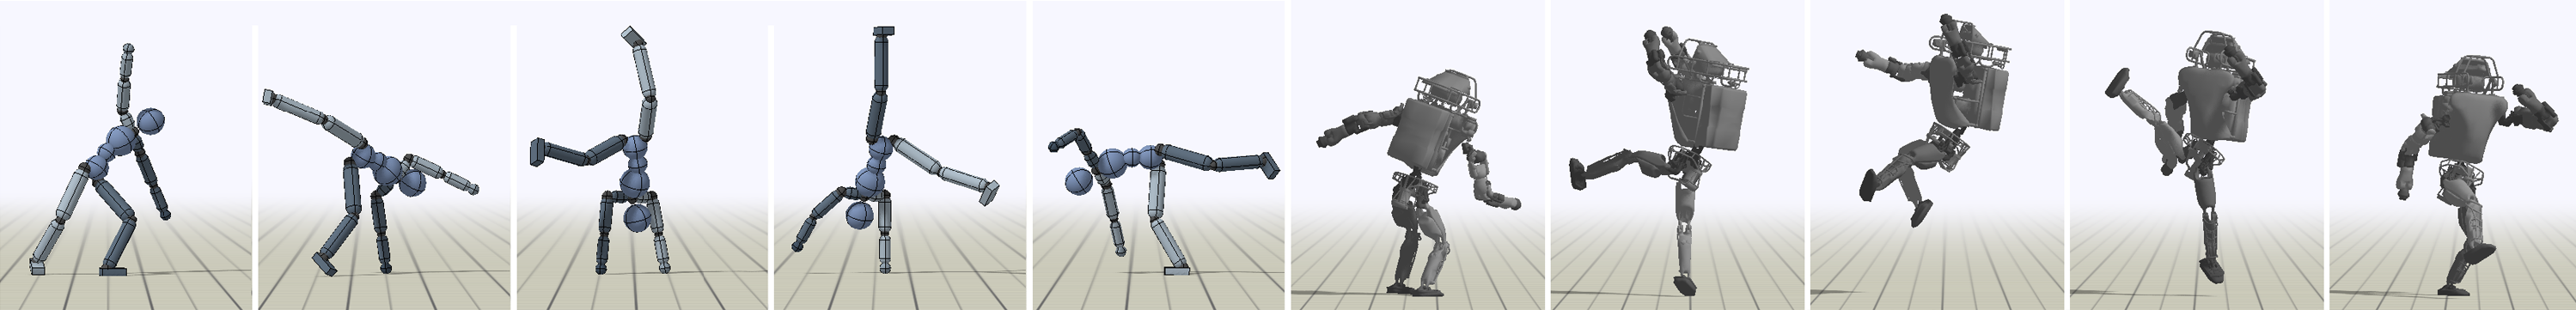
图 1:物理角色的运动控制示例。图中为角色模型,本章练习使用 G1;该图用于说明运动模仿目标。
官方资产包还包含预训练模型与对应日志。例如 humanoid 的 spinkick 模型配合对应 humanoid 环境和策略配置使用;它与本章 G1 配置不同。
6. 运动重定向
MimicKit 提供把 AMASS 中的 SMPL .npz 动作转换为其动作格式的工具。输入包含 poses、根平移 trans,以及 mocap_framerate 或 fps。工具执行坐标转换和格式处理,输出 Pickle 动作文件。
1 | python tools/smpl_to_mimickit/smpl_to_mimickit.py --input_file /path/to/input.npz --output_file data/motions/smpl/custom_walk.pkl --z_correction full --loop wrap |
转换参数支持截取起止帧、指定输出帧率、循环或截断模式,以及高度修正。calibrate 用前若干帧校准,full 使用整段运动;输出帧率不指定时保留源帧率。
SMPL 格式转换并不等于 G1 动作重定向。 SMPL 与机器人具有不同关节结构。MimicKit README 另外链接 GMR,并提供把 GMR 结果转为 MimicKit 格式的目录。
重定向可以理解为为每个参考时刻求机器人构型,使机器人关键点尽量接近人体关键点,同时保持关节限制、连续性和所需接触。人的腿长和机器人的腿长不同,简单复制膝角不能保持同样脚底位置;根位置也需结合足底接触重新求解。这与第 12 章 IK 相连,但多帧问题还要控制相邻解的速度和加速度。几何目标接近仅完成第一层检查,后续仍要看第 04 章动力学下的力矩需求。将动作整体加速两倍,在同一路径上速度变成两倍、加速度变成四倍,惯性力矩需求也随之显著增加。
该提交的 GMR 工具 README 中保留了旧脚本目录,本章以仓库实际脚本为准。转换命令为:
1 | python tools/gmr_to_mimickit/gmr_to_mimickit.py --input_file /path/to/gmr_motion.pkl --output_file data/motions/g1/custom_motion.pkl |
之后在独立环境配置中更新 motion_file,先运行 view_motion,再训练。
在转格式和重定向之间保留中间文件,能分清骨架映射错误与序列化错误。坐标轴、长度单位、根朝向、关节零位以及接触阶段应在转换记录中写明。改变循环模式还要检查首尾位置、方向和速度是否连续;跳变目标会让低层控制突然请求大力矩。查看正常后,短时仿真闭环可以确认模型与动作尺度,再进入完整训练。参考可播放本身不会证明人形能在地面上实现它。
7. 仿真迁移与实机接口
MimicKit 的 engine 接口包含读取根位置和方向、根速度、关节位置和速度、刚体位姿、接触力,以及设置命令和推进仿真。它还提供关节限制、力矩限制和 PD 增益等模型查询。不同后端在这一共同接口下完成模型创建与状态读写。
Isaac Lab 实现还显式建立“仿真内部顺序 ↔ 公共顺序”的刚体、关节与传感器索引。
跨仿真测试首先保留同一物理与控制语义,再逐项观察重力、摩擦、惯量、驱动增益、限幅与接触求解的差别。共同 engine 接口减少程序改动,不保证不同引擎产生相同轨迹。可以先比较静态零位、单关节响应和目标保持,再比较完整步行;若基础响应已经不同,直接比较整段回报难以定位问题。第 10 章的数据年龄与记录回放在真实接口中同样适用:策略输入应是经过约定坐标变换、在明确采样时刻获得的状态。
实机接口需要把传感器读数转换成策略要求的观测,再把模型输出转换成硬件控制命令。对于本章位置模式,目标是关节位置目标;归一化、零位偏移、关节顺序和低层控制配置必须与训练接口对应。LeRobot 的动作处理文档同样把反归一化、绝对/相对动作恢复和运动学转换作为明确处理步骤。
假设硬件在 $500\,\mathrm{Hz}$ 接收关节目标,而策略沿用 $30\,\mathrm{Hz}$,两个频率没有整数比,调度应按真实时间戳保持最新目标,不能固定每 16 个硬件周期调用一次后仍称为 30 Hz。策略还需要与训练一致的根方向、速度估计和参考预览;真实 IMU 的线性加速度不是直接的根速度。初始状态进入参考运动、超龄观测时的处理、驱动模式和命令限制,都属于闭环系统的一部分。只有这些接口在硬件上逐项核对,并取得真实反馈轨迹,才能把仿真策略称为完成实机验证;本章现有流程覆盖的是仿真工作流与迁移所需条件。
HumanPlus 提供了另一种具体桥梁:由人体动作训练低层跟随策略,通过机器人跟随人体采集示范,再训练任务技能。
MimicKit 的动作查看、仿真训练、模型保存和仿真推理需要与机器人驱动、状态估计和实机验证连接。实验记录应分别标明仿真闭环、跨仿真检查和真实部署的完成情况。
参考资料
Peng, X. B. MimicKit. README: Installation; Training; Testing; Motion Data; Motion Retargeting. Xue Bin Peng / MimicKit Contributors;中文节选重排,DeepMimic 原图保留;示例采用 Isaac Lab 与 G1 配置,增加采样预算和随机种子并校订转换路径;Apache License 2.0。
MimicKit Contributors. DeepMimic Instructions. Training and testing; G1 environment and agent configurations.
The Isaac Lab Project Developers. Installation Using Isaac Sim Pip Package. Python environment; Isaac Sim 5.1.0; Source installation; Verification. Copyright (c) 2022–2025, The Isaac Lab Project Developers;中文节选,安装选项精简为 --install none;BSD-3-Clause。
MimicKit Contributors. MimicKit Source. run.py; BaseAgent; Engine; IsaacLabEngine.
MimicKit Contributors. Motion Conversion Tools. SMPL and GMR conversion.
Hugging Face. Action Representations. Preprocessing and postprocessing. Copyright 2024 The Hugging Face team;中文节选动作接口定义;Apache License 2.0。
Fu, Z., et al. HumanPlus: Humanoid Shadowing and Imitation from Humans. CoRL, 2024. System overview.
Peng, Xue Bin, Pieter Abbeel, Sergey Levine, and Michiel van de Panne. DeepMimic: Example-Guided Deep Reinforcement Learning of Physics-Based Character Skills. ACM Transactions on Graphics, 2018. Reference motion tracking, reference state initialization and early termination. 新增理论联系;原始论文的角色与仿真设置不同于本文 G1/Isaac Lab 路径。
MimicKit Contributors. CharEnv; DeepMimicEnv. Fixed commit; expanded position-action bounds, target preview times and reward components. 新增模型限位与动作 Box 区分;自选关节 PD、奖励量级及采样预算为解析复算。