CH-09 机器人学习
让机械臂学会提起方块,可以让它尝试动作并根据任务结果改进,也可以先学习操作者完成任务的示范。两条路径都要把观测转成动作,但训练时可获得的信息不同:交互提供动作后果与奖励,示范提供专家选择。
前面的规划器通过模型比较动作,状态估计器把测量变成可用状态;学习策略则从交互经验或专家示范中建立动作规则。提起方块的奖励可以说明物体是否被抬起,示范则可以提供靠近、闭合和抬升的动作序列。需要先确定这些信息怎样进入训练,再选择强化学习、模仿学习或相应的动作生成模型。
下面先把提起方块的交互写成状态、动作与回报,再用两状态随机任务核对价值和数据更新。行为克隆部分讨论示范误差怎样在闭环中累积,动作表示与序列模型部分则继续追问:网络输出的向量怎样按正确单位、参考点和时刻变成机器人命令。
1. 智能体与策略
在机械臂提起方块的 Lift 任务中,策略根据相机图像,或末端、夹爪与物体的观测,输出机械臂和夹爪控制量。机器人内部的运动状态与策略能够看到的信息可能不同,因此首先需要区分状态、观测和策略。
交互由智能体和环境共同构成。每一步,智能体从环境获得观测,选择并执行动作;环境随后变化,返回新的观测与奖励。奖励评价当前结果,强化学习则根据累积奖励,也就是回报,改进动作选择。
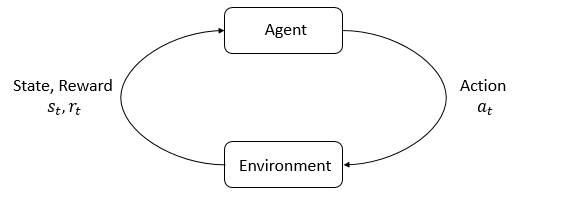
图 1:智能体—环境交互循环。动作影响环境,新的观测与奖励返回智能体。
状态 $s$ 包含决定世界后续变化所需的信息,观测 $o$ 则是智能体实际获得的描述,可能只覆盖部分状态。能够看到完整状态时,环境对策略完全可观测;只能看到部分状态时,则是部分可观测。
状态是否完整,要对照所选动力学模型判断。关节位置相同而速度不同,下一步位置通常不同,因此只保留位置未必满足马尔可夫性。相机单帧也可能缺少物体速度、遮挡后的姿态或夹爪接触信息。历史图像、上一动作与递归记忆可以补充这些信息,但仍需检查是否充分,并保持训练与部署中的历史长度和时间对应一致。
策略动作通过接口影响物理系统。输出关节目标时,底层位置控制器把目标转成力矩;输出力矩时,策略直接面对更低层动力学。一个学习时间步包含的底层控制步数也会改变动作效果。因此,状态、观测、动作接口和时间间隔需要一起定义,才能解释状态转移和学习结果。
阅读实现时,还要核对符号与可用输入。论文可能把 $s$ 写在本应使用 $o$ 的位置,公式以状态为条件,策略实际上却只能访问观测。
动作空间是所有有效动作的集合。有限个选项构成离散动作空间,机器人常用的实数控制向量则属于连续动作空间。算法需要适应这种结构,离散动作方法未必能直接用于连续控制。
策略规定如何根据输入选择动作。确定性策略写作
随机策略写作
参数 $\theta$ 可以是神经网络权重。确定性网络输出动作向量;随机策略则需要支持从动作分布采样,以及计算动作的对数概率。连续控制中常见的是对角高斯策略:网络输出均值,标准差可以是独立参数,也可以由状态相关网络预测。若 $z\sim\mathcal N(0,I)$,则采样为
为了便于优化,网络常输出可以取任意实数的对数标准差,再通过指数得到非负标准差。
对数概率同时依赖均值与标准差。采用状态相关标准差时,二者都由当前输入产生;采用独立可学习的对数标准差向量时,同一向量用于所有状态。两种方式都需要在训练的对数概率计算中保留各自的标准差参数。
幅值限制还会改变动作的概率分布。从高斯分布采样后用 $\tanh$ 映射到有限区间,计算对数概率需要变量变换 Jacobian;直接截断超限动作则有不同的概率结构。策略梯度与熵正则算法使用动作概率进行更新,因此保存的动作与计算的概率必须对应同一个采样、变换过程。
2. 马尔可夫决策过程
抓取要依次接近物体、闭合夹爪和抬升。前一步动作改变后一步观测,其误差还可能影响整个抓取结果。轨迹记录这一执行过程,回报评价沿途奖励的累积。
一条轨迹是状态与动作的序列:
初始状态从分布 $\rho_0$ 采样。状态转移可以是确定性的 $s_{t+1}=f(s_t,a_t)$,也可以是随机的 $s_{t+1}\sim P(\cdot\mid s_t,a_t)$。在马尔可夫决策过程的表述中,下一状态的分布只依赖当前状态与动作。动作则由策略产生。轨迹也常被称作 episode 或 rollout。
奖励可以依赖当前状态、动作和下一状态,即 $r_t=r(s_t,a_t,s_{t+1})$;一些环境使用只依赖状态或状态—动作对的形式。对于执行 $T$ 个动作的有限时域轨迹,无折扣回报是
无限时域的折扣回报是
折扣降低远期奖励的权重,并在适当条件下使无限求和收敛。实际深度强化学习有时用无折扣回报报告任务表现,在价值估计中使用折扣。评测与训练因而可能评价不同目标,阅读结果时需要分清二者。
随机策略与随机转移共同确定轨迹概率:
期望回报是 $J(\pi)=\mathbb E_{\tau\sim\pi}[R(\tau)]$,强化学习的目标是寻找 $\pi^*=\arg\max_\pi J(\pi)$。
状态空间、动作空间、状态转移、奖励与折扣因子共同定义 MDP。策略只接收到部分观测时,环境状态与策略输入仍需分别建模。
剩余时间也会影响有限时域任务的选择。同一位置在开始时可能适合探索,接近截止时则适合保守动作。可以用带时间下标的策略和价值表示这种差别,也可以把剩余时间放进状态。有限时域允许无折扣求和;无限时域的折扣目标通常还要求奖励有界等条件,才能得到有限回报。因此,折扣因子会改变任务对远期结果的评价。
采样结束时,要区分任务真正终止与长度截断。真正终止之后没有未来奖励,价值目标的后继项为零;达到采样长度而任务仍可继续时,是否自举取决于目标定义和剩余状态处理。混淆二者会使 critic 的价值目标产生系统偏差,再影响 actor 的动作评价。
3. 价值函数与 Bellman 方程
在夹爪接近方块时,当前奖励相同的两个动作也可能产生不同的后续结果。价值函数评价从这里继续行动的回报,优势则比较当前动作与该状态下策略的平均选择。
价值表示从一个状态或状态—动作对出发,随后按特定策略行动时能够得到的期望回报。$V^\pi(s)$ 从状态 $s$ 开始,所有动作都由 $\pi$ 产生;$Q^\pi(s,a)$ 则先执行指定动作 $a$,再遵循 $\pi$。最优价值函数 $V^*$ 与 $Q^*$ 对策略取最大值。
两类函数之间有联系:
当动作空间允许取得最大值时,最优动作可以通过最大化 $Q^*(s,a)$ 得到。价值函数因此既能评价行为,也能参与动作选择。
Bellman 方程把“从现在开始的回报”拆成当前奖励和后续状态的价值:
最优版本把未来动作的策略期望替换成最大化。
优势函数
表示在状态 $s$ 选择动作 $a$,相对于策略平均表现能好多少。它用该状态的平均回报作基准,使各动作的比较对应同一个起点。
若不显式讨论时间,以上价值函数通常指无限时域折扣回报。
3.1 可逐项核算的随机任务
考虑两个非终止状态 $A,B$。在 $A$,安全动作立即获得奖励 $2$ 并结束;前进动作付出 $0.5$ 的代价并进入 $B$。在 $B$ 只有尝试动作:以 $0.8$ 概率成功,奖励 $5$ 并结束;以 $0.2$ 概率失败,奖励 $-1$ 且仍停留在 $B$。终止状态价值为零,折扣因子取 $\gamma=0.9$。
失败后还可以重试,所以 $B$ 的价值需要计入后续尝试。它满足
在 $A$,前进的动作价值为 $-0.5+0.9V(B)\approx3.670732$,高于安全动作的 $2$,因此最优选择是前进。若当前随机策略只有四分之一概率前进,四分之三概率安全退出,则 $V^\pi(A)\approx2.417683$;两个动作的优势分别约为 $1.253049$ 与 $-0.417683$。按策略概率加权,它们的平均值为零,这正是优势以策略平均表现为基准的含义。
训练时通常从一次转移计算 Bellman 目标。在 $B$,成功样本的目标是 $5$,失败样本的自举目标约为 $-1+0.9\times4.634146=3.170732$;按发生概率平均,又得到 $4.634146$。失败样本奖励为负,长期目标仍可为正,因为任务允许重试。critic 需要拟合包含后继价值的目标,才能计入这部分未来回报。
将折扣改为 $0.4$,同样转移下 $V(B)\approx4.130435$,前进动作价值约为 $1.152174$,低于安全退出的 $2$。远期回报权重降低后,最优选择也随之改变。这个模型允许失败后重试;真实机器人若会因失败而掉落、损坏或终止,就需要相应改变转移与奖励。
在有限状态、折扣小于一的条件下,Bellman 更新会缩小价值函数之间的差异。两个输入函数相差至多 $\epsilon$,经过一次期望和折扣后,相差至多 $\gamma\epsilon$;取最大值也不会扩大这个上界,因此反复更新收敛到相应固定点。深度强化学习使用神经网络、有限数据与局部训练,计算条件不同,需要另行分析近似与训练误差。
4. 强化学习算法
提起方块的经验可以来自当前策略的新尝试、以前保存的轨迹,也可以来自模型预测。强化学习算法的区别,首先体现在怎样取得这些数据、怎样用它们评价和更新动作。
无模型方法直接从经验学习动作或价值,不使用环境转移模型来规划。基于模型的方法拥有或学习状态转移与奖励模型,再用模型比较候选动作,形成计划。提前预测可能提高样本效率,但策略也可能利用学习模型的偏差,在预测中获得高回报,实际执行却失败。
在无模型方法中,策略优化显式表示 $\pi_\theta(a\mid s)$,直接优化性能目标或其局部近似。Q 学习则训练 $Q_\theta(s,a)$ 满足基于 Bellman 方程的目标,再用它选择动作。策略优化与价值学习并不互斥:Actor–Critic 同时学习选择动作的 actor 和评价行为的 critic。SAC 使用随机策略及熵正则化;PPO 使用限制更新幅度的替代目标。
On-policy 更新使用当前策略采集的数据,off-policy 方法还能使用其他或较早策略产生的数据。复用经验提高了数据利用率;同时,离策略数据与函数近似、自举结合时,价值学习可能不稳定。
能否复用数据,要看更新所需的分布。普通 on-policy 策略梯度对当前采样分布求期望,混用旧策略动作时需要处理分布差异。离策略 critic 可以从经验回放中的转移学习,但未被数据覆盖的动作价值主要依赖外推。
例如,离线数据中某个抓取动作从未出现,网络预测的高价值就缺少执行证据。继续按这个估值选择动作,会进一步放大误差;因此数据覆盖仍是复用经验时需要检查的条件。
PPO 使用新旧策略的动作概率比 $\rho_t=\pi_\theta(a_t|s_t)/\pi_{\mathrm{old}}(a_t|s_t)$,并在替代目标中裁剪,以减少单次更新偏离采样策略过远的倾向。实现需要保存采样时的对数概率与优势,并保持动作变换一致。裁剪限制的是更新激励,它不保证每次真实回报都提高,也不提供物理安全保证。任务回报与约束满足情况仍需通过执行评估。
SAC 把奖励与策略熵结合,通过离策略 critic 和随机 actor 共同优化。熵系数调节探索与回报的取舍,经验回放复用数据,但未覆盖动作的外推误差仍需处理。原始 PPO 与 SAC 论文分别给出了这两种更新结构。
PPO 的替代目标比较 $\rho_t\widehat A_t$ 与 $\operatorname{clip}(\rho_t,1-\epsilon,1+\epsilon)\widehat A_t$,取二者较小值再平均。优势为一、概率比为 $1.4$、$\epsilon=0.2$ 时,该样本的贡献限制为 $1.2$;优势为负一、概率比为 $0.6$ 时,贡献取 $-0.8$。这种单侧限制减弱了继续沿当前优势过度改变概率的激励;它作用于目标函数,没有把整个策略锁在硬概率区间内。
基于模型的学习可以使用第 06 章的规划方法。学习到的转移模型生成候选轨迹,也可以在每次观测后用于 MPC。只执行短段再重新观测,能够增加纠偏机会,但模型偏差仍影响每次动作选择。实际选择需要同时考虑样本效率、规划耗时与预测误差。
先考虑有限时域无折扣回报。对于随机参数化策略,利用对数导数技巧,可以把期望回报的梯度写成
环境不依赖策略参数时,可以通过动作对数概率求梯度,无需对转移函数求导。用有限条采样轨迹的平均估计期望后,就可以更新策略。下面再说明如何去掉与当前动作无关的回报,以及如何用基准降低估计方差。
梯度估计的方差会影响有限数据下的更新质量,因此还需要选择合适的回报权重。
梯度中的回报为动作对数概率提供权重。整条轨迹回报是合法权重,但当前动作无法改变已经发生的奖励;去掉这些奖励可以减少不必要的方差。因此,权重可以换成从当前时刻开始的 reward-to-go,即 $\sum_{t'=t}^{T-1}r_{t'}$,仍给出同一目标的无偏梯度估计。
状态基准也用来降低方差。对只依赖状态的 $b(s_t)$,$\mathbb E[\nabla_\theta\log\pi_\theta(a_t\mid s_t)b(s_t)]=0$,所以减去它不会改变期望梯度。实际算法常用神经网络拟合状态价值,再比较当前动作的后续回报与这个状态通常能获得的回报。基准的拟合质量影响估计方差,任务奖励则保持不变。
推导从轨迹概率开始:对 $J=\int P_\theta(\tau)R(\tau)d\tau$ 求导,用 $\nabla P=P\nabla\log P$,环境转移不含 $\theta$ 时只剩策略对数概率的和。过去奖励与当前动作的条件得分期望为零,因而可以删除,只保留未来回报。若目标改成从起点计量的折扣和,则权重必须相容地写为 $\sum_{t'\geq t}\gamma^{t'}r_{t'}=\gamma^t\sum_{t'\geq t}\gamma^{t'-t}r_{t'}$。局部折扣 return-to-go 与外层时间权重不能混用;实现采用何种状态采样分布,也会影响公式的表达。
5. 行为克隆
有了操作者完成 Lift 的示范后,可以把示范中的观测与动作作为监督数据。训练得到的策略再放回环境,根据新观测选择动作;行为克隆由此把已有操作数据接到反馈控制中。
行为克隆 BC 监督学习观测到动作的映射。robomimic 提供普通 BC、采用高斯混合动作分布的 BC-GMM、VAE 策略,以及 RNN 或 Transformer 时序版本。这些方法用不同模型表达多模态动作和历史信息,监督目标都来自示范。扩散动作头同样可以用于行为克隆,生成模型的形式与训练信号来源需要分别区分。
随机策略也可以使用示范动作的负对数似然。这里的监督来自数据集中的动作,而不是策略尝试后得到的任务奖励。
部署时,预测动作改变后续观测,小误差可能把策略带入示范覆盖不足的状态,再产生更大偏差。DAgger 让学习策略运行,向专家查询所访问状态的动作标注,再聚合数据重新训练。它通过迭代收集数据调整训练状态分布,因此需要能够查询专家。
示范拟合与闭环执行需要分别评估。训练误差和验证误差衡量数据中的观测到动作预测,闭环成功率衡量策略执行后产生的任务结果。
平方误差行为克隆学习示范动作的条件均值。同一观测下若有两种有效绕行方向,平均动作可能指向中间的障碍;分布模型可以保留多个动作模式。
动作标签还应对应专家实际发出的目标或命令。底层延迟、柔顺与跟踪误差会使目标不同于机器人的实际运动,因此记录数据时需要区分二者。
用一维模型看闭环漂移:$x_{t+1}=x_t+a_t$,任务是在零点附近保持位置。若示范主要停留在 $x=0$,学到的策略在部署时每步错误输出 $0.02\,\mathrm m$,十步后位置偏到 $0.2\,\mathrm m$;这些新状态未必在训练集里出现。若恢复数据使策略学到 $a=-0.8x+0.02$,误差变成 $x_{t+1}=0.2x_t+0.02$,从零开始逐步收敛到 $0.025\,\mathrm m$。恢复反馈抑制了累积,却没有消除动作偏置;低示范误差与良好闭环稳定性仍是不同要求。
DAgger 收集学习策略所访问状态上的专家标注,从而扩展训练分布。能否安全查询、专家能否及时给出恢复动作,以及标注与状态是否时间对齐,决定了这种数据收集能否实施。离线成功示范对部署失败与恢复状态的覆盖,需要单独检查。
5.1 示范划分
Lift PH 数据包含 200 条成功示范;按数据工具教程的 0.1 验证比例,条数应为 180 条训练、20 条验证。这里划分的是整条示范,实际轨迹名单由 mask/train 与 mask/valid 指定。
1 | num_demos, validation_ratio = 200, 0.1 |
这些条数描述监督数据规模。训练后的策略能否稳定完成示范任务,还需要通过第 13 章的 rollout 评估闭环成功率。
整条轨迹划分可以避免把同一次操作的相邻帧同时放进训练和验证,使验证主要考察未见轨迹。若要评估新物体、新场景或新操作者,就需要按相应条件划分。成功示范适合监督成功动作,但部署失败概率仍需要闭环评估,并明确初始化分布、执行时长与成功判据。
6. 机器人动作表示
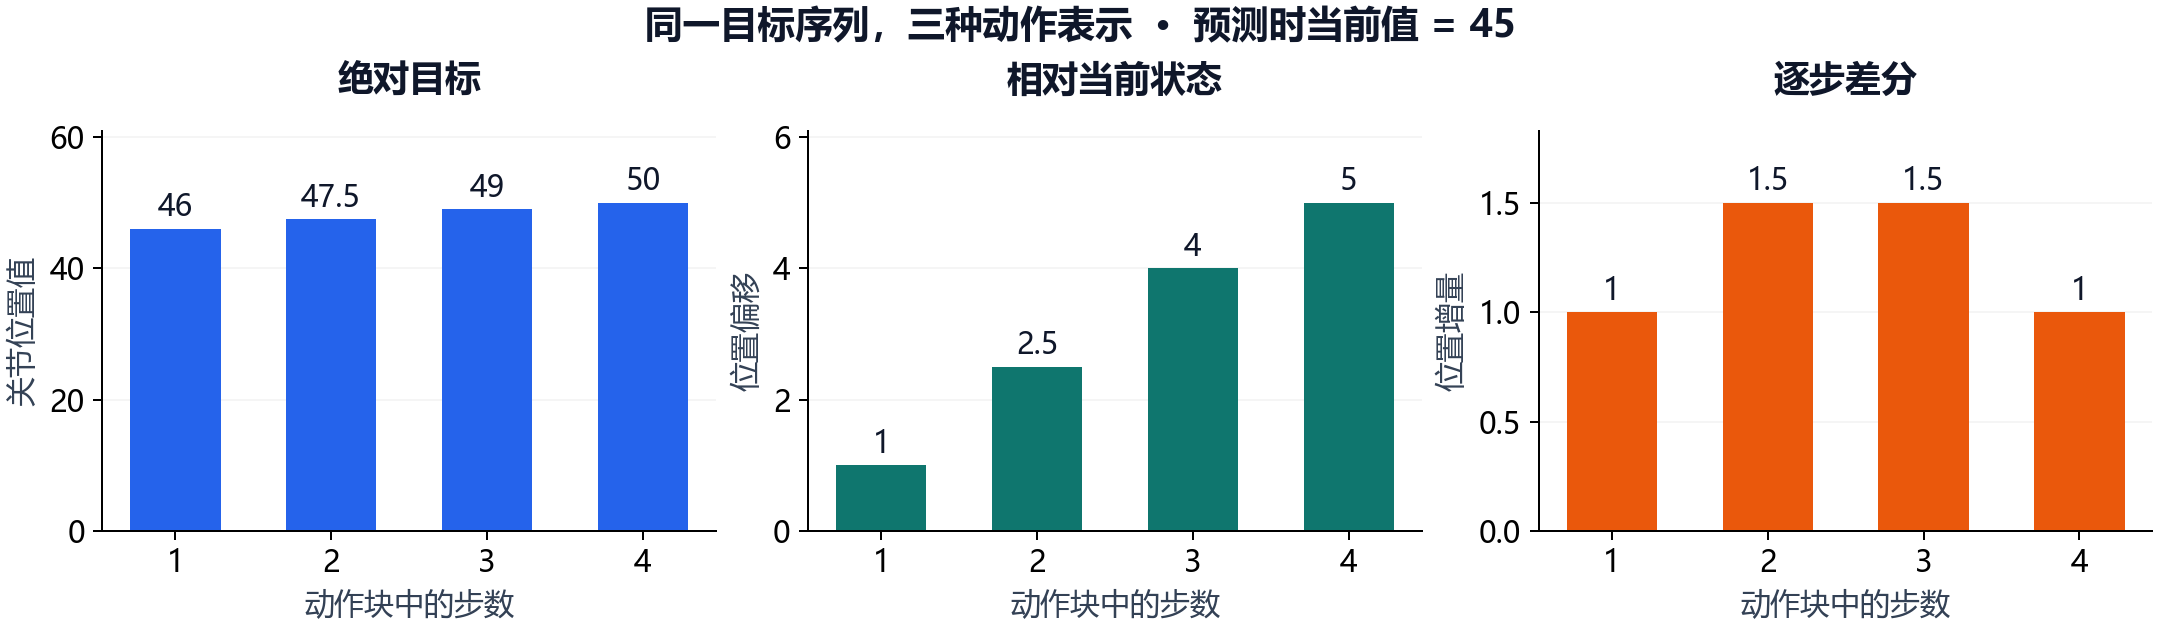
机械臂收到 [1, 1.5, 1.5, 1] 这样的动作块时,必须先知道每个数是目标位置、相对于当前状态的偏移,还是相对于上一个目标的差分。下面沿用同一组关节目标比较三种接口。
动作首先需要指定控制空间。关节空间动作给出各电机的目标位置,便于转换成电机命令;末端空间动作给出工具尖端的笛卡尔位置和姿态,需要运动学模型转换成关节目标。LeRobot 用 URDF 与正、逆运动学处理步骤完成这种转换。
选定空间后,还需要定义位置的参考方式。绝对动作直接给出目标;相对动作使整个动作块都以预测时的当前状态为参考;逐步差分动作使每一步以上一个动作为参考。差分表示需要逐步累加,预测误差也可能在恢复目标时累积。
例如,当前关节角为 $45$,一段绝对目标为 $[46,47.5,49,50]$。共同参考当前状态的相对序列是 $[1,2.5,4,5]$,逐步差分序列则是 $[1,1.5,1.5,1]$。两者虽都像“增量”,参考点却不同,不能交换使用。
动作表示的转换需要在训练与推理中对应。训练前处理可以按“原始绝对动作 → 相对动作 → 归一化”进行;推理后处理则按“反归一化 → 恢复绝对动作 → 必要时逆运动学”进行。恢复时应使用生成动作块时缓存的状态,夹爪等指令还可以配置为保持绝对表示。
归一化控制数值尺度,坐标空间确定物理量,参考方式确定目标从哪里量起。这三项需要分别配置;向量形状相同,仍可能代表不同命令。
本节单关节数值可以按角度理解,实际接口应明确使用度还是弧度。若逐步差分的每个预测都有 $0.1^\circ$ 同方向偏差,恢复四步后位置误差依次为 $0.1^\circ,0.2^\circ,0.3^\circ,0.4^\circ$;共同参考当前状态的相对表示,在每个输出也有 $0.1^\circ$ 偏差时,每个目标误差都仍是 $0.1^\circ$。前者有累加传播,后者则对生成动作块时的状态误差更敏感。表示选择改变误差传播方式,没有一种接口自动消除预测误差。
生成动作块时缓存的参考状态,要在解码整块时保持一致。当前角度为 $45^\circ$ 时预测相对块,执行两步后机器人虽已移动,剩余相对量仍指向原来的参考;重新加到新角度会把目标再次平移。需要按新状态调整时,应重新查询策略并生成新块。末端姿态增量还要约定左乘或右乘及表达坐标系,旋转矩阵不能按普通位置逐元素累加。
6.1 动作恢复
用代码核对第一个关节的恢复结果,能在接入执行器之前发现参考点错误:
1 | absolute = [46.0, 47.5, 49.0, 50.0] |
配套算例还保留三关节、四个动作步的完整原始数值,并打印两种恢复结果是否一致。
7. 动作序列模型
动作序列模型一次预测多个未来控制步,把相邻动作的关系放进同一个输出。机器人执行后仍需读取新观测,因此动作块的参考方式、执行长度与更新频率,共同决定它怎样进入反馈循环。
ACT 从多相机图像提取视觉特征,结合当前关节位置和潜变量,再通过解码器的交叉注意力生成未来动作块。训练学习潜变量,推理使用零潜变量;块预测直接表示连续动作之间的关系。动作块长度与重新观测频率则需要按执行任务选择。
原始 ACT 使用条件 VAE 训练。训练专用的潜变量编码器读取当前关节观测与示范动作块,输出潜变量分布;动作生成网络结合图像、关节状态与潜变量重建动作块,用 KL 项约束分布。部署时使用先验均值零,无需未来示范。潜变量编码器负责示范的隐变量表示,策略内部的 Transformer 编码器负责视觉条件,两者承担不同工作。
原论文还对重叠动作块中属于同一执行时刻的预测做时间集成,以减小块间跳变。动作块长度与反馈延迟需要结合任务一同确定。
动作块怎样执行,会改变闭环反馈的频率。预测未来二十步后,可以全部执行,也可以执行若干步就读取新观测;提前更新通常增加纠偏机会,同时增加推理开销。快速接触变化可能使旧观测下的远期动作失效。时间集成也要先统一物理时刻和参考方式,再平均对应目标。
Diffusion Policy 把视觉条件下的动作生成表示为去噪扩散过程,并结合动作序列预测和滚动执行。它是一种表达多模态动作分布的方法。LeRobot 的扩散实现还明确区分训练中的实时权重与指数移动平均 EMA 权重,评测时应确认加载了哪一种权重。
扩散模型的学习变量是一整段动作向量。以常见噪声预测形式为例,训练从示范块 $a^{(0)}$ 和噪声层级 $k$ 构造 $a^{(k)}=\sqrt{\bar\alpha_k}a^{(0)}+\sqrt{1-\bar\alpha_k}\varepsilon$,网络在观测条件下预测加入的噪声,用 $\mathbb E\|\varepsilon-\varepsilon_\theta(a^{(k)},o,k)\|^2$ 训练。推理从随机噪声开始,逐层去噪得到动作块,再滚动执行其中一部分。去噪层级是生成计算的索引,与机器人实际控制时刻不同。
取归一化干净动作 $1$、$\bar\alpha=0.25$、噪声 $0.4$,加噪结果约为 $0.846410$。知道噪声时,可以按上述关系还原动作一;实际网络根据加噪动作与条件估计噪声,因此恢复是近似的。条件分布的不同样本能够表达多种有效动作,得到的动作块仍需检查关节限位、碰撞与接触力。去噪步数影响推理时间,也要与反馈周期一起评估。
视觉、语言与动作模型 VLA 将语言指令与视觉观测结合,生成机器人动作。SmolVLA 把多相机观测、传感运动状态和语言编码为上下文特征,再以这些特征条件化生成动作块的动作专家。用于具体机器人时,预训练模型仍需要相应任务数据与接口适配。
语言为动作选择提供任务条件,预训练表示可能帮助理解物体与指令的关系。输出动作仍要按目标机器人的单位、关节排列、坐标变换与底层控制解释。模型输出越接近低层物理输入,评估越需要同时检查任务成功、约束违反、动作频率和恢复能力。
MDP、优势、动作偏差与去噪核验脚本逐项检查两状态任务的 Bellman 固定点、优势零均值、折扣改变策略,以及动作恢复偏差与加噪还原。
把策略部署到机器人上,还需要把观测、动作和执行时刻落实为数据接口。后续系统与实验章节将继续检查这些对应关系,让训练中的任务定义与实际执行保持一致。
参考资料
OpenAI. Spinning Up: Key Concepts in RL. States and Observations; Policies; Trajectories; Reward and Return; Value Functions; Bellman Equations. Copyright (c) 2018 OpenAI;中文节选重排与符号统一,agent–environment 图保留原图;MIT License。
OpenAI. Kinds of RL Algorithms; Intro to Policy Optimization. Model-Free vs Model-Based RL; Policy Optimization; Policy Gradients.
Stanford Vision and Learning Lab. robomimic: Implemented Algorithms. Imitation Learning. Copyright (c) 2021 Stanford Vision and Learning Lab;中文节选;MIT License。
Ross, S., Gordon, G., and Bagnell, D. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011. Abstract and DAgger method.
Hugging Face. Action Representations; ACT; SmolVLA. Action spaces, relative actions, model overview. Copyright 2024 The Hugging Face team;中文节选重排、公式与例题补充;Apache License 2.0。
Chi, C., et al. Diffusion Policy: Visuomotor Policy Learning via Action Diffusion. RSS, 2023; IJRR, 2024. Method overview.
Stanford Vision and Learning Lab. PH Datasets; Filter Keys. 200 demonstrations; 10% validation example.
Schulman, John, et al. Proximal Policy Optimization Algorithms. 2017. 裁剪概率比替代目标与采样策略的关系。
Haarnoja, Tuomas, et al. Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor. ICML, 2018. 随机 actor、离策略 critic 与最大熵目标。
Zhao, Tony Z., et al. Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware. RSS, 2023. Section IV: ACT 的条件 VAE、动作块和时间集成机制。
Ho, Jonathan, Ajay Jain, and Pieter Abbeel. Denoising Diffusion Probabilistic Models. NeurIPS, 2020. 前向加噪与噪声预测目标;本章标量去噪数值为独立计算。