CH-11 人体动作与机器人运动控制
一段在数字人体上自然播放的行走或搬运动作,未必能由人形机器人直接执行。例如,相同的手部目标可能超出机器人的臂展,相同的步态也可能需要超过驱动器上限的力矩。人体序列通常提供姿态与轨迹等运动学观测,未给出实现这些运动的驱动信号;机器人连杆比例、关节轴、质量分布和接触条件又与人体不同。因此,人体动作与真实执行之间还需要形态对应和动力学控制两个环节。
人体动作经过 Retargeting(运动重定向),可成为机器人的运动参考,规定期望姿态、空间轨迹与时间过程;运动控制再根据状态估计与参考计算驱动输出,使实际运动跟踪目标。运动学生成、形态 Retargeting 与闭环控制分别处理行为分布、机器人配置空间中的几何对应,以及受接触和驱动器约束的执行。本章沿这条链路展开,先建立状态空间与 Retargeting 约束,再引入浮基动力学、全身控制与学习策略,最后讨论参考追踪、遥操作及真实设备反馈。
1. 人体与机器人的状态空间
人体与机器人采用不同的结构和参数定义,因此 Retargeting 首先需要建立两者状态空间中的对应关系。人体参数模型可能同时包含根位姿、身体关节、手指和形状参数,机器人则以刚性连杆、运动关节及驱动器描述结构。自由度数量、旋转轴顺序、关节零位和运动范围均可能不同,因此人体关节参数与机器人关节角通常不存在逐元素对应。
设机器人有 $n_a$ 个受驱动自由度,未固定于环境的基座称为Floating Base(浮动基座)。机器人的配置空间可写为
其中 $\mathrm{SE}(3)$ 描述基座位置与朝向,$\mathcal Q_a$ 描述受关节类型和机械限位约束的内部配置;广义速度 $v\in\mathbb R^{6+n_a}$ 属于该配置流形的切空间。四元数用四个数存储三维旋转,因此配置数组与速度数组维度可以不同,积分必须保持单位四元数或等价的旋转流形约束。
人体参考使用帧索引 $t\in\{0,\ldots,T-1\}$,采样间隔 $\Delta t=1/f$;策略决策使用 $\ell$,底层伺服循环使用 $j$。三者通过物理时间戳关联,不能把一帧 motion、一次策略前向和一次力矩更新视为同一个时间步。下文动力学中的点号表示对物理时间求导。
关节名称相同也不意味着可以直接复制数值。例如,一个数据集用父关节局部轴表示人体旋转,机器人模型可能使用另一组轴与零位。需要先校准坐标、参考姿态与关节对应,再使用机器人的正向运动学检验端点位置。
Retargeting 目标需要体现任务相关的优先级。具体到不同任务,挥手侧重手部轨迹与风格,行走侧重足部支撑与根运动,搬运还要求保持手–物接触。形态差异可能使全部人体关键点同时匹配不可行,此时应优先保留与任务成功直接相关的几何关系。
进入控制阶段后,当前状态本身也需要估计。关节编码器能够提供内部角度,却不能单独确定躯干在世界中的位置;惯性测量存在偏差,足接触判断也会受地面与噪声影响。控制策略接收的是传感器或估计器输出,训练时直接使用仿真真值会减少这一难度。真实设备中的追踪因而同时受控制策略与状态估计精度影响。
2. Retargeting 中的几何对应与约束求解
Retargeting 根据机器人的连杆形态、关节结构和机械限制,求解能够保留人体目标动作的机器人配置序列。设人体目标关键点为 $p^h_{t,i}$,机器人正向运动学为 $f_i(q_t)$。将关键点匹配与时间平滑组合起来,可以得到一个运动学目标:
其中 $e_{t,i}$ 是第 $t$ 帧对应关键点的位置残差,$q_t$ 是该帧的机器人配置,$\tilde p^h$ 是经过坐标与尺度转换的人体目标,$w_i$ 控制各目标关键点的重要性,$\lambda$ 控制时间平滑强度。$d_{\mathcal Q}$ 是配置空间上的距离。关节角可采用局部欧氏差分,基座旋转则使用 geodesic distance(旋转流形上的测地距离,以两个朝向之间的最小旋转角衡量差异);不能直接将四元数元素差视为完整旋转误差。优化还需满足关节限位、碰撞与指定足接触等约束。
以二连杆手臂为例,较短的机器人手臂可能无法到达人手的世界目标位置。整体缩放目标能够保留相对姿态,却会改变手与桌面或物体的接触位置。环境接触通常需要保持实际世界尺度,因此不能对所有坐标无条件等比例缩放。
Retargeting 是多目标约束优化:末端位置、根高度、姿态风格和关节限位可能互相竞争。除空间对应外,时间参数化也属于可行性的一部分;将持续时间扩大为原来的 $\alpha$ 倍,沿同一几何路径的速度与加速度分别缩放为 $1/\alpha$ 和 $1/\alpha^2$。这会降低惯性项,却不会同比降低重力支撑需求,也不自动保证接触切换相容。形态、时间与动力学因此需要联合分析。
2.1 ASAP 中的人体关键点匹配与参考生成
ASAP 的 Retargeting 先拟合人体形状与整体比例,再选择人体关节和机器人连杆的对应。完成形态与连杆对应的校准后,人体模型恢复世界关键点,机器人正向运动学把关节角和根变换映射到对应连杆位置;优化器最小化二者的平均位置差,同时更新关节角、根朝向与根位置偏移。
每次更新后将关节角截断到机械限位,并对时间序列做平滑。最终通过机器人表面确定地面高度,保存根运动、关节自由度与朝向参考。关键点匹配解决形态对应,限位和平滑解决参考的几何与时间一致性,这些步骤输出机器人配置随时间变化的运动参考,后续控制器再根据实际状态计算驱动力。
运动学 Retargeting 以参考的几何相容性为目标,动力学可行性还取决于速度、加速度、可用驱动力和接触力。相同姿态序列在不同时间尺度下可能需要显著不同的力矩;固定足部位置的几何约束也不能保证地面能够提供所需支撑。
3. 浮动基座与接触动力学
3.1 欠驱动结构与质心动量
机器人以关节驱动器产生内部力矩,通过外部接触改变整体动量。将重力以外的非接触外力暂时省略,多体动力学为
$M\in\mathbb R^{(6+n_a)\times(6+n_a)}$ 为惯性矩阵,$h$ 包含重力与速度相关项,$\tau\in\mathbb R^{n_a}$ 为关节力矩,$\lambda$ 汇总接触力或接触 wrench(包含力与力矩的六维合力向量),$J_c$ 是接触 Jacobian,将广义速度映射为接触点速度。选择矩阵 $S$ 的前六列为零,说明基座六维自由度没有直接执行器。这种 Underactuation(欠驱动) 要求基座运动与关节驱动、外部接触共同满足动力学方程。设 $P_b=[I_6\;0]$ 提取浮基行,则
这六个方程不能通过任意指定关节力矩独立满足。关节动作可以改变构型、惯性与接触受力,但基座轨迹必须与整体动量平衡一致。把根平移当作可直接执行的位置命令,会忽略系统的欠驱动结构。
以总质量 $m$、质心位置 $c$ 与关于质心的角动量 $L_G$ 表示整体运动,Newton–Euler 方程进一步写成
$g$ 为重力加速度向量,$f_i,\nu_i$ 为接触点处的力与力矩,外部力矩 $\nu_{\mathrm{ext}}$ 统一取关于质心的值。关节内部作用在全系统动量平衡中相互抵消。例如,腾空时若仅有重力,质心沿弹道运动,质心角动量守恒;内部关节运动仍可重分配各连杆角动量并改变身体朝向。接触雅可比描述外部接触如何映射为广义力,整体运动还必须计入重力及其他外力。
3.2 接触相容性与驱动器限制
固定环境中持续黏着的接触满足速度和加速度相容条件
接触面的运动不为零时,应在相对速度下写约束。法向间隙 $\gamma_i$ 与压缩法向力满足 $0\leq\gamma_i\perp\lambda_{n,i}\geq0$,切向力满足库仑锥 $\|\lambda_{\parallel,i}\|_2\leq\mu_i\lambda_{n,i}$。位置、速度与力必须共同相容:脚部世界位置固定,不意味着地面一定能提供所需切向力。滑动阶段需要摩擦方向定律,触地瞬间还需冲量和速度重置,不能把持续接触的加速度方程直接跨越碰撞使用。
能够实现的运动还受到驱动器最大力矩、角速度、功率和热负载限制。参考轨迹需要的力矩超过硬件上限时,仅提高追踪误差的权重无法使该运动成为可执行动作。对于位置控制接口,策略通常输出关节位置或偏移,由 PD 环生成力矩:
其中 $q_a,v_a$ 是受驱动关节的位置和速度,$K_p,K_d$ 是位置与速度反馈增益,clip 按关节限制力矩上下限。PD 将局部位置和速度误差转成驱动力,饱和则使闭环偏离未饱和线性近似。过高增益可能增大碰撞冲击或激发未建模柔性,过低增益又可能无法及时抵抗负载。参考速度、反馈周期、增益和可用力矩共同决定追踪误差的可控范围。
3.3 Whole-Body Control 的约束优化
Whole-Body Control(WBC,全身控制)把末端、质心和姿态任务转成满足动力学的瞬时控制。给定当前状态和已确定的接触模式,令第 $i$ 个任务的期望加速度为 $a_i^{\mathrm{des}}$,其加速度残差为
这里 $J_i$ 是任务 Jacobian,将机器人广义速度 $v$ 映射为任务空间速度,即 $\dot y_i=J_i v$。将任务残差与控制正则共同最小化,得到一种 inverse dynamics(逆动力学)优化形式:
这里 $\|e\|_{W_i}^2=e^\top W_i e$,权重 $W_i\succeq0$,正则系数非负;$\mathcal K_{\mathrm{poly}}$ 为单侧力与摩擦锥的保守多面体近似。若直接以足底 wrench 为变量,该集合还需包含 Center of Pressure(CoP,压力中心)和扭转摩擦限制。关节限位和速度界可通过局部离散动力学加入线性化约束。在当前状态固定、接触集合已知时,决策向量 $[\dot v;\tau;\lambda]$ 进入二次目标和线性约束,形成 QP;保留精确圆锥摩擦条件则通常得到带二阶锥约束的问题。接触模式同时未知时,互补关系引入额外非凸性,不能再视为同一个凸 QP。
任务目标可由期望轨迹及状态反馈构造。例如,对任务位置 $y_i$,将参考加速度与位置、速度误差组合为
控制器根据新的状态估计更新 Jacobian 和动力学矩阵,优化器随之重新分配关节力矩与接触反力,由此形成持续的反馈修正。硬约束优先保证模型内的可行性,任务残差承担参考之间的冲突;模型误差、不可行接触日程和求解延迟仍可能使真实系统偏离预测。
3.4 ZMP 与动态支撑的适用范围
在水平共面接触、总法向力 $F_z>0$ 的情形,Zero-Moment Point(ZMP,零力矩点)是使接触合 wrench 的水平力矩分量为零的平面点。取地面为 $z=0$,关于原点的合接触力矩为 $m_O$,ZMP 坐标为
绕竖直轴的力矩不要求为零。
仅考虑重力与地面接触时,由质心动量平衡可得
此式中的 $g>0$ 为重力加速度大小。进一步假设质心恒高 $c_z=h$、$\ddot c_z=0$ 且角动量变化可忽略,才得到线性倒立摆关系 $x_{\mathrm{ZMP}}=c_x-(h/g)\ddot c_x$。它将水平加速度与支撑位置联系起来,解释了质心投影位于足底之间仍可能发生动态失稳。
非负法向压力使平面 CoP 位于有效接触区域的凸包内;在上述接触假设下,ZMP 与 CoP 重合。ZMP 位于支撑多边形内是模型中的必要条件,仍未检查切向摩擦、偏航力矩、关节力矩和未来可恢复性。非共面支撑、抓扶墙面与飞行阶段需要更一般的接触 wrench 可行集合,不能直接沿用平面支撑多边形判据。
4. 动作先验与任务奖励
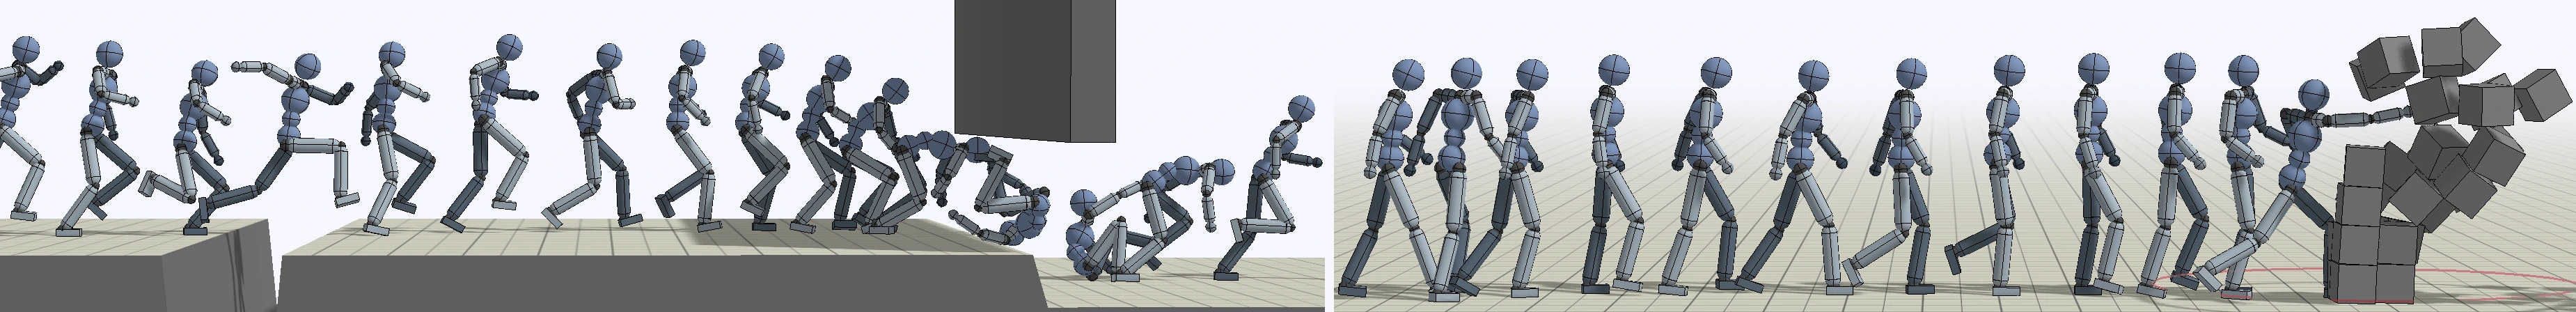
满足动力学约束并到达同一目标的运动通常不唯一,步态、肢体协调与运动风格还需要额外指定。人体数据既可以提供逐帧参考追踪目标,也可以提供行为分布上的动作先验。AMP 采用后者:判别器比较数据与策略产生的状态转移,以相似程度构造 style reward,并与前进或到达目标等 task reward 共同训练物理模拟角色。
令 $\xi,\xi'$ 为相邻物理状态,$\Phi$ 提取用于判别的运动特征,$D(\Phi(\xi),\Phi(\xi'))$ 给出转移分数。AMP 的最小二乘判别目标使用真实目标值 $1$、策略目标值 $-1$,对应风格奖励为
奖励式中的 $D$ 是判别器对当前状态转移输出的原始分数,$w_g,w_s$ 分别控制 task reward 和 style reward 的贡献;该分数没有经过 sigmoid,因而不表示概率。输入特征包括根速度、关节运动和末端状态等信息,使 style reward 约束局部运动统计;task reward 则约束任务进展。
Motion capture 数据提供运动学示范,通常不包含肌肉或驱动器控制信号。AMP 通过物理仿真采样控制后果,用对抗奖励将这些示范转化为策略学习信号,从而学习能够产生相似运动统计的控制动作。
style reward 约束转移分布,task reward 约束任务回报;二者的最优策略未必一致。例如,狭窄环境中的收臂避障与数据中的大幅摆臂,分别对应任务可行集合和风格高密度区域。增大风格权重可能将策略推离任务需要的状态,且仅有相邻转移的匹配不足以保证长时语义顺序。因此,数据条件覆盖与奖励分解共同决定组合行为能否维持任务进展。
下图中,越障目标促使策略连续组织跳跃、翻滚和起身,出拳目标则改变接近路径与身体朝向。控制动作由物理状态与任务共同决定,运动先验提供局部转移统计;这种分工使同一示范集合能够支持多种任务条件下的行为组合。
5. 大规模参考追踪与失败恢复
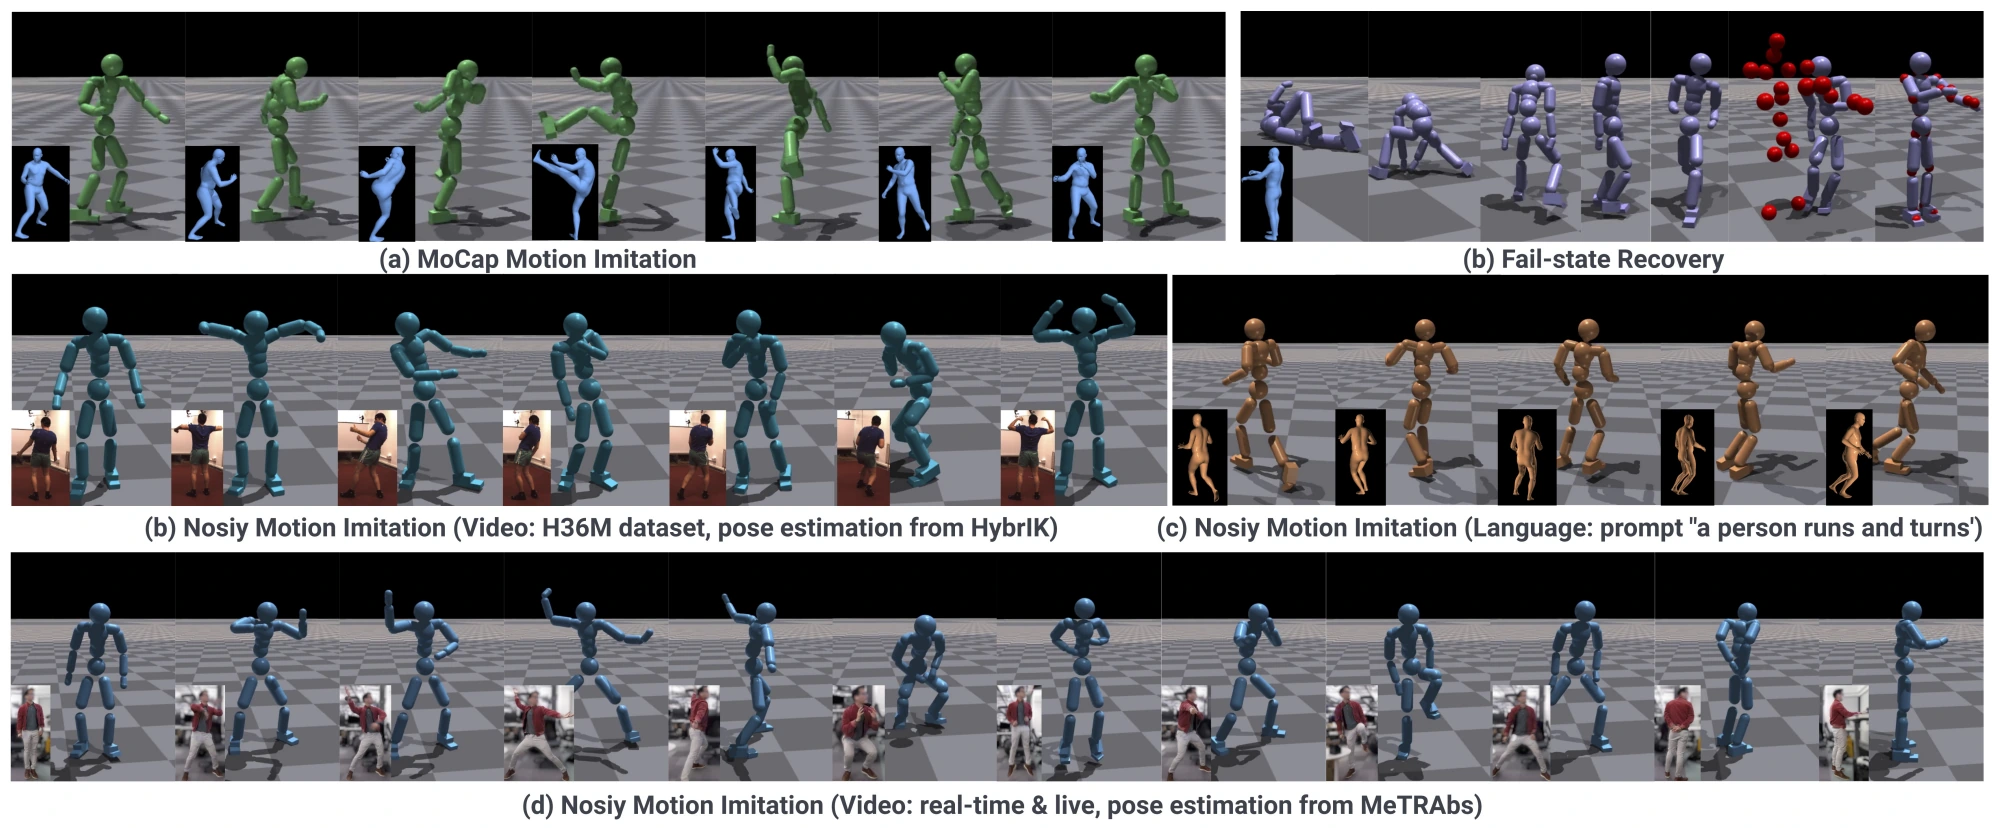
执行指定动作需要参考条件下的精确追踪。PHC 在大规模动作数据上训练实时模拟人体控制器,采用 progressive multiplicative control policy(PMCP)逐步增加策略容量,将后续 primitive 分配给尚未掌握的困难片段,再通过组合策略协调已有能力。独立学习的恢复行为扩展了倒地等偏离参考状态下的控制范围。
参考追踪策略可以抽象为
其中 $\xi_\ell$ 为第 $\ell$ 次策略决策的当前状态,$t_\ell$ 根据时间戳定位参考帧,$\mathcal R_\ell$ 为未来参考窗口。策略决策频率与参考帧率可以不同,因此参考通常需要在配置流形上插值。追踪奖励评价关节或关键点位置、速度、朝向及根运动,控制惩罚约束执行代价;与分布层面的风格匹配相比,该目标显式依赖参考相位。
参考误差需要在正确坐标下评价。仅对齐根位置后计算局部关节误差,会隐藏整体漂移;仅计算世界关键点,又可能把轻微整体偏移与严重姿态错误混在一起。局部姿态、根轨迹和世界末端误差分别保留了这三个层次的信息。
参考附近的低误差训练只能覆盖局部吸引域。倒地、错误接触和较大根偏移改变可行的恢复路径,可能要求先偏离参考再重建支撑。PHC 通过困难样本和恢复经验扩展状态覆盖,使策略有机会返回可追踪区域;有限测试中的恢复成功仍不能等同于全状态空间的稳定性保证。
PHC 首先处理物理模拟人体,其追踪与恢复机制可用于设计后续机器人的 RL Tracking(通过强化学习训练参考追踪策略)。机器人具有不同的自由度、质量分布与驱动器,参考状态、动作输出和环境转移都要随形态改变。
参考质量和初始状态会改变追踪难度。下图既包含 motion capture 参考,也包含视频估计与文本生成参考;倒地恢复一项则检验控制器能否在大幅偏离目标后重新进入可追踪状态。
6. 遥操作接口与仿真现实对齐
参考追踪接口也可以接收实时的人类输入,形成遥操作:操作者持续提供目标,机器人利用自身反馈执行。OmniH2O 用人体运动学姿态作为统一的全身控制接口,连接不同人类输入方式与人形机器人。人体姿态先经过 Retargeting,控制策略再利用机器人实际可获得的观测维持执行。
OmniH2O 先训练能够读取完整仿真状态的 privileged teacher,再将其行为蒸馏到只使用可部署观测的 student policy。Teacher 利用完整状态降低追踪学习难度,student 通过本体感知与历史观测推断隐含状态,从而满足真实设备的观测限制。
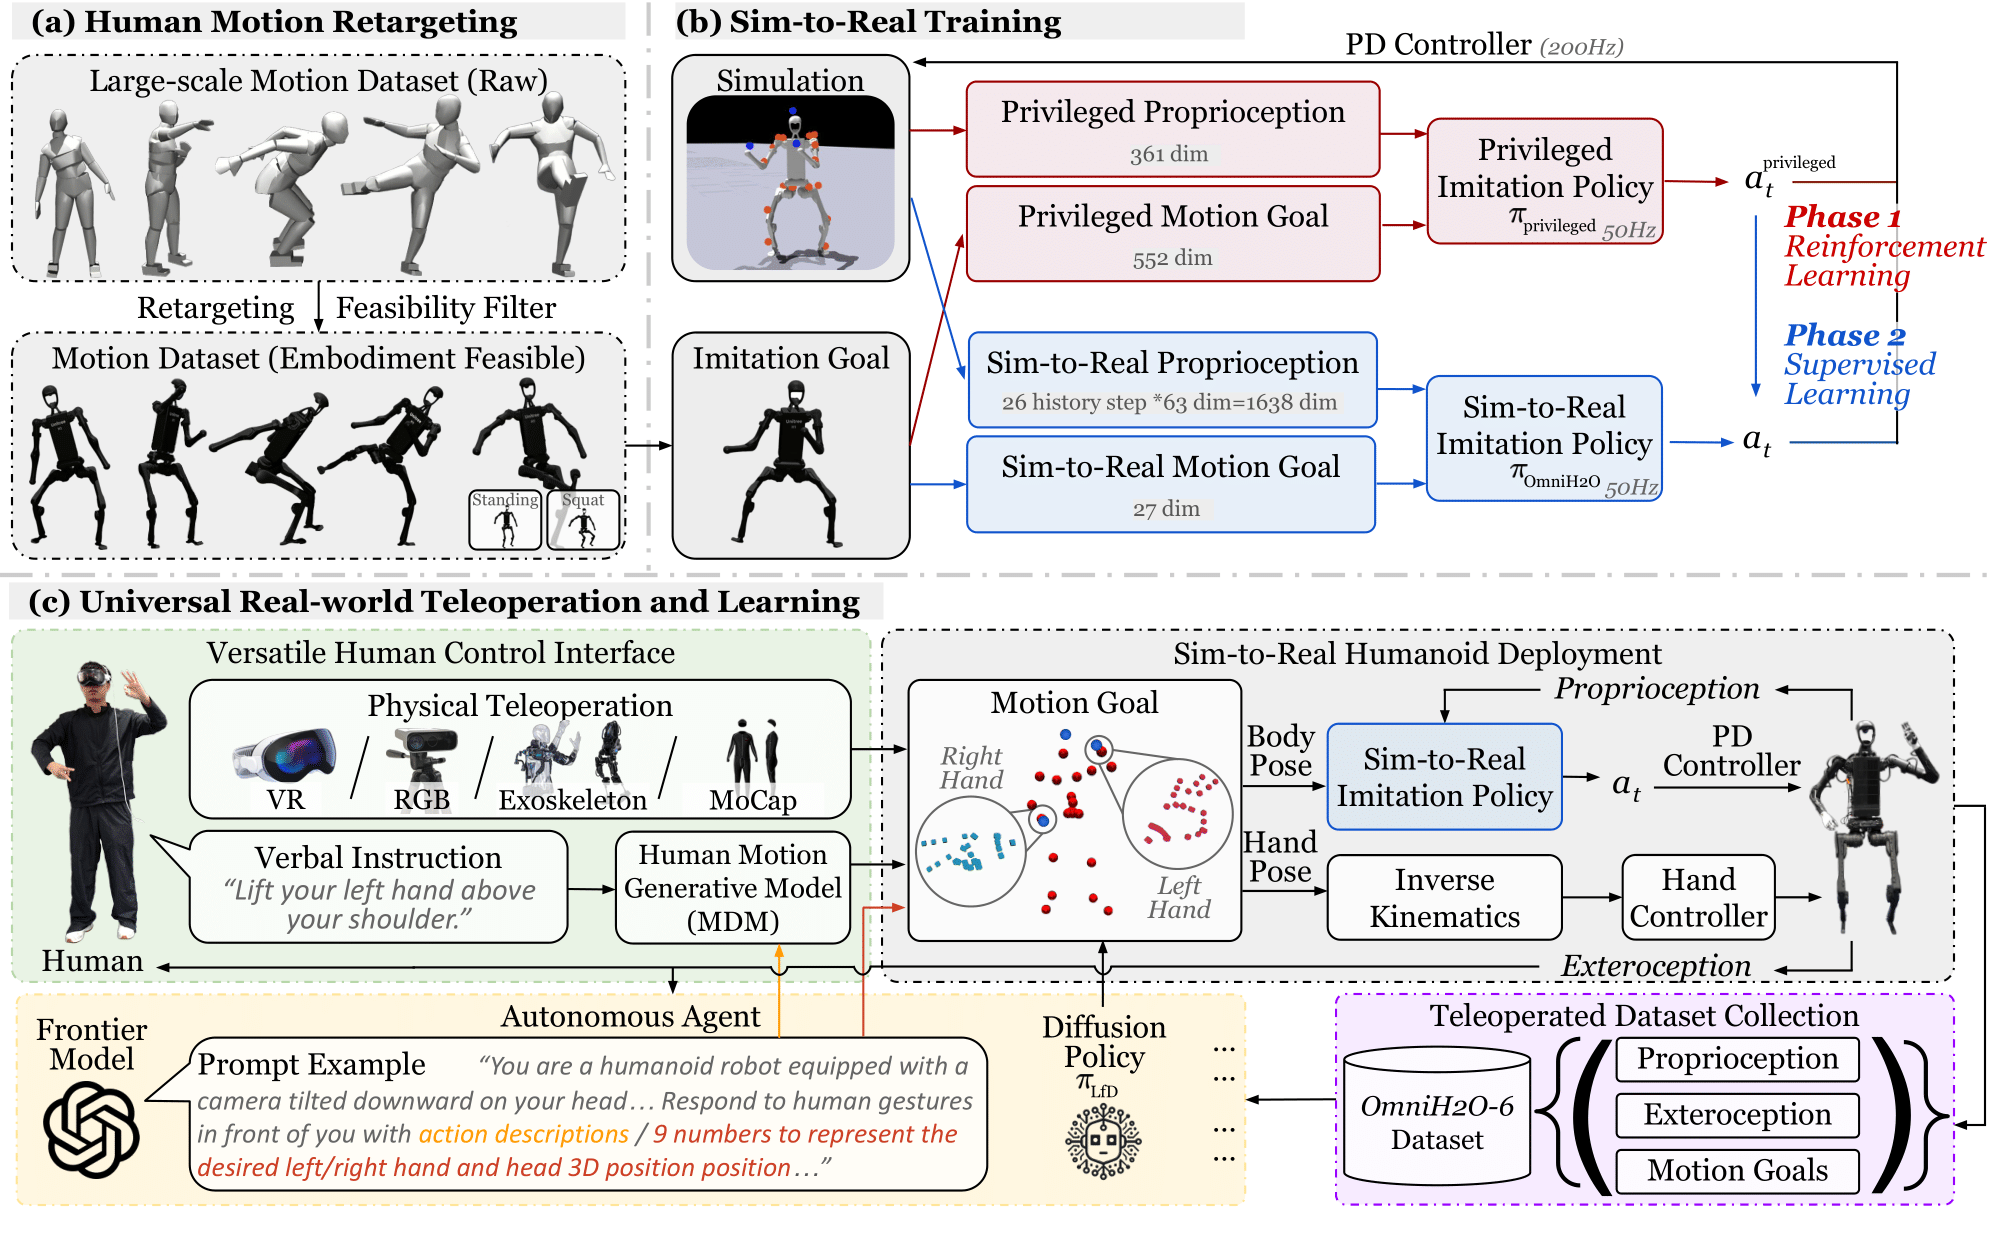
遥操作持续接受人类反馈,也可以产生后续任务学习所需的机器人演示。追踪器将姿态目标落实为运动,操作者负责目标修正;自主策略则需要从观测中承担这部分决策。演示质量与自主任务成功对应这条链路中的不同阶段。
6.1 ASAP 的观测输入、策略网络与关节动作
以 ASAP 的 23 自由度 G1 配置为例,部署策略的单步观测包含基座角速度三维、投影重力三维、关节位置与速度各 23 维、上一动作 23 维,以及一维参考相位,共 76 维。加上四步历史,输入为 $[B,380]$。历史观测为策略提供近期运动与控制响应的信息,参考相位则表示当前应跟踪到动作的哪一阶段。
策略采用 $380\to512\to256\to128\to23$ 的 MLP,隐藏层使用 ELU。输出是 23 维关节位置偏移,经缩放加到默认关节姿态上,再由 PD 控制器产生截断力矩。价值网络具有独立参数,并可读取基座线速度与参考关键点等特权信息;这些额外状态辅助训练,策略输入仍保持部署可得的观测。
训练采用 Proximal Policy Optimization(PPO)。其中,状态转移由仿真器给出,追踪奖励评价参考误差,控制惩罚约束动作代价;价值网络估计回报,策略网络按裁剪概率比目标更新:
其中 $o_\ell$ 为策略观测,$r_\ell$ 为新旧策略对同一动作的概率比,$\hat A_\ell$ 为估计的 advantage(相对于基准状态价值的收益),$\epsilon$ 控制裁剪区间。PPO clipping 限制过大的概率比给目标函数带来的额外收益,缓和策略更新幅度;它并不对新旧策略距离施加严格硬约束。参考定义追踪误差,仿真转移提供控制动作在当前动力学下的实际后果。
6.2 Delta Action Model 与仿真响应对齐
相同观测与动作接口下,仿真和真实设备仍可能具有不同转移动力学。ASAP 先在仿真中预训练追踪策略,再根据真实执行轨迹学习 Delta Action Model(预测动作空间修正量的模型),以残差动作修正仿真响应。最后,在对齐后的仿真中微调策略,可将真实系统的响应差异引入训练。
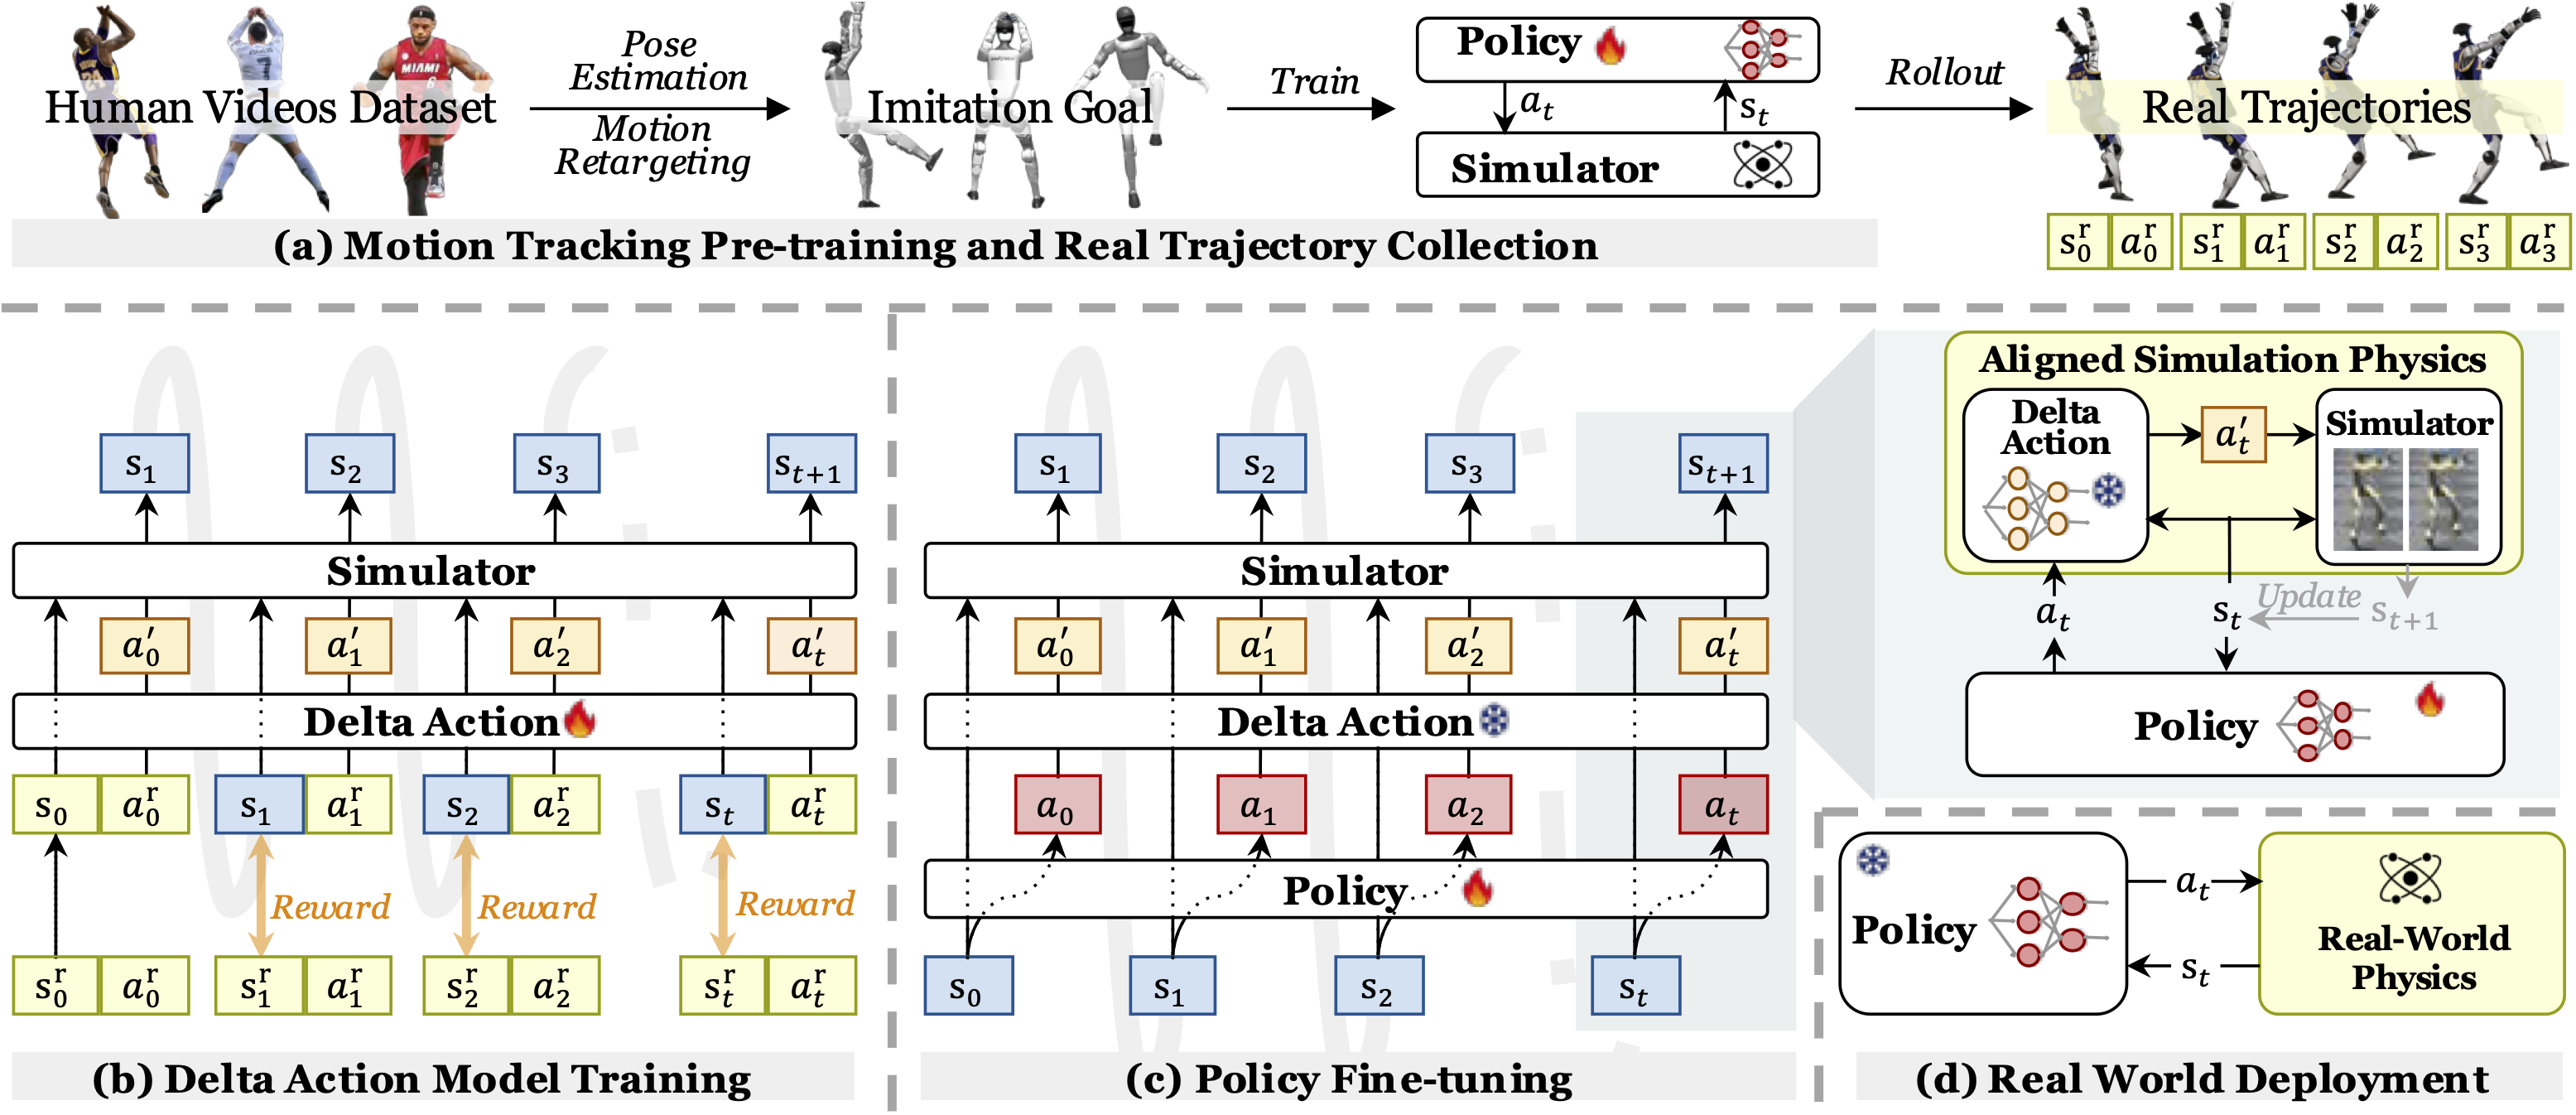
设真实策略轨迹记录为 $(\xi_\ell^r,a_\ell^r)$,残差模型根据仿真状态和记录动作产生 $\Delta a_\ell$,仿真器执行 $a_\ell^r+\Delta a_\ell$。训练以真实状态轨迹为匹配目标,并限制残差动作大小;它修正的是动作空间中的响应差异,而不是直接重写人体参考。
Delta Action Model 训练完成后保持固定,新的追踪策略输出 $a_\ell$,对齐仿真使用 $a_\ell+\Delta a_\ell$ 产生下一状态。策略在这个环境中继续学习,逐渐适应真实设备的响应。最终部署只运行优化后的追踪策略与设备反馈,残差模型承担训练中的仿真对齐。
动力学差距可能来自电机响应、摩擦、质量估计、关节迟滞与控制延迟。Domain Randomization(在训练中随机改变仿真参数)让策略适应一组动力学变化,数据驱动对齐则尝试描述真实设备中观测到的差异。两者都依赖合理的数据范围;没有观测到的高速状态、负载或地面条件,仍可能超出已学模型。
真实数据的时间对齐影响残差模型学到的内容。电机响应与传感器延迟会使控制动作和观测状态错开;配对错误时,模型可能用相位补偿解释误差。因此,时间同步与动力学对齐需要共同处理。
7. 运动追踪接口与任务语义闭环
可追踪行为范围扩大后,同一底层控制器可以接收来自遥操作、运动生成器或任务策略的参考。SONIC 通过扩展运动数据、网络容量与训练计算规模学习通用全身追踪,并利用统一控制接口连接不同上游目标。其核心输出仍为满足机器人动力学的控制行为,上游参考则承担任务与空间条件的组织。
任务闭环基于环境状态与执行结果更新运动目标。以苹果取放为例,视觉定位提供对象与容器状态,操作策略确定抓取和放置目标,运动追踪器执行参考;接触失败或目标移动后,上层策略需要修正后续计划。任务成功因而由对象状态转移定义,无法仅用关节追踪误差衡量。
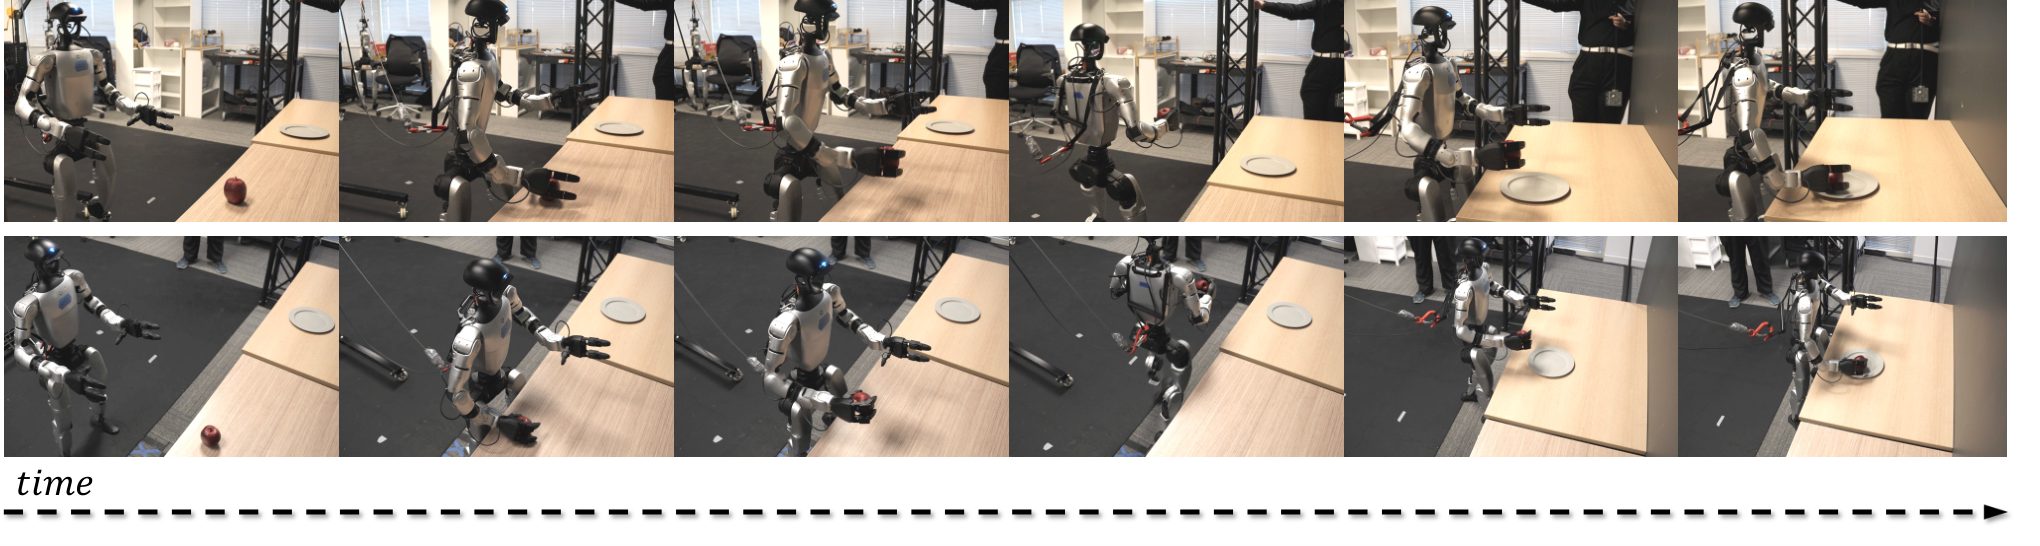
低层反馈由本体感知与接触估计修正执行误差,高层反馈由对象状态与任务进展更新参考。对象移动改变抓取目标时,任务层需要先更新手部轨迹;低层控制器只能在可执行集合内追踪该轨迹。较低的关节误差并不蕴含正确的对象状态转移,任务规划与运动追踪这两个反馈回路,需要共享时间戳、目标版本与接触状态,才能避免执行器继续追踪已经失效的参考。
真实部署还需要处理输入噪声、动作切换、能耗、接触安全和设备故障。例如,在姿态空间中过渡平滑的两段参考,可能具有不兼容的足接触或很大的速度差。动作选择接口应检查当前物理状态与下一段参考的起点,避免控制器在不合理条件间强行追踪。
地形与负载变化同时影响规划与控制。具体而言,台阶要求更新足部落点和抬脚高度,额外负载改变惯性与支撑力分配;这些信息需要进入参考规划和控制状态,使落脚位置、运动速度与驱动输出随执行条件调整。
8. 算例:形态差异与可达性
为了观察连杆长度改变后能否保留原手部目标,可以先考虑平面二连杆。其末端可达性具有解析条件:目标半径必须满足 $|l_1-l_2|\leq\|p\|_2\leq l_1+l_2$。人体代理的两段长度均为 $0.5$ 米,机器人代理均为 $0.35$ 米;比较复制关节角与保持世界目标,可直接检验形态相似性和任务空间约束是否相容。
1 | import numpy as np |
运行结果:
1 | 机器人能否到达原世界目标: False |
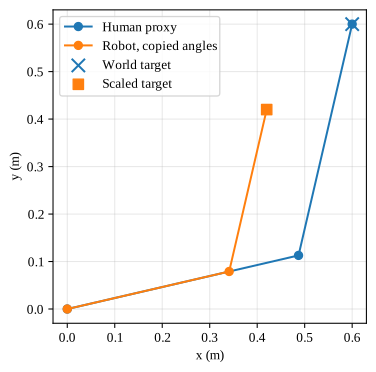
原目标半径约为 $0.849$ 米,超过机器人 $0.7$ 米的最大臂展,因而不存在固定基座的逆运动学解。缩放将目标移到 $(0.42,0.42)$,恢复形态相似却改变环境接触位置。任务要求保持世界目标时,需要扩展可用配置自由度,例如移动基座或调整躯干;优化器不能在既定几何可行集合之外通过降低残差权重创造可达解。
9. 算例:摩擦与动态支撑条件
末端可达性只限制几何配置,动态支撑还限制加速度。取共面地面、恒高点质量与可忽略的质心角动量变化,第三节的动量方程退化为线性倒立摆近似:
在这一简化模型中,零力矩点需处于支撑区间,水平力也需落在摩擦范围内。以下计算展示:重心投影保持在区间中央,并不能让任意水平加速度都可行。这些约束描述该恒高近似下的动态支撑条件。
1 | import numpy as np |
运行结果:
1 | a=0.5: Fx=25.0 N, ZMP=-0.045872 m, friction=True, support=True |
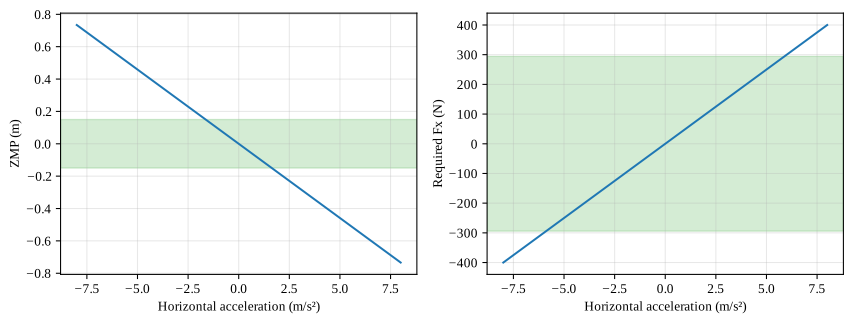
恒高模型同时要求 $|\ddot c_x|\leq\mu g$ 与 $|c_x-(h/g)\ddot c_x|\leq b$,其中 $b$ 为支撑区间半宽。两组不等式的交集才是该降阶模型的可行加速度集合:$2\,\mathrm{m/s^2}$ 满足摩擦却违反支撑范围,$8\,\mathrm{m/s^2}$ 同时违反两者。降低质心、改变角动量或迈步会改变系数、假设或接触集合;完整 WBC 的作用是在这些自由度与驱动约束之间求相容分配。
10. 追踪、恢复与任务执行的评价
控制评价连接参考与执行结果。局部关节误差衡量姿态,根轨迹误差衡量整体运动,世界末端误差衡量手足是否到达目标;力矩饱和、能耗和接触滑动则反映实现这些轨迹的代价。一个控制器可能保持很小的局部姿态误差,同时发生根漂移,因此各项误差需要保留各自的坐标含义。
参考追踪、受到扰动后的恢复与完成物体任务,是三个不同层次。恢复取决于策略是否见过偏离参考的状态,任务成功还取决于感知、对象状态与重规划。低层反馈修正关节和姿态,高层反馈修正目标与行为,两个闭环共同决定系统在变化环境中的能力。
10.1 多率闭环与参考时序
高层参考刷新、策略网络决策和关节伺服反馈,可以按不同频率运行;它们分别影响计划更新、控制目标输出和传感误差修正。作为说明性量级,高层规划或参考更新可工作在 20–50 Hz,而关节 PD 或力矩伺服可工作在 500–1000 Hz;实际频率由硬件、通信与策略设计决定,不能将这一范围作为所有系统的共同配置。策略网络本身还可能采用独立的中间频率。
令墙钟时间为 $\vartheta$,策略周期为 $\delta_\pi$、伺服周期为 $\delta_c$。第 $j$ 个伺服时刻 $\vartheta_j=j\delta_c$ 读取最近的策略目标,持续使用新测量状态计算反馈。参考帧则根据 $t\Delta t$ 的时间戳插值,而非按每个伺服周期递增一帧。保持或插值的位置目标与持续更新的反馈必须分开:高层目标暂时不变时,底层力矩仍可响应扰动。
较高伺服频率减少采样造成的反馈滞后,但无法消除过期目标、不可行接触切换或感知延迟。参考缓冲必须保留足够的未来轨迹,同时在目标变化后允许修正尚未执行的片段;否则更平滑的播放可能伴随更迟的任务响应。在这种多速率系统中,时间同步需要使参考位置、参考速度和接触模式对应同一个物理时刻。仅增加控制循环次数,无法修正上游参考与当前状态之间的时间错位。
参考资料
Xue Bin Peng, Ze Ma, Pieter Abbeel, Sergey Levine, and Angjoo Kanazawa. AMP: Adversarial Motion Priors for Stylized Physics-Based Character Control. ACM Transactions on Graphics, 40(4), 2021.
Zhengyi Luo, Jinkun Cao, Alexander Winkler, Kris Kitani, and Weipeng Xu. Perpetual Humanoid Control for Real-time Simulated Avatars. In Proceedings of the IEEE/CVF International Conference on Computer Vision, 2023.
Tairan He, Zhengyi Luo, Xialin He, Wenli Xiao, Chong Zhang, Weinan Zhang, Kris M. Kitani, Changliu Liu, and Guanya Shi. OmniH2O: Universal and Dexterous Human-to-Humanoid Whole-Body Teleoperation and Learning. In Proceedings of the 8th Conference on Robot Learning, volume 270 of Proceedings of Machine Learning Research, pages 1516–1540, 2025.
Tairan He, Jiawei Gao, Wenli Xiao, Yuanhang Zhang, Zi Wang, Jiashun Wang, Zhengyi Luo, Guanqi He, Nikhil Sobanbabu, Chaoyi Pan, Zeji Yi, Guannan Qu, Kris Kitani, Jessica K. Hodgins, Linxi Fan, Yuke Zhu, Changliu Liu, and Guanya Shi. ASAP: Aligning Simulation and Real-World Physics for Learning Agile Humanoid Whole-Body Skills. In Proceedings of Robotics: Science and Systems, 2025.
Zhengyi Luo, Ye Yuan, Tingwu Wang, Chenran Li, Fernando Castañeda, Sirui Chen, Zi-Ang Cao, Jiefeng Li, David Minor, Qingwei Ben, Jinhyung Park, David Sami, Zi Wang, Xingye Da, Runyu Ding, Cyrus Hogg, Lina Song, Edy Lim, Eugene Jeong, Tairan He, Haoru Xue, Wenli Xiao, Simon Yuen, Jan Kautz, Yan Chang, Umar Iqbal, Linxi Fan, and Yuke Zhu. SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control. Science Robotics, 11(117):eaed4592, 2026.
Resources and figure credits
- Numerical examples.
- ASAP motion retargeting; observation history; policy configuration; delta action model.
- AMP behavior examples: official project.
- PHC tracking and recovery: paper, Figure 4; repository.
- OmniH2O pipeline: official project; repository.
- ASAP pipeline: official project, Figure 2.
- SONIC manipulation rollout: paper version 1, Figure 6.