CH-01 3D 人体运动表示
动作捕捉系统记录关节轨迹,人体模型生成表面网格,语言标注概括行为语义。要利用这些数据学习三维运动规律,首先需要建立观测与人体状态之间的数值对应,使不同样本能够在一致的时间采样、坐标系和身体结构下比较,并使预测结果能够恢复为可驱动角色的几何运动。
逐帧存储三维坐标可以记录位置变化,却不足以规定骨骼连接、局部朝向及表面形变;同一运动还会因帧率、坐标约定或人物尺度不同而产生不同数值。Motion representation(运动表示)正是为这些状态规定参数化、结构约定与几何恢复过程。关节点轨迹、骨骼旋转、人体模型参数和逐帧网格各自保留不同信息,表示的选择因此取决于输入观测、预测目标与下游的角色驱动或控制接口。
具体而言,关节点提供空间位置,关节旋转描述局部坐标系的相对朝向,参数化人体模型则由姿态与形状确定稠密表面。训练过程还常将根运动、局部姿态及接触状态组合为帧级特征。因此,几何状态与网络输入并非同一层次:几何表示定义运动实体,训练特征规定网络访问这些状态的方式。
在比较这些表示时,还需区分特征维数与人体自由度。一个旋转矩阵具有九个元素,但仅有三个独立自由度;位置与旋转同时存储时还会引入几何冗余。关节顺序、骨架拓扑与坐标约定决定每个通道的物理含义,也是编码、学习和恢复过程保持一致的基础。
在固定形态、理想球关节假设下,身体配置属于乘积空间
这里 $J$ 包含根节点,$SE(3)$ 描述根的三维刚体位姿,$SO(3)$ 描述各局部球关节的旋转。根的刚体位姿与局部关节旋转共同参数化该空间;解剖限位和自碰撞进一步限定可行子集。关节坐标与表面顶点是配置经几何映射得到的观测,通常不是可独立赋值的自由变量。运动表示的核心选择,因而是网络在配置空间中预测,还是在更高维的观测空间中回归后再恢复约束。
1. 姿态、动作与时间采样
1.1 关节点序列
位置是运动观测中最直接的几何量,可以用身体上的一组结构点记录姿态。Keypoint(关节点)是这类表示中的三维位置点,可能来自人体模型的关节回归器、动作捕捉骨架、视觉检测器或人工选定的表面点;“左肩”在不同定义中可能是旋转中心、骨架节点或可见表面标志。位置相近,并不代表它们具有同一个运动学含义。
确定关节点集合与排列顺序后,单帧可表示为 $P_t\in\mathbb R^{J\times3}$,第 $j$ 行记录关节的三维坐标。按时间排列这些姿态,得到动作序列
其中 $T$ 是有效帧数,$J$ 是关节数;批量输入再增加批量轴,得到 [B,T,J,3]。将关节维展平得到 [B,T,3J],不会删除信息,但必须保存原来的关节顺序才能恢复。
1.2 帧率与差分
物理运动的离散帧索引统一记为 $t\in\{0,\ldots,T-1\}$。采样率为 $f$ 时,$\Delta t=1/f$,第 $t$ 帧对应相对起点的物理时刻 $t\Delta t$。播放时长通常按 $T\Delta t$ 计算,首末采样点之间的跨度则为 $(T-1)\Delta t$。生成模型的去噪步与控制器的执行周期属于另外两条轴,不能通过替换帧索引混用。
位置差分与物理速度分别是
例如,20 FPS 下每帧前进 0.05 米,对应约 1 米/秒。若同一个运动重采样到 40 FPS,相邻位移应约为 0.025 米;不能保持位移通道原值,再只修改视频播放帧率。
重采样同时涉及几何插值与信号带宽。对带宽为 $\nu_{\max}$ 的理想连续坐标信号,避免混叠要求 $f>2\nu_{\max}$;降低帧率前的低通处理不能由抽帧替代。接触冲击和离散事件边界并不满足严格带限假设,低通又可能模糊着地时刻,因此连续轨迹与事件标签应分开处理。位置的欧氏插值、旋转流形上的插值和接触状态的离散重标注,分别对应不同的数据结构。
除了重采样的影响,差分计算本身还会放大观测噪声。若相邻帧的单坐标测量误差独立、方差均为 $\sigma_p^2$,一阶速度差分的噪声方差为 $2\sigma_p^2/\Delta t^2$。这解释了高帧率下直接差分可能更不稳定:更短时间间隔提升时间分辨率,却也放大位置误差。速度和加速度损失需要同时规定单位、滤波协议与有效时间窗口。
1.3 骨架拓扑
关节坐标本身不包含骨骼连接。骨架拓扑(skeletal topology)通常由父节点映射 $\pi(j)$ 定义:根节点无父节点,其余关节与父节点构成运动链,骨长为 $\|p_j-p_{\pi(j)}\|_2$。关节数量相同的骨架仍可能具有不同拓扑,不能仅根据张量形状判定表示兼容。
骨长可以来自固定标准骨架,也可以依人物体形改变。把多个主体缩放到统一骨架,方便模型学习动作规律,却会改变原始体形与绝对空间尺度。用于人体动作生成的规范化骨架,因而未必可以直接用于原人物的角色绑定或机器人关节控制。
固定骨长 $\ell_j$ 对坐标施加等式约束 $\|p_{t,j}-p_{t,\pi(j)}\|_2^2-\ell_j^2=0$。对所采样的连续轨迹求导,以 $v_{t,j}$ 表示采样时刻的瞬时速度,得到
相对速度必须位于骨长约束的切空间,不能沿骨骼方向任意伸缩。
有限差分只近似这一瞬时条件。若相邻帧的骨向量为 $b$ 与 $b+\Delta b$,两者等长意味着 $b^\top\Delta b=-\|\Delta b\|^2/2$;有限位移沿球面的弦连接两点,一般不精确位于起点的切平面。位置与速度分别回归时,即使两个张量形状正确,也可能违反这一相容性;由同一旋转运动链恢复它们,则将部分约束直接编码进输出结构。
2. 坐标系与根运动
2.1 世界坐标与根坐标
骨架拓扑规定人体内部连接,根位姿规定其相对于环境的刚体状态。根节点(root)通常位于骨盆附近;根平移与朝向描述整体运动,根局部坐标描述身体构型。采用列向量约定,令世界平移为 $r_t$、根朝向为 $R_t$,局部关节点 $\tilde p_{t,j}$ 与世界坐标满足
不同坐标系保留的信息不同:世界坐标保留人物相对于场景的位置;根坐标把整体平移移除;进一步对齐朝向,可以让不同方向的行走共享局部姿态模式。父关节坐标则用于运动链中的局部旋转,与“整个人的根坐标”不是同一个坐标系。
移除根运动后,向前跑与原地跑可能具有相近的局部表示。若需要恢复全局位移,必须另外保存根轨迹;若初始位置和朝向也被规范化,则还需保存初始变换。局部表示消除了部分全局变化,但并非对原运动的无损替代。
用齐次变换可以统一描述坐标恢复:
这里 $SE(3)$ 表示三维刚体变换群。共同世界变换 $h$ 使 $g_t$ 变为 $hg_t$,局部关节坐标保持不变;规范化等价于选择一个坐标参照,恢复原场景则必须保存被移除的 $h$。几何坐标变换可以采用完整 $SE(3)$,但在固定重力方向的动作学习中,任意俯仰或翻滚通常不是保持任务语义的数据增强;常用不变性仅涉及水平平移和绕竖直轴的旋转。
2.2 坐标约定与变换顺序
三维数据必须说明单位、上轴、手系、旋转方向和矩阵乘法约定。以 Y 轴向上为例,地面位于 XZ 平面;若渲染器采用 Z 轴向上,需要对全部关节、根平移、旋转与物体坐标做一致转换。
旋转与平移通常不可交换。先绕原点旋转再平移,对应 $Rp+r$;先平移再绕原点旋转,对应 $R(p+r)$。对多人或人与物体的交互,这个差异会直接改变接触位置。
归一化变换应作用于全部相关实体。例如,将人体旋转到正前方后,如果桌子仍留在原世界位置,得到的“人体—桌子”关系就已经发生改变。
3. 关节旋转的数学表示
3.1 旋转矩阵与三维自由度
关节位置约束骨骼端点,关节旋转进一步确定局部坐标系的朝向,包括单条骨骼轴向扭转等位置信息无法完全确定的分量。三维刚体旋转构成特殊正交群 $SO(3)$,其矩阵满足
矩阵共有九个数,但正交与行列式约束使其只有三个独立自由度。直接回归九个任意数,不能保证输出位于 $SO(3)$。这里的刚体旋转也不表示人体关节可以任意绕三个轴转动:关节的解剖约束需要另外建模。
除了直接存储旋转矩阵,还可以使用较少的参数描述旋转。Euler angles(欧拉角)使用三个有序轴旋转,便于解释,却依赖轴序并存在万向节锁。Axis-angle(轴角)将旋转写成单位轴 $u$ 和角度 $\theta$,也常合并为 $\omega=\theta u\in\mathbb R^3$。对单位轴,Rodrigues 公式为
其中 $[u]_\times v=u\times v$。Axis-angle 向量的长度接近零时需要稳定的小角展开;角度边界也存在多种等价表示。
3.2 Quaternion 与双覆盖
Unit quaternion(单位四元数)采用实部在前的顺序:
该参数化使用旋转半角。$q$ 与 $-q$ 对应同一旋转,即单位四元数对 $SO(3)$ 构成双覆盖。序列处理中可通过相邻四元数内积的符号进行局部连续化,避免等价表示切换引起数值跳变;这一处理不能消除旋转空间的全局拓扑性质。
Spherical linear interpolation(SLERP,球面线性插值)可沿球面连接两个归一化四元数。插值前需要选择合适符号,通常采用较短路径;直接对四元数做线性平均,再归一化,也需要检查两端是否互为负号及是否接近退化输入。
3.3 旋转的比较
比较两个旋转 $R_1,R_2$ 时,可以使用相对旋转的测地角:
数值计算要把反余弦输入限制在 $[-1,1]$。旋转参数的 L2 距离与角度误差不是同一种量;例如 $179^\circ$ 和 $-179^\circ$ 的原始角度差为 $358^\circ$,两种姿态的较短旋转差却只有 $2^\circ$。
相邻旋转的局部增量由李代数给出。采用 body-frame 约定,
$\vee$ 将反对称矩阵转换为三维向量。左乘更新对应 world-frame 角速度,二者不能在同一恢复链中混用。主值对数在旋转角接近 $\pi$ 时存在分支歧义,因此局部角速度解释依赖足够密集的采样与一致的旋转分支。
4. 6D 旋转与连续回归
4.1 两个向量构造正交坐标轴
角度边界与四元数的符号等价,会让相近的姿态在原始参数空间中相距很远。6D 旋转表示以两个三维向量编码旋转,再通过正交化恢复合法矩阵,为神经网络的连续回归提供另一种接口。采用矩阵列约定时,编码取前两个列向量;给网络输出 $a_1,a_2\in\mathbb R^3$,恢复过程为
然后令 $R=[b_1\ b_2\ b_3]$。只要输入非退化,就得到正交且右手的旋转矩阵。HumanML3D 的 cont6d_to_matrix 以叉积组织等价过程,并把得到的三个轴放在矩阵列上。
不同实现可以选择矩阵的行或列作为六维表示,并按相应顺序恢复。无论采用哪种约定,额外维数都服务于连续参数化,旋转本身仍只有三个自由度。
4.2 边界附近的插值算例
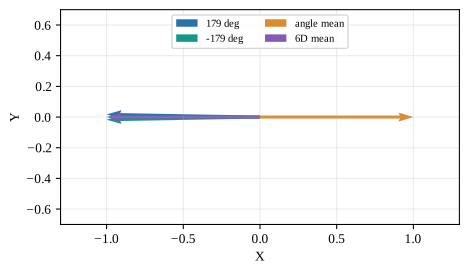
以角度边界附近的插值为例,可以观察欧氏坐标图与旋转流形之间的不一致。具体而言,端点位于同一轴的 $179^\circ$ 与 $-179^\circ$ 时,标量平均落在 $0^\circ$,而短测地路径经过 $180^\circ$。6D 编码先在嵌入空间组合,再恢复正交坐标轴,可以在这个局部案例中避免角度跳变;该结果不意味着任意 6D 线性插值都等于旋转测地线。
1 | import numpy as np |
运行结果:
1 | angle-coordinate midpoint: 0.0 deg |
4.3 退化输入
当第一输入向量为零,或两个输入向量近平行时,正交化退化或呈现较大的数值敏感性。分母中的 epsilon 只能抑制部分数值溢出,不能为退化输入提供唯一旋转。实现中需结合有效输入范围和退化策略,并检查输出正交性及行列式。
上述退化对扰动的放大作用,可以由归一化映射直接解释。对 $b=a/\|a\|$,其 Jacobian 为 $(I-bb^\top)/\|a\|$;因此 $\|a_1\|$ 或正交剩余量 $\|u_2\|$ 接近零时,微小输入扰动会被放大。6D 表示改善的是合法旋转的连续嵌入,而不是使整个 $\mathbb R^6$ 上的解码都具有均匀良好的条件数。输出约束、数据覆盖与反向梯度的数值稳定性仍需共同考虑。
将非退化的六维预测转换成旋转,再用 FK 计算位置,就能在输出结构中保持旋转正交性与固定骨长。关节活动范围和时间平滑性属于另外两类约束,可分别通过关节限位与时序损失表达。
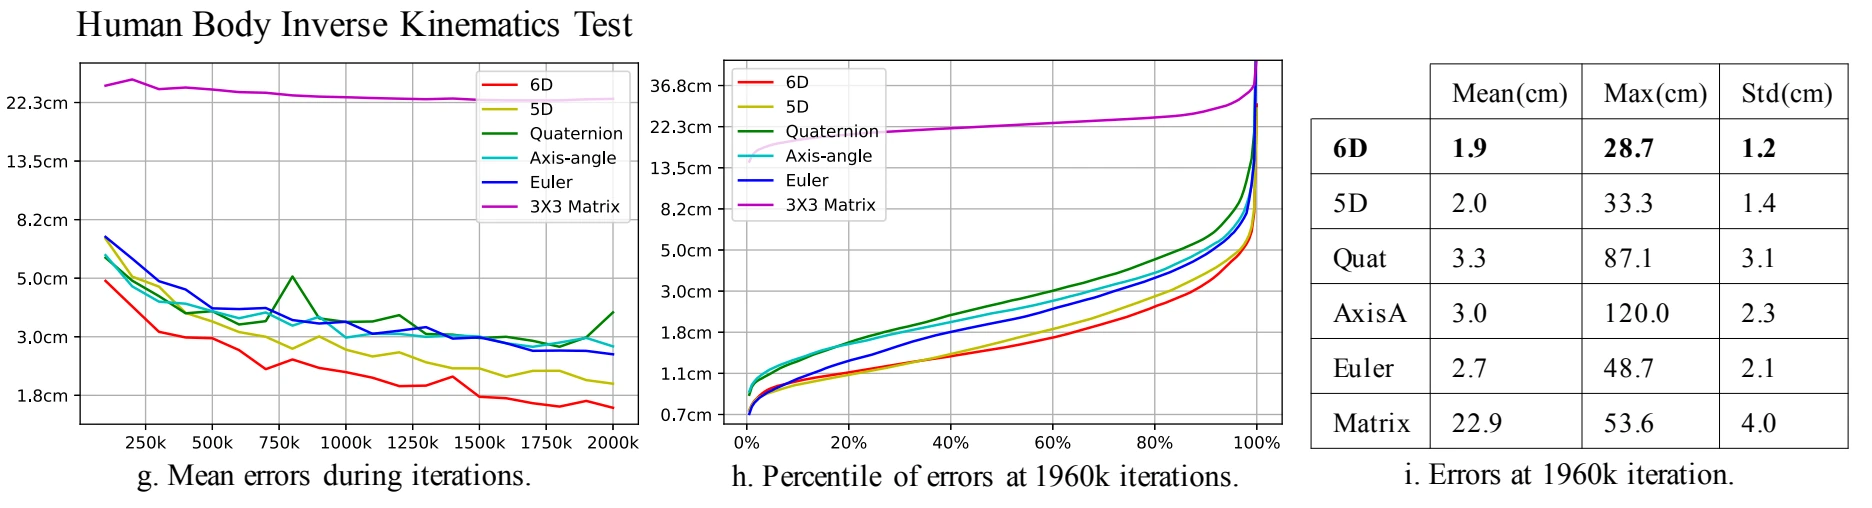
旋转参数化还会影响学习式 IK 的误差分布。下图比较相同逆运动学任务中的不同输出表示:左侧为训练过程中的平均误差,中间为测试误差的分位数曲线,右侧给出汇总统计。该实验中 6D 表示具有较低的平均误差与尾部误差,说明参数空间的连续性会影响网络对完整姿态范围的拟合。
5. 前向运动学与逆向运动学
旋转表示确定之后,还需要把各关节的局部旋转连接成完整身体。前向运动学(forward kinematics,FK)根据骨架、局部旋转和根运动计算关节的世界位置;逆向运动学(inverse kinematics,IK)则根据指定的位置目标,寻找能够到达它的关节配置。两者的求解方向相反,但通常不是一一对应的逆运算。
5.1 局部变换沿骨架累积
令骨骼静止偏移为 $o_j$,局部旋转为 $R_j$,采用
这是把关节坐标系相对于父坐标系的旋转和平移组合为齐次变换。根变换包含整体朝向和平移,非根关节的世界位置由 $G_j$ 的平移部分得到。骨架偏移定义与旋转作用位置需要一致;换用另一套绑定约定时,应同时调整变换定义。
沿父子树依次计算 $G_j$,便完成了 FK。由于旋转只改变骨骼方向、不改变静止偏移长度,这种计算能够在固定骨架上保持骨长。
5.2 同一末端位置的两个姿态
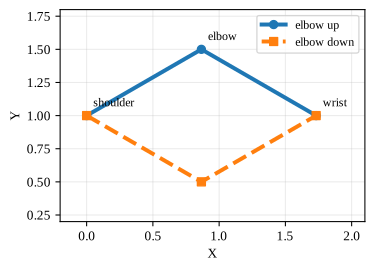
以平面双连杆为例,可以观察 IK 解的多样性;它是三维运动链在平面约束下的特例。两段单位连杆由肩与肘的相对角度参数化,FK 将二维角配置映射到二维末端位置。肘上与肘下两种解展示了映射的全局多对一性质;即使输入与输出维数相同,逆映射也未必唯一。
1 | import numpy as np |
运行结果:
1 | upper joints: |
5.3 关节点不能确定所有旋转
前述双连杆展示了多个配置对应同一末端位置的情况;在局部范围内,可辨识性由 FK 的 Jacobian 决定。设末端映射为 $p=F(q)$,小扰动满足 $\delta p\approx J_F(q)\delta q$。若存在非零 $\delta q\in\ker J_F$,该关节变化在一阶近似下不会改变末端位置。对冗余运动链,IK 的局部解可写为
其中 $J_F^\dagger$ 是 Moore–Penrose pseudoinverse(伪逆),$z$ 为任意配置增量向量。第一项拟合可达的任务空间增量,第二项通过 $I-J_F^\dagger J_F$ 将 $z$ 投影到 task null space(任务零空间),可用于姿态偏好、避障与限位。当 Jacobian 降秩时,可实现的末端速度方向减少,伪逆还可能放大小奇异值方向的误差。正则化改善数值条件,不能增加机械结构本身的可达自由度。
末端位置约束通常不能唯一确定全部关节配置,因此 IK 常被表述为带姿态先验、关节限位与时序正则的优化问题。即使已知全部关节中心,单条骨骼两端的位置也无法单独确定绕其轴线的扭转;这类旋转会影响表面形变、手掌朝向及下游关节坐标系。
用于角色重定向的静止绑定姿态也必须一致。例如,两个角色的肩部局部轴如果不同,同一组局部旋转数值会产生不同手臂方向;需要把源角色的关节坐标转换到目标绑定坐标,再考虑骨长与活动范围。仅重排关节编号能够解决名字对应,却不能解决坐标轴对应。
因此,关节点到完整骨骼旋转的转换通常需要姿态先验或局部轴约定。HumanML3D 据此用 IK 提取旋转,再在标准骨架上执行 FK,将不同人体的骨长统一到共同表示。
6. SMPL、SMPL-X 与人体网格
6.1 参数化表面
骨架提供稀疏运动结构,表面接触与穿透检测则需要更完整的几何信息。Mesh(人体网格)由顶点及三角形拓扑组成,逐帧顶点可写为 $V_t\in\mathbb R^{N_v\times3}$。显式网格保留稠密表面,但存储开销较大,顶点坐标本身也不直接规定骨架绑定或关节旋转。
参数化人体模型用较少参数生成完整网格,将体形与姿态分开控制。SMPL 是其中一种常用模型,它用形状参数 $\beta$、姿态参数 $\theta$ 和全局平移 $\gamma$ 驱动人体。具体而言,形状决定身高、体态与骨架尺度;姿态决定相对于身体的关节旋转;平移决定整体位置。同一动作可施加于不同体形,但运动与场景接触仍可能需要重新调整。
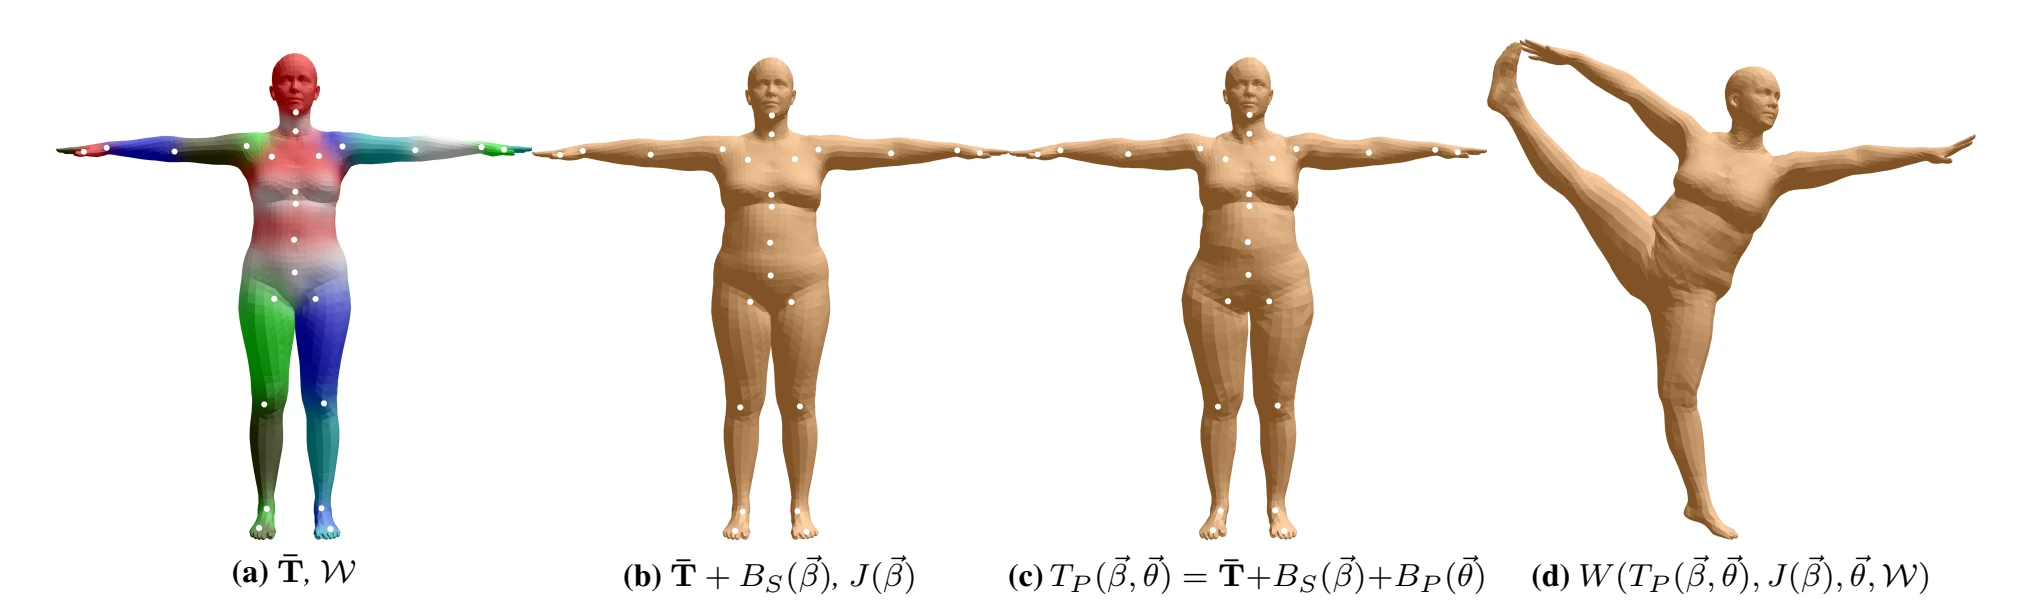
一个简化表达为
其中 $\bar T$ 是模板,$B_S$ 是形状修正,$B_P$ 是姿态相关修正,$J(\beta)$ 是随体形改变的关节,$\mathcal W$ 是顶点蒙皮权重。linear blend skinning(LBS)把不同关节的变换按顶点权重组合,并消除静止绑定变换的影响。
形状 blend shapes 与 pose-dependent blend shapes 在蒙皮之前修正模板。下图依次展示静止模板、形状变化、姿态相关校正及蒙皮结果;前两类校正分别表达个体形态和关节弯曲引起的非刚性表面变化,蒙皮则根据运动链把修正后的顶点变换到目标姿态。
6.2 身体、手与面部
SMPL 的标准身体运动链包含根在内的 24 个关节,姿态轴角通常由全局根旋转和 23 个局部旋转组成。SMPL+H 加入手部;SMPL-X 进一步组织身体、手、面部与表达参数,并使用不同的模板与关节体系。
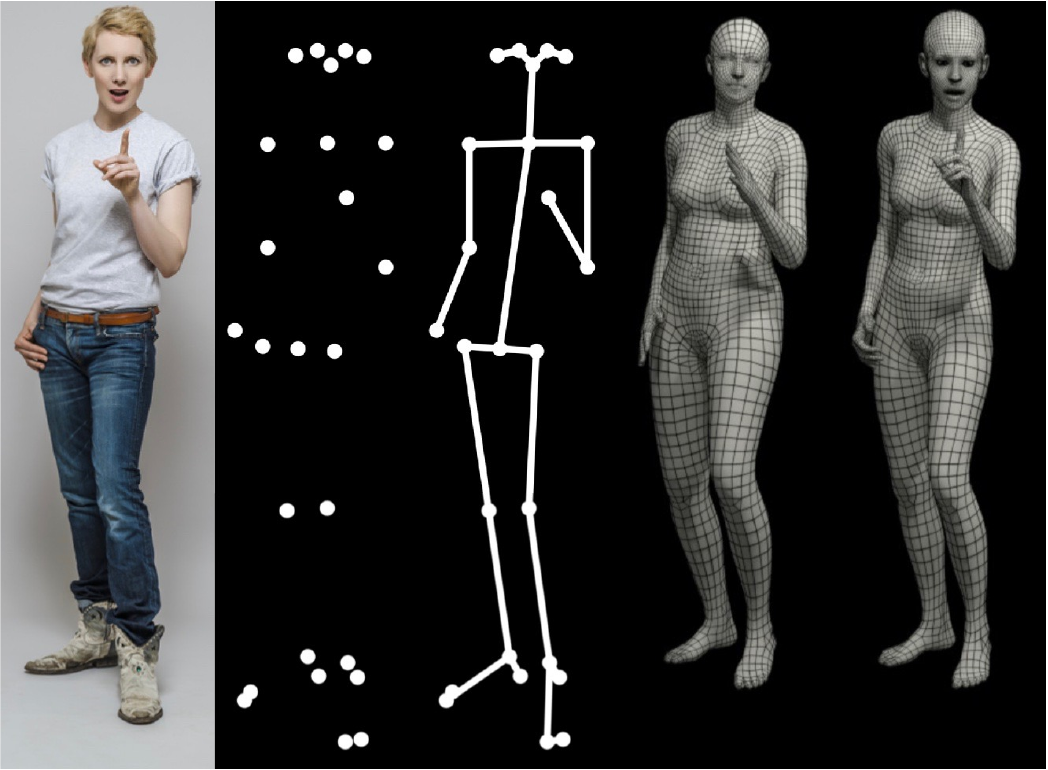
SMPL-X 的关键点可以来自运动学关节、指定网格顶点、面部地标或额外关节回归器。这些点共同服务于观测与评价,控制模型运动的姿态参数则由骨架体系决定。因此,数据集导出的关键点数量与姿态参数维数分别描述输出几何和模型控制量。
手部姿态既可以保存各指关节的旋转,也可以用 PCA 系数表达常见的协同变化。少量系数通过手部姿态基展开为完整旋转,进而驱动网格;网格上的指定位置又可以导出观测关键点。参数、表面与关键点由这条计算链联系起来。
这种差异在相同输入的重建结果中更容易辨认。以图中的举指动作为例,仅用主要关节点时只能观察手臂位置;加入手指关节与面部参数后,手势和表情才成为表示的一部分。更丰富的模板提供了表达能力,具体重建精度仍取决于观测与估计过程。
6.3 姿态参数到网格顶点的计算
参数化模型解决的是一个具体问题:骨架旋转容易存储和编辑,接触与渲染却需要完整表面。把每个顶点刚性绑定到单根骨骼,会使关节附近出现生硬接缝;linear blend skinning(LBS)允许一个顶点同时受到多根骨骼影响,姿态修正则进一步补偿弯曲时的表面变形。SMPL 从配准的人体扫描中学习形状基、姿态修正、关节回归器与蒙皮权重,随后用同一套计算将新的形状和姿态转换为网格。
SMPL 的可微映射可以分为三个主要部分:形状构建、姿态修正,以及运动链变换与蒙皮。标准配置包含 $N_v=6890$ 个顶点和24个运动学关节,批量维为 $B$;smplx/lbs.py 的 lbs 实现按这些几何依赖组织张量收缩。
首先,形状系数与形状基的线性组合产生 [B,6890,3] 的顶点偏移,与模板相加得到静止形状 v_shaped。[24,6890] 的关节回归器将其映射为 [B,24,3] 的关节位置,使骨架尺度与表面形态由同一形状变量控制。
其次,姿态分支将轴角映射为 [B,24,3,3] 的旋转矩阵。23个非根关节相对静止姿态的 $R_j-I$ 展开为 $23\times9=207$ 维特征,经 posedirs 映射到稠密表面修正:
这里将每个 $a_j$ 视为行向量,拼接后的 $a$ 与姿态修正矩阵 $P$ 相乘,reshape 将结果恢复为顶点偏移。全局根旋转改变身体朝向,不改变关节弯曲所引起的局部表面变形,因此不进入这207维特征。形状偏移与姿态偏移相加,得到尚未蒙皮的 v_posed。
最后,运动链分支通过 batch_rigid_transform 累积局部刚体变换,并消除静止绑定位置,得到24个 [4,4] 变换 $A_j$。第 $i$ 个顶点的蒙皮映射是这些变换的加权组合:
因此 [6890,24] 的权重与 [B,24,16] 的变换相乘,生成 [B,6890,16] 的逐顶点变换,再恢复为矩阵作用于齐次顶点。最后加上全局平移,得到身体在场景中的位置。
这条计算链把少量姿态参数展开为稠密表面,而且各步可参与梯度计算。用网格顶点构造的表面距离或接触损失,因而能够反向更新姿态预测网络。lbs 返回运动链关节和表面顶点;外层 SMPL.forward 还可以追加网格选点,并通过 joint_mapper 重排,所以最终 joints 的数量取决于所采用的关键点映射。
虽然每个 $A_j$ 来自刚体变换,加权和 $\sum_jw_{ij}A_j$ 的旋转块通常不再属于 $SO(3)$。这正是 LBS 能表达非刚性表面形变、同时也可能在大幅扭转处产生体积损失的原因。姿态修正由数据学习补偿此类变形,网格输出仍不自动满足体积守恒、自碰撞排除或接触力学。可微表面模型提供几何优化通路,不能被等同于完整的人体动力学模型。
7. 263、251 与 272 维动作特征
7.1 HumanML3D 的通道分块
位置便于施加空间目标,旋转便于驱动固定骨架,而支撑阶段还需要足部运动与接触信息。为同时提供这些监督和恢复接口,网络训练常把多种量拼成一个帧向量,形成复合动作特征。HumanML3D 的常用表示把根运动、位置、旋转、差分与接触拼在一帧中;对于 22 关节,维数为
采用 Python 左闭右开的切片约定:0:1 为根朝向增量,1:3 为根在地面平面的位移,3:4 为根高度;4:67 为非根关节位置,67:193 为非根关节 6D 旋转,193:259 为全部关节的局部逐帧位移,259:263 为左右脚的四个接触通道。
根局部位置的处理并非简单地减去完整三维根坐标。官方流程移除根的 XZ 平移,并对齐朝向;Y 轴高度仍以地面为参照。恢复非根位置时,代码加回根的 XZ,不能再把根高度重复加到全部关节上。
位置与旋转存在部分冗余:固定骨架上的旋转可经 FK 得到位置。保留两种信息可以分别提供几何监督和恢复接口,但生成结果中两者不一定自动一致。
构造这些通道之前,需要完成两类几何规范化。其一,形态规范化通过源骨架 IK 与目标骨架 FK 统一骨长;其二,坐标规范化通过地面对齐、首帧水平根位置及初始朝向固定空间参照。process_file 将二者组合,前者改变身体尺度,后者选择全局坐标;它们对场景接触和可逆恢复的影响因此不同。
完成几何规范化后,处理程序在相应坐标系中计算根的朝向增量与局部位移,再移除逐帧根的水平平移和朝向,得到身体局部位置;IK 提供非根关节旋转,相邻帧差分提供速度相关通道,足部位移阈值提供接触标签。各分块拼接为263维向量后,训练加载器再按训练集的均值和标准差逐通道标准化。几何规范化统一了坐标含义,统计标准化则平衡了不同通道的数值尺度。
7.2 根角半角与位置恢复
官方 process_file 先将动作置于地面、统一骨架与初始朝向,再计算根的相对四元数,将其中 Y 分量通过 arcsin 存入根角通道。recover_root_rot_pos 累积这个量为 $a_t$,构造
在相邻帧根转角较小、四元数符号连续的条件下,arcsin 的主值给出相应半角增量,累积后的四元数对应旋转角 $2a_t$。局部位移恢复到世界坐标时使用其逆旋转;根位移还要先移位到下一帧,再累积。因此,该通道表示逐帧的根对齐半角增量,其符号、尺度和单位都由这一编码过程决定。
根增量表示将局部预测误差送入时间积分。以下算例保持半角恢复与坐标约定一致,只加入恒定的逐帧位移偏差,从而分离表示积分本身与旋转估计的影响。
1 | import numpy as np |
运行结果:
1 | root shape: (81, 3) |
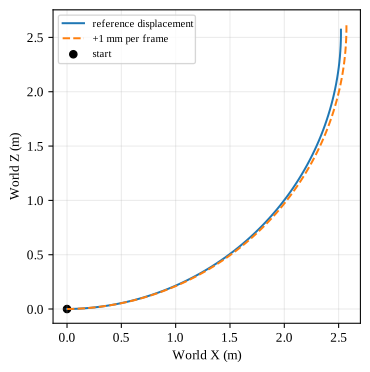
对已转换到世界坐标的位移误差 $\varepsilon_t$,时刻 $t$ 的根误差为 $\delta r_t=\sum_{i=0}^{t-1}\varepsilon_i$。恒定偏差 $b$ 产生 $tb$ 的线性漂移;独立零均值误差若具有协方差 $\Sigma$,则累计误差协方差为 $t\Sigma$。自相关误差还包含跨时刻协方差项。网络是否自回归与这个积分效应是不同问题:任何生成器只要输出逐帧增量,都需要处理恢复后的全局路径误差。
7.3 其他维度布局
将同一布局用于21关节,得到 $4+20\times3+20\times6+21\times3+4=251$,对应 KIT-ML 经过统一预处理后的常用表示。
MotionMillion 的 inference_single.py 使用272维表示,由根平面位移2维、相对朝向6维、22关节位置66维、位移66维和旋转132维组成。相比263维布局,根朝向改用6D,旋转块包含全部22关节,并移除了四个足接触通道。两种表示因而需要各自的编码与恢复过程。
HumanML3D 的足接触通道由足部相邻位置的平方差与阈值比较得到,描述的是足部是否近似静止。这是一种由运动轨迹估计的接触标签;结合足部高度和场景几何,才能进一步区分地面支撑与空中停顿。
8. 单人数据集与表示来源
特征布局定义处理后的网络接口,数据集则规定运动来源、采集条件与标注范围。动作捕捉归档、行为标注和语言配对数据承担不同作用,其几何来源也可能重叠。
8.1 AMASS 的运动归档
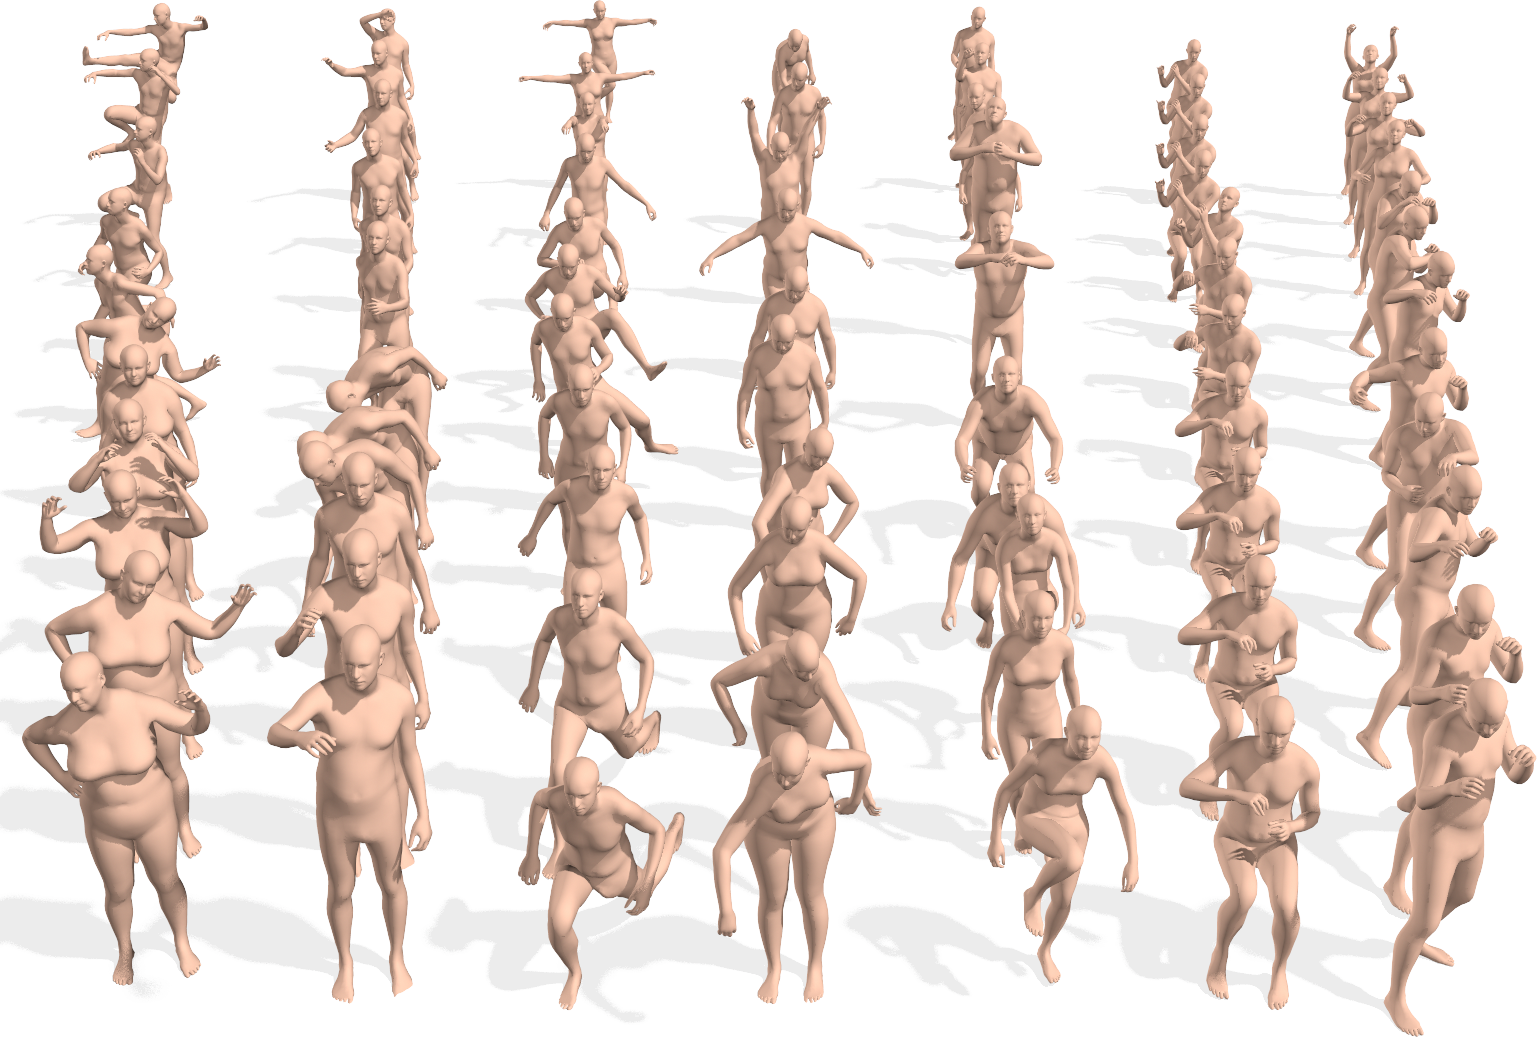
AMASS 将多种光学动作捕捉来源统一为人体模型参数。初始版本汇集15个来源,包含超过40小时、300多名主体和11,000多段动作,随后继续纳入新的捕捉数据。
具体到归档文件,常见字段包含 poses、trans、betas、dmpls 与动作捕捉帧率。姿态、全局平移、体形和动态形变属于不同字段;SMPL+H/DMPL 格式需要相应人体模型与处理代码。AMASS 本身主要提供运动几何,不是原生语言配对数据库。
8.2 BABEL 的时间语义
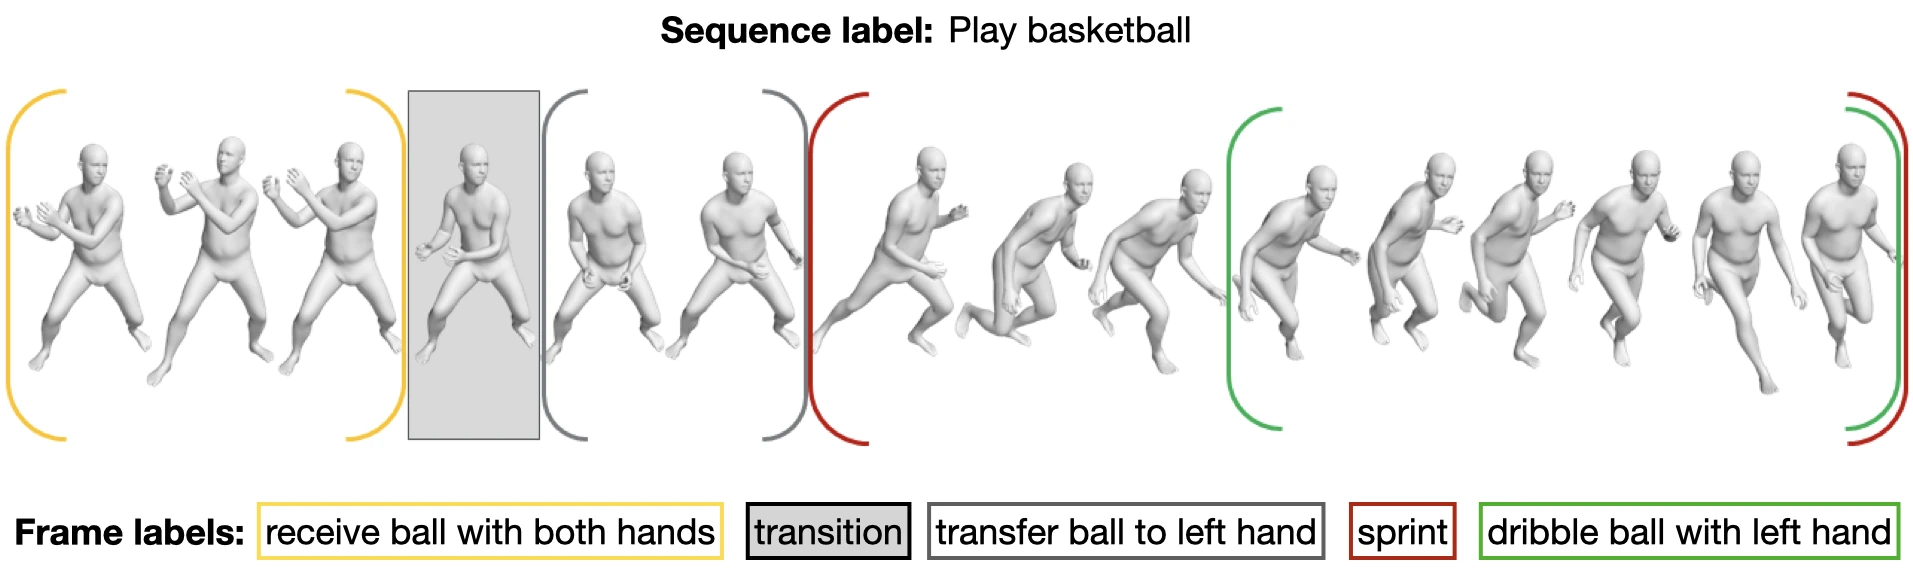
在统一运动几何的基础上,BABEL 为 AMASS 中约 43 小时运动添加序列级与帧区间语义,包含超过 28,000 个序列标签与 63,000 个帧级标签、250 多类动作。这里的帧级标签是带时间区间的动作标注,不是 63,000 个单帧或独立片段。
BABEL 沿用对应 AMASS 几何。使用它时需要把标注时间换算到实际动作帧率,并检查是否在预处理时裁剪或重采样。文本区间与几何区间对齐之后,才可以用于分割、定位或局部条件生成。
整段语义与局部事件具有不同时间粒度。下图将同一篮球运动标为一个序列级行为,并以时间区间标注接球、换手、冲刺和运球。冲刺与运球的区间可以重叠,说明帧级语义不必构成互斥的单标签划分。
8.3 HumanML3D、KIT-ML 与 MotionMillion
HumanML3D 整理 AMASS 与 HumanAct12 等来源,原始数据包含14,616段动作、44,970条文本,共28.59小时,采用20 FPS 与22关节的常用表示。镜像增强将动作左右翻转,并同步交换描述中的左右方位,由此扩充配对样本。
常用文本记录将描述、分词结果、起止时间以 # 分隔。起止时间对应子片段时,加载器根据帧率切出相应运动区间;两个零则用于表示整段描述。同一动作可以配有多条文字,训练时抽取其中一条组成动作—文本样本。重采样和裁剪同时作用于几何序列与时间标注,保证文字仍指向对应的运动过程。
KIT-ML 原始网站提供 C3D、MMM XML、文字与元数据。2016 年 10 月版本记录 3,911 个动作与 6,278 条描述,2017 年 6 月版本描述数为 6,353。常见 T2M 整理版的 21 关节与 251 维需要与所采用版本区分。
MotionMillion 扩展至约两百万片段、超过两千小时的量级,结合网络视频估计与已有运动库整理,采用30 FPS。网络视频带来更广的行为和场景分布,也引入遮挡、镜头运动等造成的重建误差;自动文字进一步扩大标注规模,其语义质量则取决于描述生成与数据筛选。
9. 双人动作与共同空间
交互运动的语义依赖主体间的相对几何。单人预处理中常见的独立居中与朝向对齐,会删除双人之间的距离和方向;多人表示因此需要在局部人体状态之外,明确共同坐标系及角色身份。
9.1 相对关系需要共同坐标
双人输入可以写成 $P^{(1)},P^{(2)}$。两人的根位置之差
给出距离与方向;相对朝向可写为 $(R_t^{(1)})^\top R_t^{(2)}$。同时变换全部人物,可以保持交互关系;分别移到各自原点,却会删除人与人的相对位置。
位置差 $\Delta r_t$ 随共同旋转协变,只有其长度保持不变。若第一人的根变换为 $g_t^{(1)}$,第二人为 $g_t^{(2)}$,完整 egocentric 关系应写成 $(g_t^{(1)})^{-1}g_t^{(2)}$;共同左乘任意坐标变换 $h$ 后,该乘积保持不变。将两人的局部特征与这一相对变换共同编码,才能在去除全局摆放的同时保存交互结构。
例如,握手依赖双方手部的可达与接触,追逐依赖前后位置及相对速度。独立居中且不保存根关系后,这些交互属性无法从两组局部骨架恢复。角色索引也参与语义定义;交换人物轴时,应同步变换“施力者—受力者”等非对称标签。
9.2 InterHuman 的 262 维
InterHuman 的 InterGen 官方实现处理每人的 22 关节位置、22 关节逐帧位移、21 个非根关节 6D 旋转及四个足接触通道:
InterGen 使用每人262维的全局运动表示。datasets/interhuman.py 在分别预处理两人之后,把第二人映射到第一人的规范坐标,使两条运动序列共享同一个空间参照,保留交互中的相对距离与朝向。
双人输入可以在人物轴堆叠为 [B,T,2,262],也可以在特征轴拼接为 [B,T,524]。这两种布局保存相同信息,网络则可以据此选择分别编码人物后交换信息,或在共同特征中建模交互。
9.3 Inter-X 的身体与手部
Inter-X 使用 SMPL-X 参数,官方原始骨架导出每人为 [T,64,3],包含较丰富的身体与手部信息;原始采样率为 120 FPS,公开 T2M 基线处理中下采样至 30 FPS。它还提供角色、关系与动作相关的多种标注。
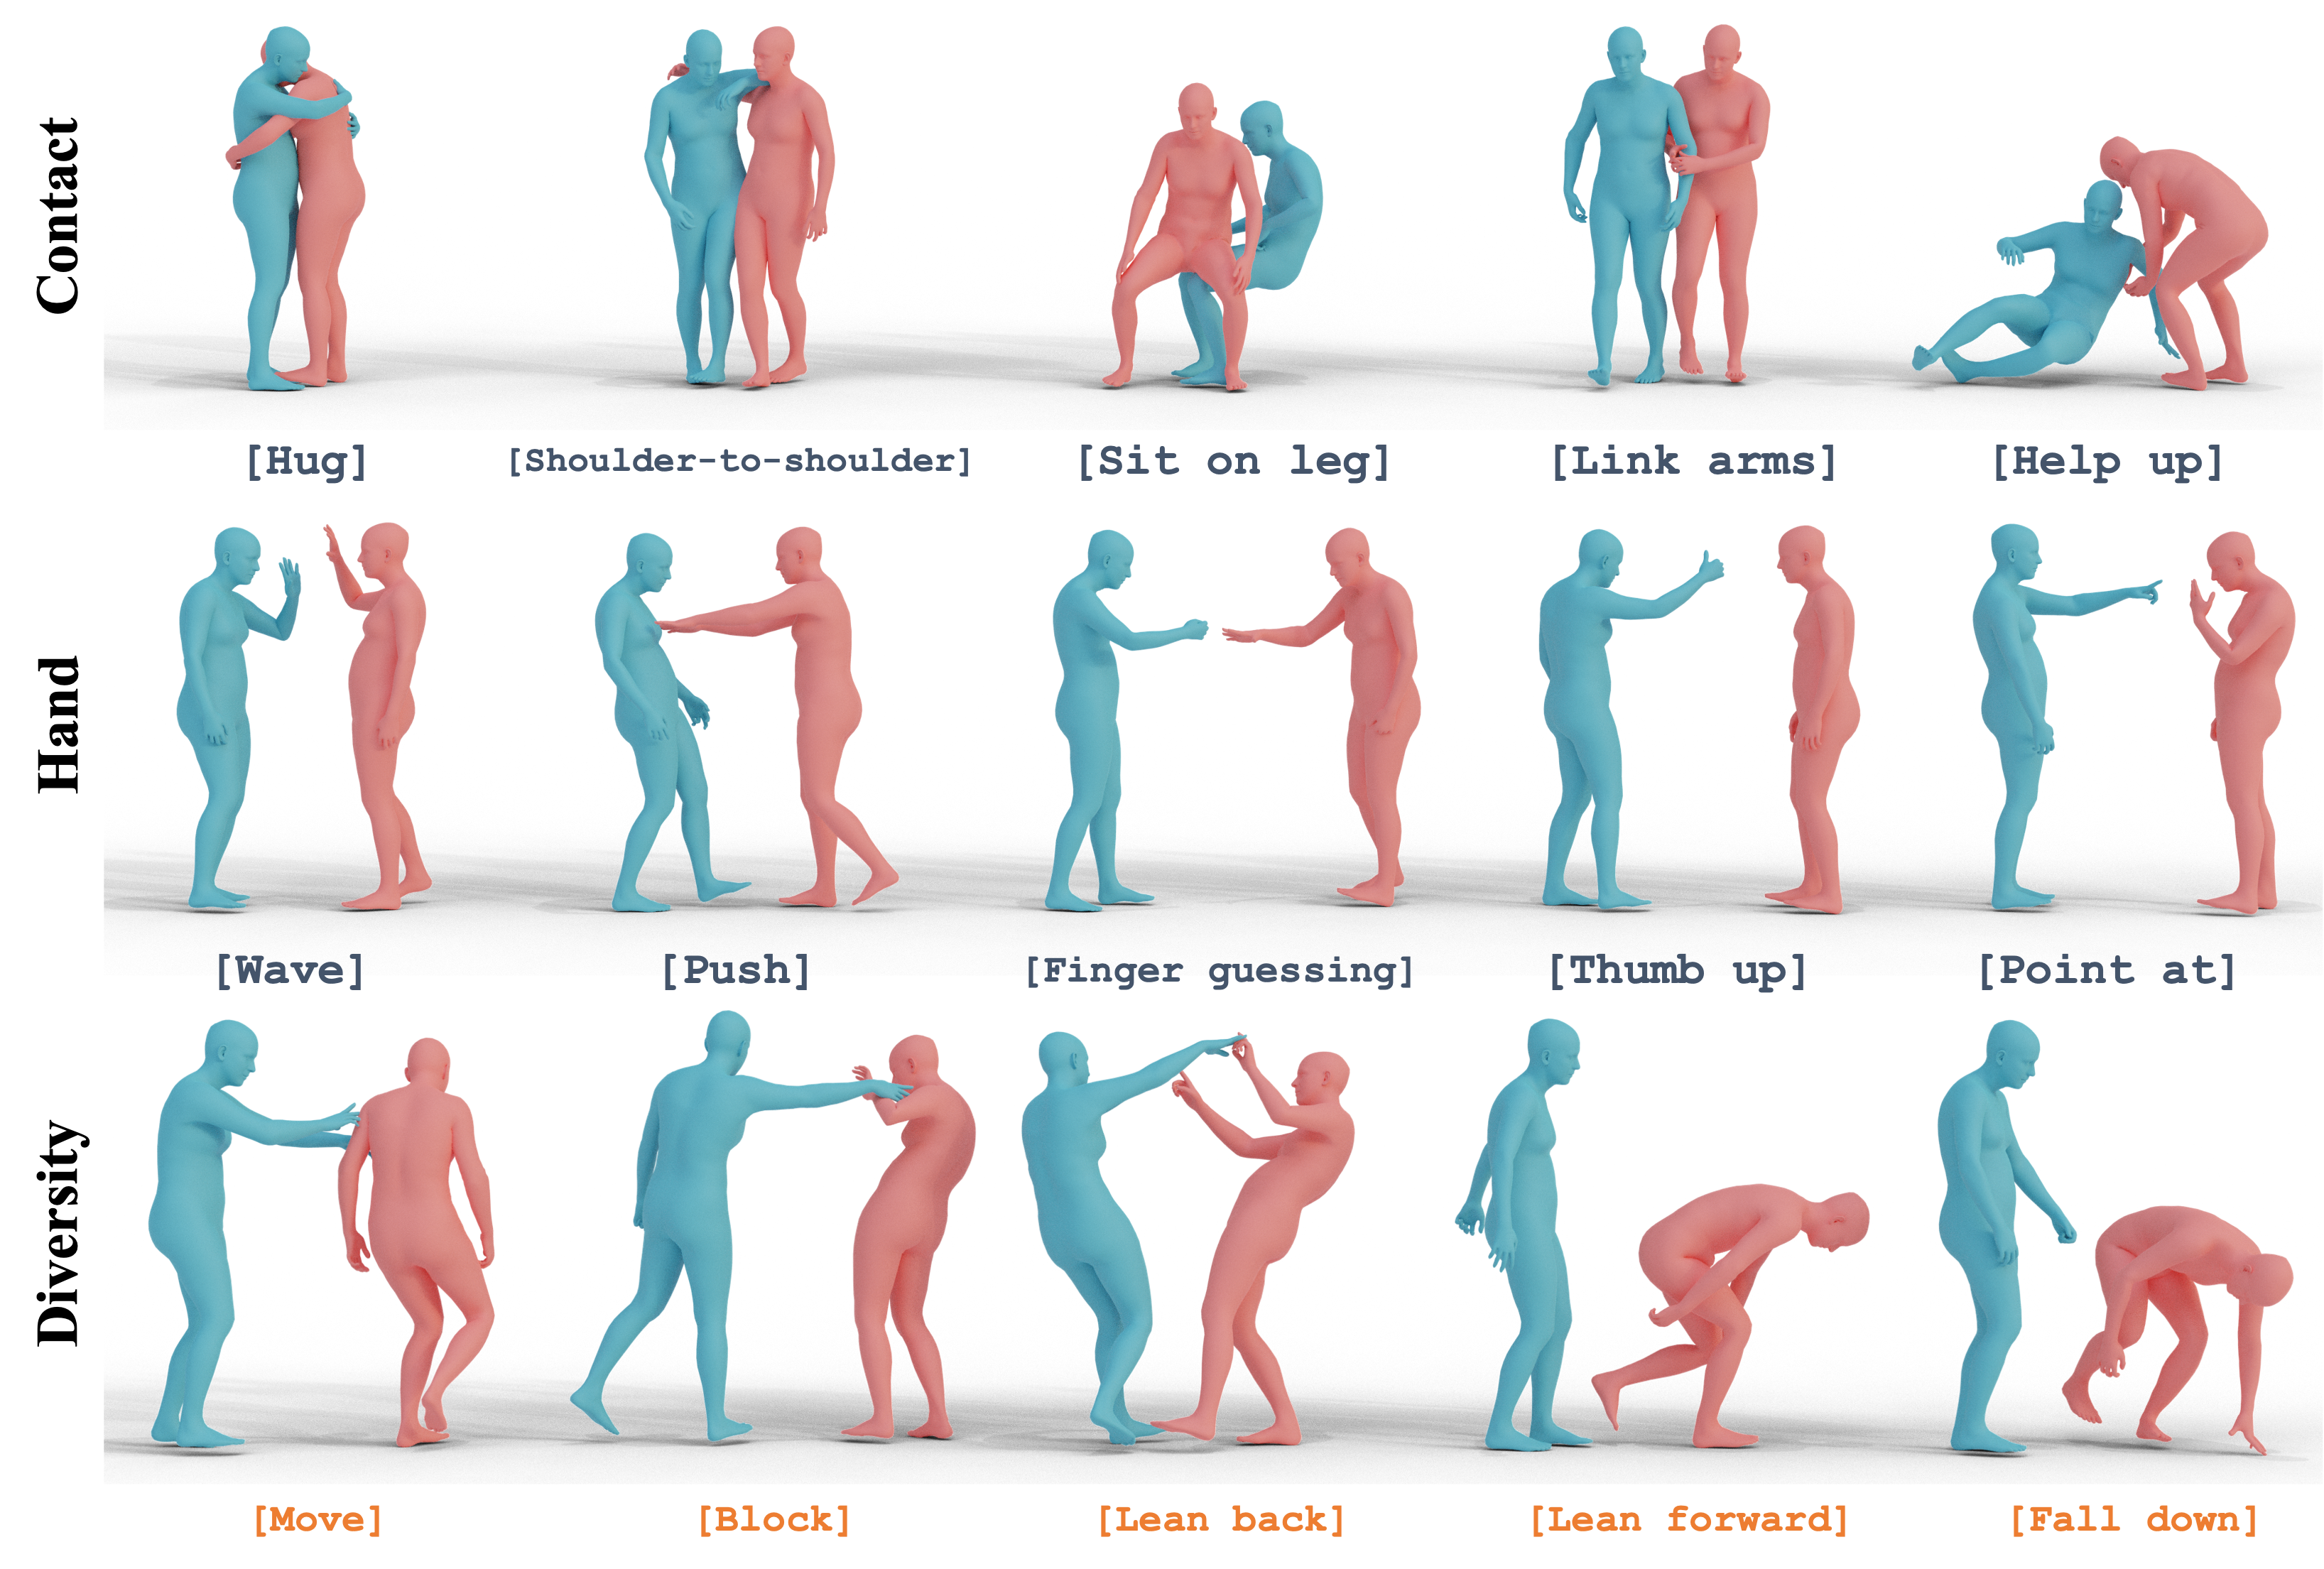
CVPR 2024 发布的数据包含11,388段双人动作与34,164条文字。较丰富的手部关键点把握手、猜拳等精细差异带入观测,人体模型参数再将这些信息连接到可驱动的表面;训练特征则根据具体任务组织身体、手部与两人关系。
网格序列同时呈现双人相对几何和局部手势。下图中,扶起动作依赖接近距离与支撑接触,猜拳则依赖手指构型,分别对应共同坐标与精细人体模型提供的信息。主动动作及响应阶段的判定还需要联合时序信息。
10. 表示恢复与几何一致性
前述表示最终都需要恢复为可解释的几何状态。对于网络输出的标准化特征,需要通过反标准化、坐标恢复及人体运动学计算,转换为骨架或表面。恢复链同时决定几何损失的计算空间,以及不同特征分块之间的一致性关系。
10.1 反标准化在几何计算之前
训练特征常经过 $\hat x=(x-\mu)/\sigma$。恢复几何时先计算 $x=\hat x\sigma+\mu$,再解读根高度、位移与旋转;直接对标准化值执行路径累积或 FK,会把训练统计量误当成真实运动。
HumanML3D 官方目录中的 new_joint_vecs 与 new_joints 分别保存复合特征和关节点。从这些复合特征恢复骨架时,可以选择两条路径:recover_from_ric 用根与位置块恢复骨架,recover_from_rot 用根与旋转块经过骨架 FK 恢复。两条路径读取的通道不同,可以作为冗余一致性的检查,不能假定模型生成时它们天然相等。
process_file 使用相邻差分,特征长度比原始关节点序列少一帧。裁剪与标注对齐需要沿同一协议处理;否则可视化中的末帧与描述区间可能错位。
10.2 冗余表示中的约束
复合特征中的各个分块描述同一个身体,因此存在相互约束。具体而言,位置差分应与相邻帧位置一致,旋转经 FK 得到的位置应与位置块接近,支撑阶段的足部位移则应与接触状态相容。若网络独立预测这些通道,分别减小每一块的数值误差,并不会自动满足它们之间的关系。
骨长约束体现了参数化选择的差异。直接坐标回归允许同一骨骼在不同帧改变长度;固定骨架上的旋转预测与 FK 则在结构上保持骨长。前者便于直接施加位置目标,后者显式保留运动链约束。复合表示可同时提供这两类接口,并通过一致性损失约束它们。
设复合特征的相容性方程为 $c(x)=0$,合法特征位于高维空间中的受约束集合。对某个预测 $\hat x$,局部修正可以求解 $J_c(\hat x)\delta x\approx-c(\hat x)$,再结合数据先验选择解。位置、旋转与速度损失分别监督不同坐标,只有它们与共同的恢复映射一致时,才共同约束同一条物理运动。简单相加多个通道 MSE,并不等价于投影到合法特征集合。
根位移和局部姿态还具有不同的误差传播方式。例如,某帧的局部手腕误差主要影响该时刻的姿态,而逐帧根位移的偏差会经时间累积改变整条路径。这种差别决定了网络需要怎样组织时间信息,也决定了训练时应在哪个空间计算误差。下一章将沿着这些表示特点,讨论时序网络、动作压缩和生成目标。
参考资料
Yi Zhou, Connelly Barnes, Jingwan Lu, Jimei Yang, and Hao Li. On the Continuity of Rotation Representations in Neural Networks. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 5745–5753, 2019.
Matthew Loper, Naureen Mahmood, Javier Romero, Gerard Pons-Moll, and Michael J. Black. SMPL: A Skinned Multi-Person Linear Model. ACM Transactions on Graphics, 34(6):248:1–248:16, 2015.
Georgios Pavlakos, Vasileios Choutas, Nima Ghorbani, Timo Bolkart, Ahmed A. A. Osman, Dimitrios Tzionas, and Michael J. Black. Expressive Body Capture: 3D Hands, Face, and Body from a Single Image. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 10975–10985, 2019.
Naureen Mahmood, Nima Ghorbani, Nikolaus F. Troje, Gerard Pons-Moll, and Michael J. Black. AMASS: Archive of Motion Capture as Surface Shapes. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 5442–5451, 2019.
Abhinanda R. Punnakkal, Arjun Chandrasekaran, Nikos Athanasiou, Alejandra Quiros-Ramirez, and Michael J. Black. BABEL: Bodies, Action and Behavior with English Labels. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 722–731, 2021.
Chuan Guo, Shihao Zou, Xinxin Zuo, Sen Wang, Wei Ji, Xingyu Li, and Li Cheng. Generating Diverse and Natural 3D Human Motions from Text. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 5152–5161, 2022.
Matthias Plappert, Christian Mandery, and Tamim Asfour. The KIT Motion-Language Dataset. Big Data, 4(4):236–252, 2016.
Ke Fan, Shunlin Lu, Minyue Dai, Runyi Yu, Lixing Xiao, Zhiyang Dou, Junting Dong, Lizhuang Ma, and Jingbo Wang. Go to Zero: Towards Zero-shot Motion Generation with Million-scale Data. In Proceedings of the IEEE/CVF International Conference on Computer Vision, 2025.
Han Liang, Wenqian Zhang, Wenxuan Li, Jingyi Yu, and Lan Xu. InterGen: Diffusion-based Multi-human Motion Generation under Complex Interactions. International Journal of Computer Vision, 2024.
Liang Xu, Xintao Lv, Yichao Yan, Xin Jin, Shuwen Wu, Congsheng Xu, Yifan Liu, Yizhou Zhou, Fengyun Rao, Xingdong Sheng, Yunhui Liu, Wenjun Zeng, and Xiaokang Yang. Inter-X: Towards Versatile Human-Human Interaction Analysis. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 22260–22271, 2024.
Resources and figure credits
- Numerical examples.
- SMPL paper: Figure 3. SMPL-X paper: Figure 1, selected panels. Body-model implementation; skinning.
- Rotation-representation paper: Figure 5, human-body IK panels.
- AMASS code; data license. BABEL project: sequence and interval annotation illustration.
- HumanML3D; feature extraction and recovery; rotation utilities.
- KIT dataset and versions; MotionMillion code; 272-dimensional recovery.
- InterGen project; preprocessing; dataset loader; model configuration.
- Inter-X project: Figure 2. Data structure.