CH-06 3D 人体动作理解
动作数据库保存的是关节轨迹、旋转或人体模型参数,而检索、自动标注和示范行为分析需要的是行为类别、事件顺序及部位关系。几何与语义并非一一对应。例如,同一行为可以由不同幅度和风格的轨迹实现,一个姿态也可能出现在不同的运动过程中。因此,语义推断需要从连续变化中提取与任务有关的证据,并区分可由观测确定的内容与依赖外部情境的信息。
Human Motion Understanding(人体动作理解)以运动观测为输入,估计动作类别、事件边界及自然语言语义等结构化信息;其中,Motion-to-Text(动作到文本,M2T)把运动与语言的关系建模为条件文本生成。输出任务决定所需的语义分辨率:分类可以概括为“行走”,描述“向前走两步,转身后抬起右手”则需要保留根轨迹、局部运动和事件顺序。本章先分析这些证据的可观测性,再展开序列翻译、跨模态检索和多粒度问答的表示与计算接口。
1. 运动证据与语义层次
1.1 一帧姿态与一段动作
设经过预处理的动作特征为
其中物理帧索引为 $t\in\{0,\ldots,T-1\}$,采样间隔为 $\Delta t=1/f$;$T$ 为有效帧数,$D$ 为每帧维度。文本位置用 $\ell$ 标记,压缩后的运动位置用 $i$ 标记,它们与物理帧之间通过编码器感受野建立对应关系。在 HumanML3D 常用表示中,$D=263$;这些维度包括根运动、局部位置、局部旋转、逐帧位移和足部接触。它们已经经过坐标规范化,不能直接当作任意来源的 SMPL 参数输入。
姿态是状态观测,动作类别通常还依赖状态导数与参照系。例如,降低重心与抬高重心可以经过同一半蹲构型,却具有相反的竖直速度;接近与远离目标可以具有相同局部步态,却对应不同的相对根速度。仅由一帧恢复动作语义属于欠定的逆问题:多个运动过程在该时刻产生相同观测。时序编码器的作用因此不是重复汇聚姿态,而是保留足以消除这些歧义的变化方向、事件次序和外部参照。
语义推断受输入的可观测性约束。纯骨架轨迹能够反映伸手的位置与方向,却通常无法确定目标物体的类别和状态。“拿起杯子”同时涉及人体运动、物体身份与接触状态;若输入只包含身体关节,物体类别便主要来自语言先验,而非直接观测。这种超出输入证据的语义补全,是 motion captioning(动作描述生成)中出现 hallucination(虚构语义)的重要来源。
1.2 事件、部位与时间
局部动作可以表示为带时间边界和身体部位的事件(event)。事件将连续轨迹分解为可描述的语义单元:
其中 $[a_k,b_k]$ 是时间区间,$\mathcal J_k$ 是相关关节集合,$v_k$ 是动词短语。例如,“右手抬起”可以对应某段时间内右肩、右肘与右腕的协同变化。多个事件还构成先后、重叠、重复和持续等关系。
事件划分依赖标注粒度与任务目标。同一段跑步既可分解为多个步态周期,也可整体标注为“向前跑”;简短描述通常只覆盖显著事件。因此,文本标注是对运动信息的语义选择,无法与逐帧几何建立唯一的一一对应关系。
1.3 时序聚合与顺序信息
事件语义依赖时序上下文。对未经时序编码的帧集合进行均值或逐通道最大池化,均满足 $A(PX)=A(X)$,其中 $P$ 为任意帧置换矩阵。聚合算子由此把许多不同轨迹映射到同一表示:若标签区分这些轨迹,任何只读取 $A(X)$ 的分类器都无法恢复被消除的次序。这是表征的非可逆性,而非增加解码器容量能够解决的优化问题。
重心高度下降序列及其时间反演提供了这一性质的一维投影。两者的均值、最大值和取值集合完全相同,净位移与平均速度则改变符号;算例由此区分姿态统计与有向运动证据。
1 | import numpy as np |
运行结果:
1 | mean height: down=0.7800, up=0.7800 |
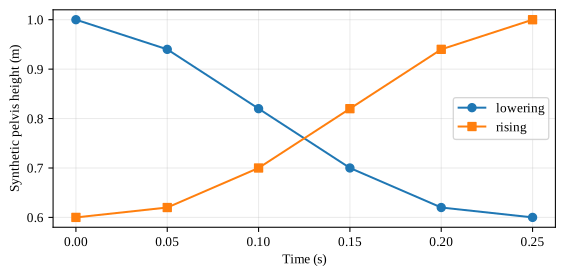
有限差分速度由逐帧位移除以采样间隔得到,等价于乘以帧率。HumanML3D 中部分命名为 velocity 的特征保存的是逐帧差分;其数值单位因而与以米每秒表示的速度不同。
不过,净变化量仍然是多对一映射。例如,先蹲下再站起与先站起再蹲下都可能具有零净位移。时序卷积以局部感受野编码变化,循环状态累积有序历史,带位置编码的 attention 建模跨事件依赖。对这些有序特征再做池化并不必然丢失全部顺序信息,因为次序已进入被聚合的通道;不可逆性发生在尚未保留时序关系便施加排列不变聚合的阶段。
2. 理解任务的输入与输出
在相同运动输入上,描述生成、跨模态检索和时间定位对应不同的预测空间。描述生成估计新文本的条件概率,检索计算候选之间的相关性排序,定位估计语义事件的时间边界;输出空间决定了网络接口与监督目标。
2.1 描述生成的条件分布
令描述 token 序列为 $Y=(y_1,\ldots,y_L)$,则 M2T 建模
动作编码器得到运动记忆 $H=E_m(X)$;文本解码器读取 $H$ 与已知文本前缀,预测下一个词。文本长度 $L$ 不必等于动作帧数 $T$。一个长动作可以对应一句简短描述,同一片段也可以有多条不同粒度的正确描述。
训练通常最小化参考描述的负对数似然。它提高参考词序列的概率,却不会显式比较所有可能的正确说法。例如,参考句写“举起右手”,模型写“将右臂抬高”,词汇不同不一定代表语义错误。
2.2 检索、定位与问答
检索计算动作与候选文本之间的相似度 $s(X,Y)$,再对有限候选集排序。它不必生成新句子,也不必具备文本解码器。文本检索动作与动作检索文本是同一相似度矩阵的两种查询方向。
时间定位进一步输出 $[a,b]$,回答某个短语对应哪段运动。问答则建模 $p(A\mid X,Q)$:问题 $Q$ 决定需要提取的证据,答案 $A$ 可以是短词、详细说明或结构化结果。多轮对话还要保留历史问题中的指代,例如“它重复了几次”中的“它”对应哪一个事件。
上述任务可以共享动作编码器,但评价指标各自对应特定能力。Recall@1 衡量有限候选集内的排序准确性,描述指标衡量生成文本与参考语义的对应程度,定位指标衡量时间边界误差。不同输出空间上的性能不能相互替代。
3. 双向序列翻译与动作离散化
3.1 循环模型的早期路径
描述生成需要连接连续运动与离散文字,Sequence-to-Sequence(序列到序列)提供了一种直接组织方式:编码输入序列,再按目标模态逐步解码。Plappert 等人的双向动作—语言映射使用深层循环网络,将二者组织为可相互转换的序列域。动作到文本方向压缩运动观测、逐词解码,文本到动作方向则交换输入与输出;配对数据由此直接提供运动语义监督。
循环序列模型受到长时记忆与跨模态监督差异的共同约束。固定维度状态需要压缩多个事件和部位变化;运动重建与文本分类又采用不同的输出空间和损失尺度。Attention 允许文本解码器访问多个运动位置,减轻单个循环状态承载全部运动信息的压力;动作压缩则降低运动端的序列长度。
3.2 TM2T 的动作词汇
长连续序列使编码器承担较大记忆负担,动作离散化则把若干帧压成较短的单元序列。TM2T 先量化运动,再建立动作单元与文本之间的翻译关系。设时序编码器输出
其中 $\{e_k\}_{k=0}^{K-1}$ 为 Codebook,$N$ 是压缩后的序列长度,$K$ 是 Codebook 大小。M2T 翻译器读取 $(c_1,\ldots,c_N)$,输出文本 token;动作重建器读取对应码向量,恢复连续特征。
动作 token 缩短了时序长度,并将连续特征转换为可通过 Embedding 查询的离散索引。其语义由编码器感受野、Codebook 和上下文共同决定:同一编号可以出现在多个动作类别中,同一行为也可能由多个编号组成。因此,学习得到的动作词汇与人工定义的行为标签具有不同含义。
动作量化改变了描述模型能够读取的证据。多个连续姿态被映射到同一编号后,语言解码器便无法仅由编号区分这些姿态。若语义标注 $Y$、原始轨迹 $X$ 与压缩编号 $C=Q(E_q(X))$ 构成 $Y\rightarrow X\rightarrow C$,数据处理不等式给出 $I(Y;C)\leq I(Y;X)$。在对数损失下,最优描述器使用 $C$ 而非 $X$ 所增加的条件熵为
该式针对既定数据分布与压缩映射,说明下游语言容量无法补回编码阶段已经删除的观测证据。全身平均重建误差较小,也可能掩盖短暂手势或左右差异的丢失。M2T 所需的失真度量因而应关注语义敏感的部位、事件边界与顺序;几何重建质量与语义充分性必须分别考察。对于含 $N$ 个、每个具有 $K$ 种取值的编号序列,名义容量为 $N\log_2K$ bits,实际信息量由编号分布及其时序依赖决定。理解任务中的 Rate–Distortion(率失真)问题,是在有限表示容量下保留与目标语义有关的信息。所有关节等权平均的坐标误差较小,并不意味着左右、次数和短暂手势等语义也被准确保留。
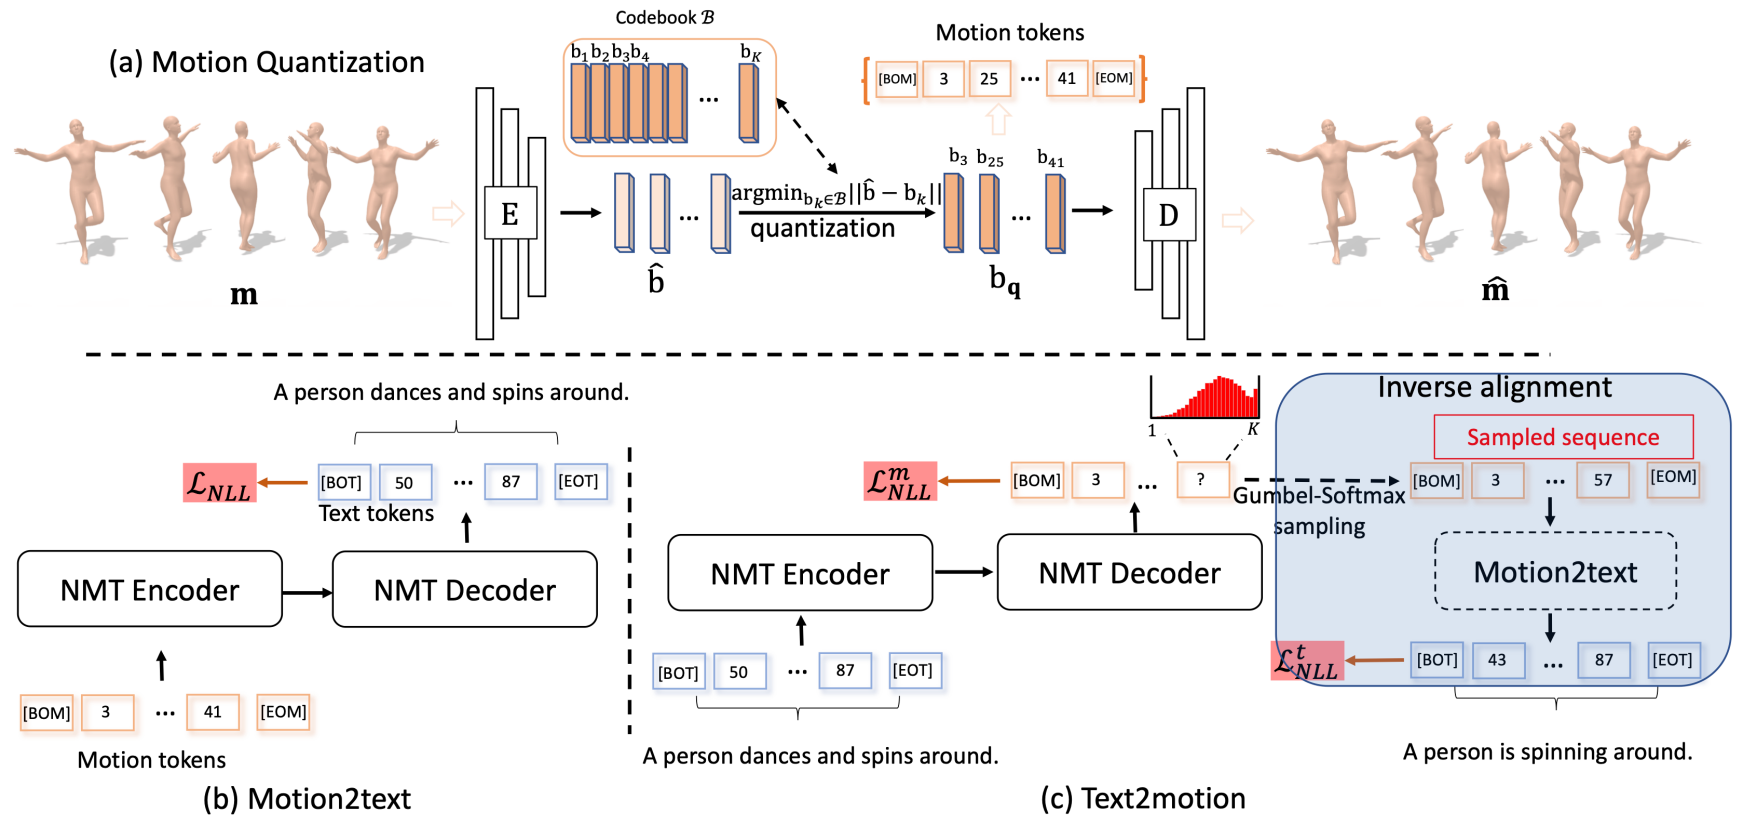
图中量化器首先通过运动重建学习局部时空单元;M2T 分支随后以 motion token 为条件预测文本。反向生成分支还将采样动作送入 M2T,利用生成描述与输入文本的一致性建立 inverse alignment。运动压缩、序列翻译和双向语义约束分别作用于不同计算阶段。
3.3 从动作编号到文本概率
具体计算中,量化后的动作编号形状为 [B,N],文本前缀形状为 [B,L]。以宽度 512 的 TM2T TransformerV2 为例,两端分别查表得到 [B,N,512] 与 [B,L,512],再加入位置编码。动作编码器保留整段有效上下文,输出记忆 [B,N,512];文本解码器读取这份记忆与文本前缀,输出 [B,L,512],最后线性投影为 [B,L,V_text] 的下一词 logits。
这一计算包含两类 mask。src_mask 根据动作 padding ID 构造,形状可广播为 [B,1,N];trg_mask 将有效文本位置与下三角 causal mask 相交,形状为 [B,L,L]。前者限制动作编码器及 cross-attention 的有效记忆,后者限制文本 self-attention 的可见前缀。BOS、EOS 和 padding token 分别属于动作端与文本端的词表。
训练以右移后的参考描述为条件,对有效下一词计算交叉熵;推理则将已生成词追加到前缀,直到 EOS 或长度上限。beam search 在候选前缀间比较累计概率,top-k 采样从截断后的条件分布取样。二者改变搜索或采样策略,不改变 [B,N,512] 运动记忆所包含的证据。与扩展语言词表的统一模型不同,TM2T 的动作端和文字端保留独立 Embedding 与独立符号空间;动作 ID 无需直接占用文字词表位置。
4. 文本解码与掩码计算
4.1 两种注意力的可见范围
完成动作编码后,文本解码器仍需按生成协议读取运动信息。描述整段已完成的动作时,动作编码器通常可以访问整段有效序列;文本解码器的 self-attention 则使用 causal mask,当前位置只能读取已知文本前缀。cross-attention 连接两端:查询来自文本状态,键和值来自动作编码结果。
对于一个注意力头,cross-attention 为
其中 $M_m$ 将补齐的动作位置置为负无穷。causal mask 作用于文本 self-attention,动作 padding mask 作用于动作记忆;前者防止未来目标泄露,后者防止补齐内容被当成真实观测。
在线描述还需对动作端施加观测截止时间约束,使每个输出只依赖截至当前时刻的运动。相较离线整段描述,在线描述的条件信息更少,且额外受到观测延迟影响,因而需要独立的评价协议。
4.2 Teacher Forcing 与有效位置损失
Teacher Forcing(真实前缀监督)在训练时提供正确文本前缀,并把下一词作为预测目标。例如,输入 [BOS, y1, y2, y3] 对应目标 [y1, y2, y3, EOS];推理时则读取模型自己的历史输出。padding 位置不参与交叉熵,但 EOS 是一个需要学习的有效目标。
合成运动记忆与文本前缀构成一个受控的注意力算例。分别扰动 padding 记忆及未来文本位置,可以检验输出是否仅依赖掩码允许的输入子集。
1 | import torch |
运行结果:
1 | logits shape: (1, 4, 12) |
输出不变性揭示了 attention mask 的函数依赖约束。在精确屏蔽和有限数值的条件下,已有位置的输出对未来文本 Embedding 的偏导为零,对 padding 运动记忆的偏导也为零。算例中的两种扰动分别检验这两个依赖关系。causal mask 只限制文本生成的 autoregressive 条件;离线 M2T 的运动编码器仍可读取全部有效物理帧。
Teacher Forcing 在数据前缀上训练,推理则沿模型前缀展开,二者的条件分布差异形成 exposure bias。早期部位或事件判断错误会改变后续词分布,使局部错误传播为整句语义偏移。它与 mode collapse 有不同含义:后者指生成分布遗漏了条件下的多种合理模式;即使每条生成句都很稳定,模型仍可能只输出高频的简短描述。
4.3 解码策略与描述长度
greedy decoding(贪心解码)在每一步选择概率最大的词;beam search 保留若干前缀,比较累计对数概率;采样则允许输出多种描述。M2T 的参考描述本来就不是唯一,增加多样性可以覆盖不同表达,但也可能引入额外事件。
描述长度增加会扩大需要核实的语义集合。例如,由“伸手”扩展为“高兴地拿起桌上的杯子”同时引入情绪、目标物体与场景属性。若这些属性缺少输入证据,语言流畅性便可能掩盖语义错误。因此,解码长度与停止条件应对应标注粒度,细粒度评价需区分正确细节、遗漏与 hallucination。
5. LaMP 的语言—运动预训练
5.1 Contrastive Learning、Matching 与双向翻译
翻译器能够学习配对关系,输入表征本身是否适合运动语义同样重要。静态图文预训练的文本特征可以识别“人”“跑步”等概念,但未必充分表达“先转身再坐下”的时序关系。LaMP 使用语言—运动成对数据进行联合预训练,使两端表征围绕运动内容对齐。
LaMP 预训练包含四个相互补充的目标:Contrastive Learning(对比学习)组织跨模态距离,Matching 判断输入是否正确配对,M2T 与 T2M 则分别要求编码结果能够支持另一模态的生成。具体而言,对比目标首先在批次内拉近匹配样本:查询特征与文本特征投影到同一空间,取查询中最相关的相似度建立跨模态分类;其次,匹配目标从相似度分布中抽取困难负例,判别一对运动与文字是否相符。最后,两个翻译目标分别预测文字和量化后的运动编号,使表征保留能够恢复另一模态的信息。
实现这四类目标时,Q-Former 使用不同的 attention 可见范围。对比计算先分别提取运动查询与文字特征,再比较匹配与非匹配样本;Matching 允许二者联合交换信息,分类头判断是否配对;翻译目标允许目标前缀读取源模态,同时屏蔽未来目标,避免答案泄漏。若 $u_{i,r}$ 是第 $i$ 条运动的第 $r$ 个归一化查询特征,$v_j$ 是第 $j$ 条文字特征,对比相似度为
查询维上的最大值选择与当前文字最相关的运动特征,批次内的交叉熵再强化正确配对。Matching 的负例根据当前相似度采样,使模型不仅区分类别差异显著的动作,也学习辨别表面相近的错误配对。
查询 token 把较长的运动特征汇聚为供语言模型读取的表示。设 $H_m\in\mathbb R^{N\times d}$,可学习查询为 $Q_0\in\mathbb R^{R\times d}$,则 cross-attention 得到 $R$ 个运动相关特征。$R$ 较小有助于压缩上下文,但每个查询并不天然等于“左手”“右脚”等具名部位。
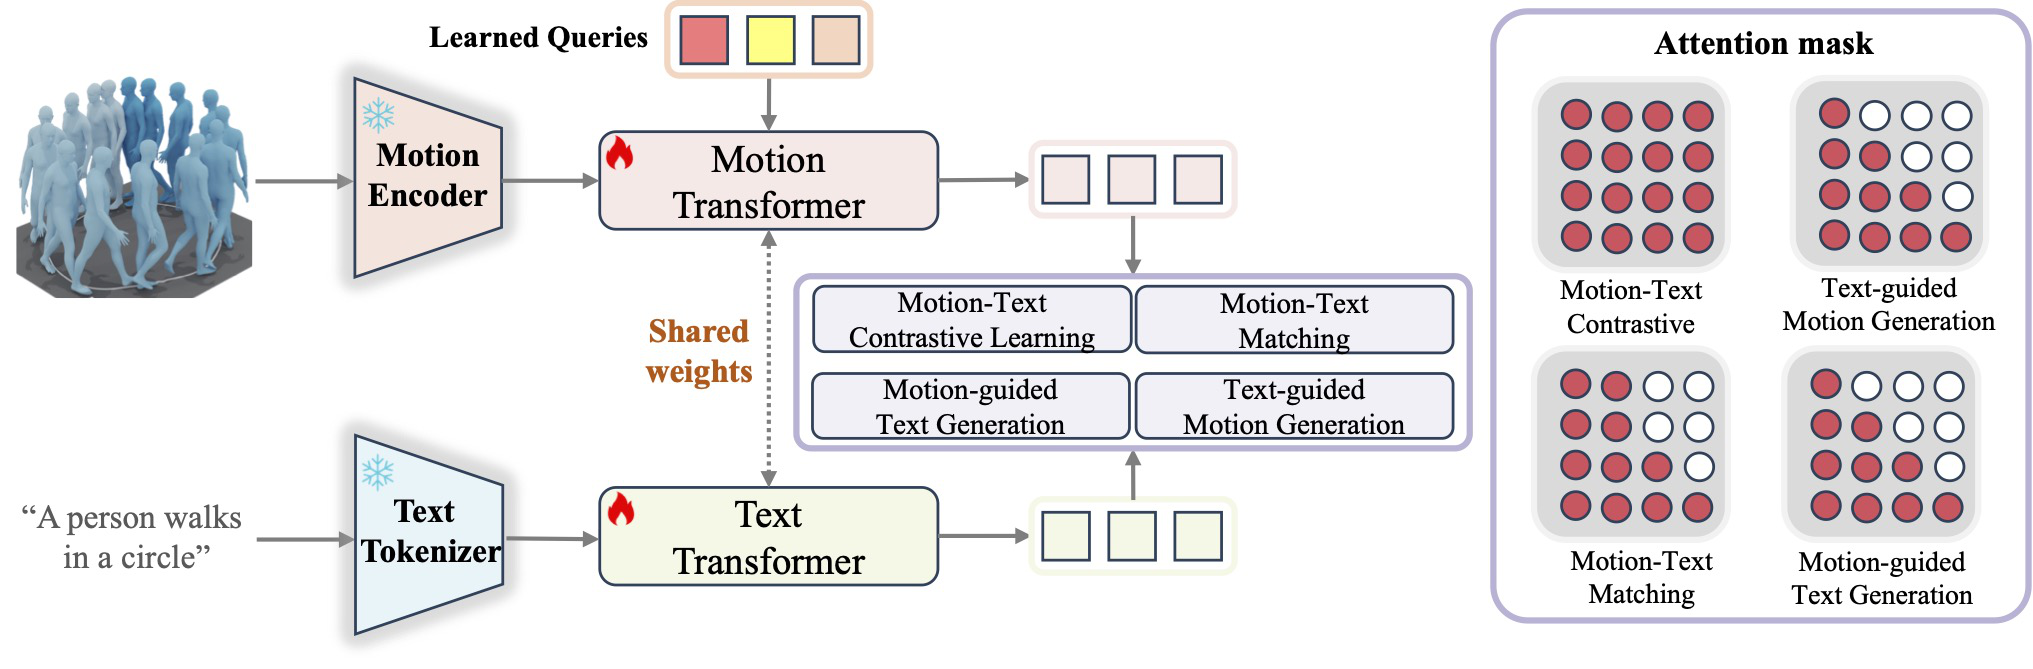
5.2 描述分支与生成分支
LaMP 的描述分支将语义相关的运动特征投影为语言条件,生成分支则使用针对运动学习的文本条件。共同预训练为两个方向提供可迁移表征,但迁移收益取决于目标兼容性;两个下游分支共享表征,并不等价于在同一 autoregressive 序列中交替生成文字与动作。
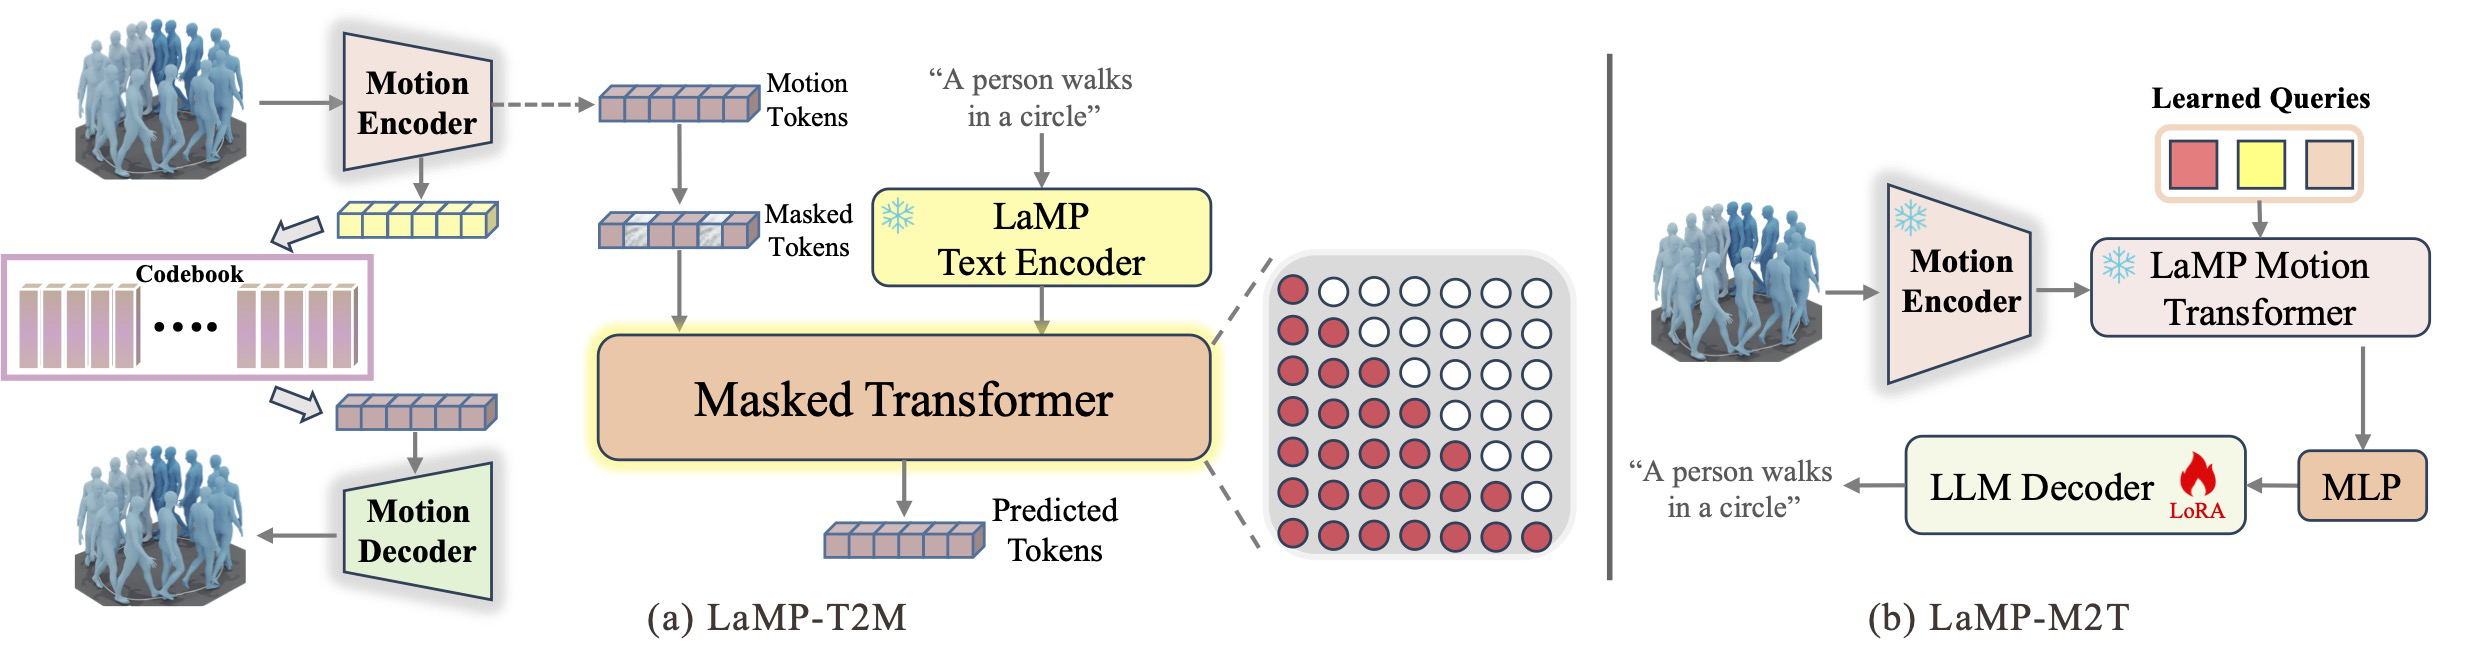
以描述分支的一段等长运动为例,输入 [B,T,263] 先转为通道在前的排列,经冻结的运动编码器下采样四倍,得到 [B,N,512],其中 $N=T/4$。线性投影把通道扩展到 1408,作为 Q-Former 的运动记忆;49 个可学习查询读取这份记忆,输出 [B,49,768],再投影为 OPT-2.7B 接受的 [B,49,2560] 前缀 Embedding。这 49 个位置压缩整段运动,与原始帧数和关节数没有逐一对应关系。
训练将运动前缀与正确文本 Embedding 拼接为 [B,49+L,2560],语言模型在因果上下文中预测下一词。运动前缀的标签全部设为 -100,文字 padding 也被忽略,交叉熵只监督有效文字。这个接口把运动记忆设为全部可见,文字端另外保留 padding mask;因此运动裁剪与长度处理应在进入编码器之前保持一致。运动编码器冻结,语言模型通过 LoRA 适配,投影与查询模块连接两个表征空间。
运动查询前缀可写为
该前缀与文字 Embedding 沿序列轴拼接,成为语言模型生成描述的连续条件。可学习查询决定如何从运动记忆提取任务信息,投影层匹配语言骨干所要求的通道宽度;自然语言任务指令则指定预测目标。二者分别承担连续条件适配与语义控制,不能混为同一种 Prompt。损失促使它们在下游预测意义上对齐,不保证两个模态的几何结构被等距或可逆地映射。
推理先计算运动查询前缀,再逐词生成描述。beam search 保留多个文字候选,采样可产生不同表达;两者都受同一运动证据约束。生成分支另用语言—运动预训练得到的文字特征调节掩码动作模型,预测对象是动作编号。因此,图中的共享基础在两个分支中通向不同的输出头。
LaMP-BertScore 先通过 M2T 模型描述生成动作,再计算该描述与条件文本的 BERTScore。中间描述为分数提供可读的语义依据,但整个度量同时受到 captioner 与文本相似度模型的影响:captioner 遗漏的事件不会进入后续比较,错误的语义补全也可能提高文本相似度。因此,该指标衡量的是两级模型中的语义一致性。
6. TMR 与跨模态检索
6.1 定长表征与相似度矩阵
描述生成需要逐词解码,检索则可以直接比较动作与文字的整体表征。TMR 延续 TEMOS 的文本条件动作合成框架,并加入文本—动作对比学习,使定长向量用于候选排序。TEMOS 主要解决文本生成动作,TMR 主要强调检索;这里的接口与 M2T 的文字解码不同。
设动作表征为 $u_i$,文本表征为 $v_j$,归一化后计算
矩阵的行对应动作到文本检索,列对应文本到动作检索。余弦相似度衡量向量方向的一致程度,不是校准后的匹配概率;候选集合变化会改变排序,却不改变固定向量对的余弦值。
一种常见对比目标是
其中 $B$ 为批次大小,$\tau>0$ 为温度;加入文本到动作的反向目标可得对称损失。批次中具有相同语义的两个动作可能被错误地当成负样本,因此负样本的构造和筛除会直接影响学习结果。
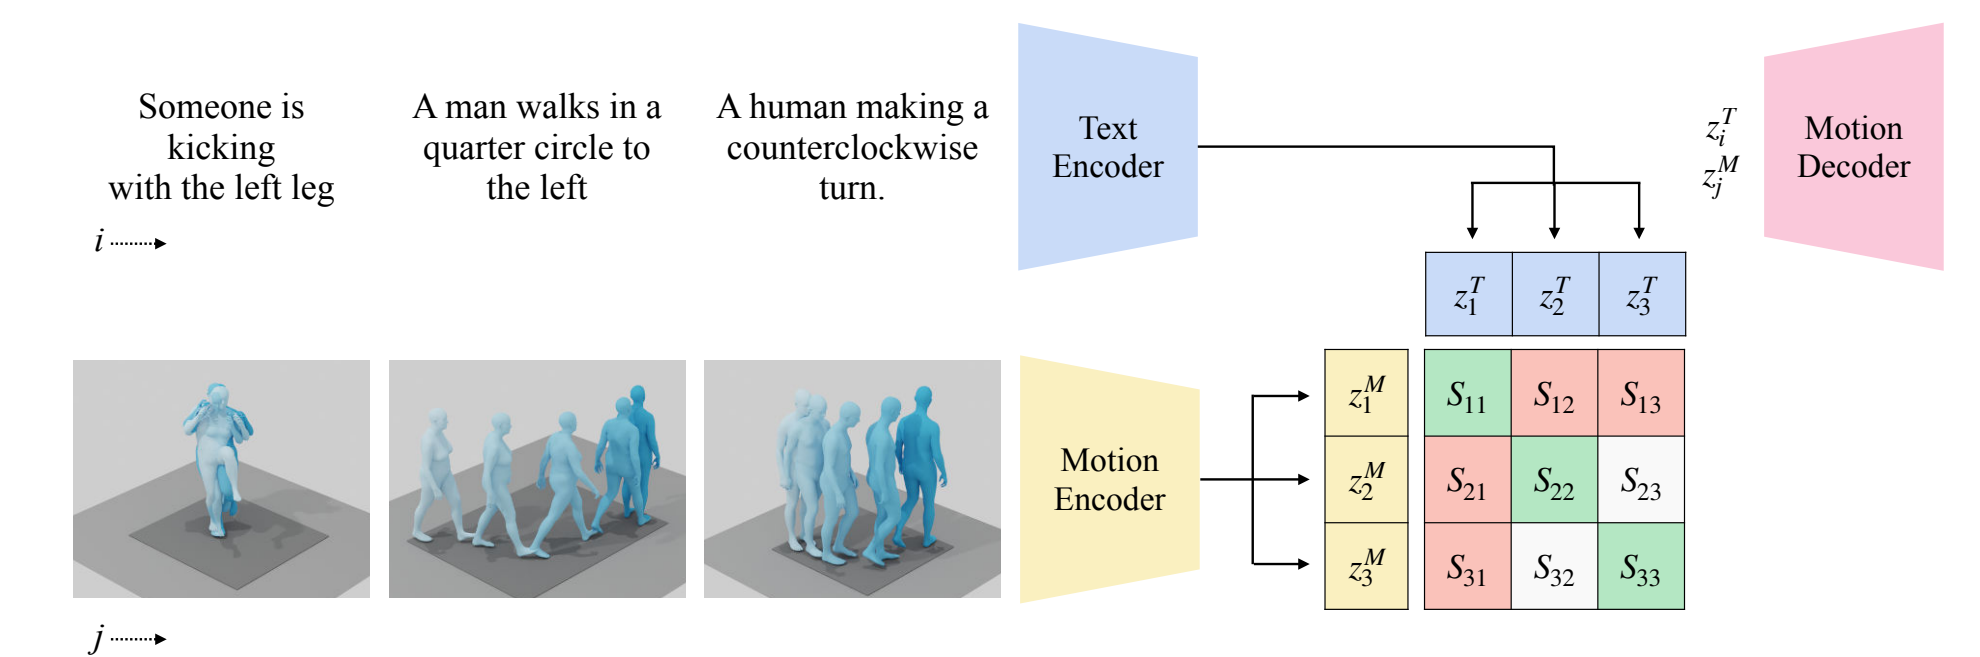
图中第二句描述向左走过四分之一圆,第三句描述逆时针转动,两者可能表达相近的运动。若仅因它们来自不同配对就强制相互远离,模型会收到不合适的负例。因此,相似度矩阵除了对角线上的正例,还需要判断哪些非对角项适合用于区分。
6.2 双编码器中的张量变化
TMR 使用两个独立编码器建立共享 Latent Space,使运动与文字经过不同输入通路后,可以用同一距离函数比较。HumanML3D 动作特征 [B,T,263] 经线性投影变为 [B,T,256];冻结的 DistilBERT 先给出文字特征 [B,L,768],文字编码器再将其投影到 256 维。两端各添加两个可学习分布 token,形成 [B,T+2,256] 和 [B,L+2,256]。四层 Transformer 读取各自的有效序列,取前两个位置作为均值与对数方差,得到形状均为 [B,256] 的分布参数。
在两端的编码过程中,有效位置掩码中 True 表示有数据,新增分布 token 始终有效;传给 PyTorch 的 src_key_padding_mask 则取反,使 True 表示需要忽略。这里使用双向编码,因为检索查询与候选动作已经完整给定。定长表征不依赖时间均值,而由分布 token 对带位置编码的序列进行汇聚。
检索使用均值向量,归一化后形成 [B,B] 的相似度矩阵。动作库可以预先编码,查询到达时只计算文字向量及其与库向量的相似度。动作解码器在训练中提供运动监督,检索时无需逐个重建候选动作。
6.3 合成监督与对比监督
训练同时使用两端潜变量恢复同一条动作。解码器为目标长度建立 [B,T,256] 的时间查询,把 [B,1,256] 潜变量作为记忆,经注意力和线性输出层恢复 [B,T,263]。文本到动作与动作到动作两条路径都使用 Smooth L1 重建目标;潜变量一致性约束二者靠近,KL 项约束两端分布相互接近并靠近标准正态分布。
对比目标进一步组织整个批次。InfoNCE_with_filtering 利用独立的句子相似性筛除部分假负样本,再对相似度矩阵的行和列分别计算交叉熵。合成监督要求 latent 保留可恢复的运动信息,对比监督要求它们支持候选区分。用 $\mathcal L_{\mathrm{rec}}$ 汇总文字到动作和动作到动作的重建损失,完整目标可组织为
$\mathcal L_{\mathrm{latent}}$ 拉近配对运动与文字的 latent;KL 项分别约束两端分布与共同先验,并比较两端分布。只有对比损失时,相似度可能满足候选排序却忽略细节;加入重建监督,则要求用于排序的表示同时保留可解码的运动内容。
事件集合与事件次序可以通过低维投影加以区分:算例的前两个坐标表示事件是否出现,第三个坐标表示先后顺序。删除第三维后,两个时间方向是否仍可区分,完全由剩余表示决定。
1 | import numpy as np |
运行结果:
1 | event-set scores: |
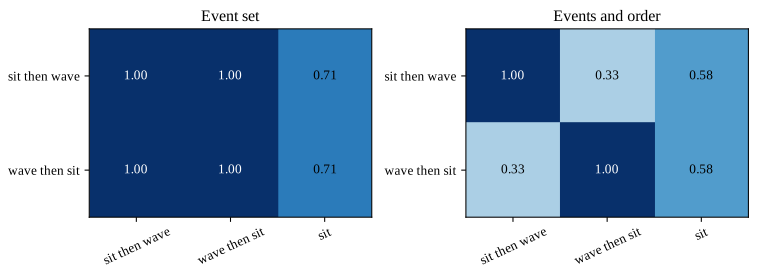
删除第三个坐标相当于把两个有序事件投影到同一等价类,因此任何基于该二维表示的相似度都不能区分它们。加入顺序坐标后,两个方向的余弦相似度分别为 1 与 $1/3$,正确配对获得间隔。真实模型需要从轨迹学习具有这种判别性的时序表征;增大温度缩放或更换检索算法,均无法分离已经重合的输入表示。
7. 时间顺序与细粒度语义
7.1 CAR 的时间挑战
检索难度由候选之间的语义差异决定。“蹲下,然后伸展双臂”与“伸展双臂,然后蹲下”包含相同的事件集合,却具有相反的时间顺序。仅包含跑步、跳跃和坐下等类别差异的评价集,无法充分检验这种时序辨别能力。
CAR(Chronologically Accurate Retrieval)围绕这一问题构造时间顺序相关的对比与评价。把描述分解为事件并改变排列,可以得到词汇相近但时间关系不同的候选文本。模型必须依据运动过程识别与之对应的描述,而不是依靠某个显著动词完成匹配。
事件打乱需要控制数据质量。如果原句包含同时发生的动作,交换短语不一定改变语义;如果重写引入了原句没有的细节,负样本就同时改变了顺序与内容。时间顺序评价需保持事件内容一致,并确认事件之间具有可辨别的先后关系。
7.2 左右、次数与幅度
细粒度理解至少可以分解成身体部位、方向、次数、持续时间和事件顺序。例如,把“右手抬起”改成“左手抬起”检验部位识别;把“两次跳跃”改成“一次跳跃”检验事件计数;把“向前走”改成“向后走”则还涉及人物局部坐标与世界坐标的定义。
镜像增强时,骨架与文字必须同步变化。只对动作做镜像、保留“右手”不变,会向模型提供矛盾监督。旋转规范化也会改变空间解释:去掉世界朝向可以帮助学习一般动作语义,但若仍要回答“朝房间北侧走”,必须额外保留场景参照。
时间边界的误差以秒衡量更便于比较。对于 20 FPS 的序列,偏差四帧是 0.2 秒;换成 12.5 FPS 时,四帧对应 0.32 秒。相同帧数误差在不同采样率下代表不同的时间精度。
7.3 定位监督与注意力权重
cross-attention 矩阵提供了文本位置与运动位置之间的关联,但不自动产生可靠的事件区间。注意力可能集中到边界标记、显著姿态或高度相关的背景片段,多层多头之间也会存在不同分工。
事件定位需要显式的边界预测、区间选择或结构化生成接口,以及对应的时间标注与损失。Attention map 可用于观察模型的信息聚合位置,但注意力权重与事件时间区间并不存在预先确定的等价关系,也不能直接视为因果解释。
8. 多粒度描述与对话理解
8.1 MotionLLM 与 MoChat
整段描述通常只覆盖显著行为,无法预先包含每一个局部问题所需的信息。对话理解因此以问题和历史轮次为条件,选择相关事件、身体部位及时间范围。MotionLLM 将运动与视频纳入共享语言模型:运动输入突出人体几何,视频输入补充物体和环境信息。两种模态通过各自的编码器与 translator 进入语言空间;一次推理使用其中一种输入,共享训练使两类数据共同参与语义建模。
面向身体部位的细粒度问题,MoChat 使用按解剖结构分组的骨架编码器,分别构建空间与时间感知表征。分组特征使左臂、躯干和下肢等区域的运动证据进入细粒度问答;对话历史则为追问和指代消解提供语言上下文。
对话答案可进一步区分为观测描述与意图推断。“人物右手抬到肩部附近”具有直接的几何依据;“人物准备与朋友打招呼”涉及对象关系与意图假设。二者所需监督和可验证条件不同,应分别定义评价目标。
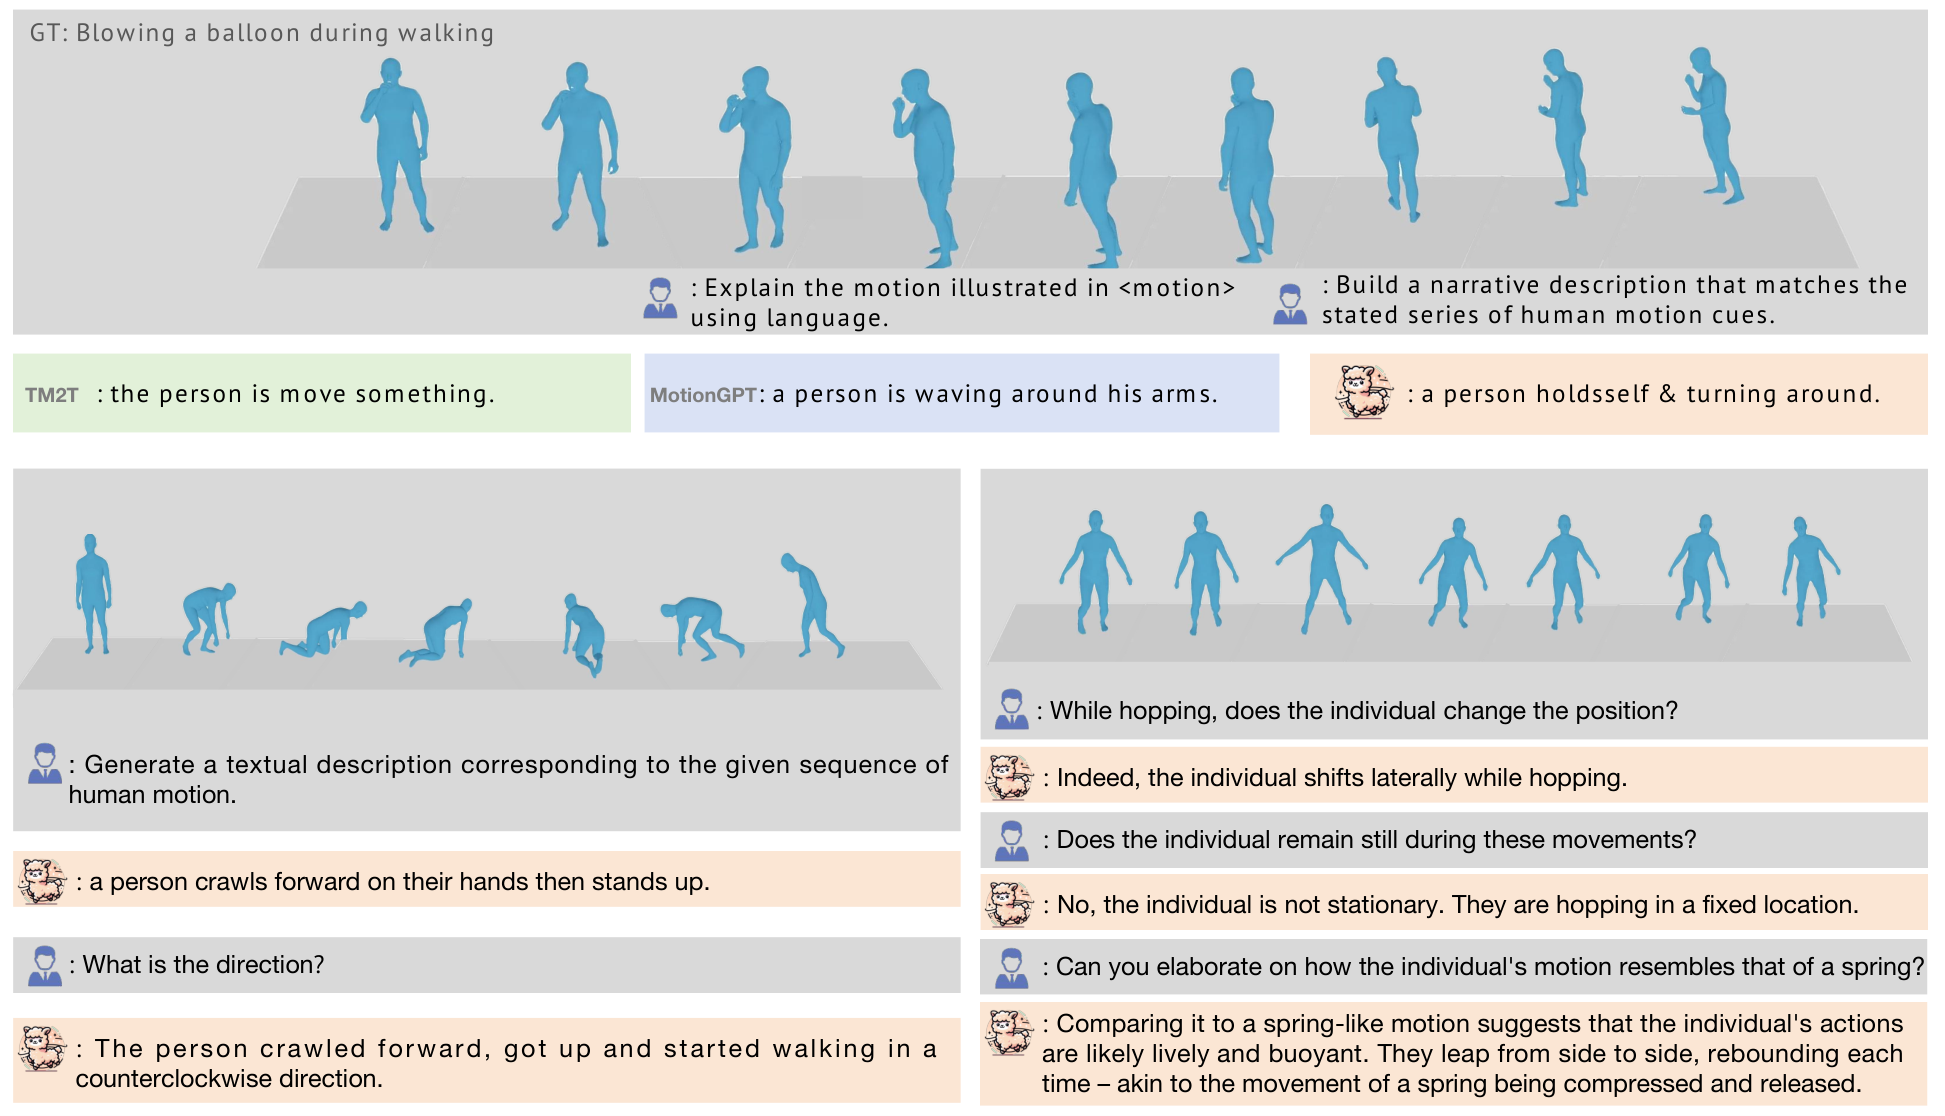
左下序列中的站立、俯身、爬行与起身形成连续事件,描述模型需要将局部姿态变化组织为时间有序的谓词。右下问题进一步区分关节运动与整体位移:身体持续跳动并不意味着根位置持续改变。此类问答要求模型在语言上下文中保持空间参照的一致性。
8.2 MG-MotionLLM 的粒度接口
MG-MotionLLM 同时组织粗粒度与细粒度的动作理解、生成任务。粗粒度描述概括整段动作;详细描述提供身体区域与局部时间变化;定位任务建立细节文字与动作区间的对应关系。FineMotion 的细粒度文字增强了常见短描述数据中不充分的监督。
MG-MotionLLM 通过运动 VQ 编码器将轨迹变为离散 motion token,T5 根据任务指令生成普通描述或详细描述;两类目标分别组织监督与评价。普通文字要求保留整体行为,详细文字进一步要求部位、时间与幅度信息。设两个目标在共享参数上的梯度为 $g_{\mathrm{coarse}}$ 与 $g_{\mathrm{fine}}$,负内积说明局部下降方向发生冲突:沿一方的负梯度更新,会提高另一方的一阶近似损失。多任务收益因此取决于任务采样、损失尺度及共享参数范围,而不是目标数量;具体的加权更新条件在统一建模一章展开。
细粒度文本的监督价值取决于其与轨迹的对应精度。自动扩写可能补充部位、时间和方向信息,也可能引入未经观测支持的内容。评价 detailed captioning 时,应分别统计正确细节、遗漏和 hallucination,避免将描述长度作为信息准确性的替代量。
9. 变长运动与语义上下文
9.1 帧长度、压缩长度与文本长度
描述模型同时处理三种长度:动作帧数、编码后的运动单元数和文本 token 数。例如,20 FPS、160 帧的片段按帧数除以帧率的覆盖时长约定计为 8 秒;首末采样时刻的间隔则为 159/20=7.95 秒。以 263 维表示时,输入为 [160,263]。若批次补齐到 196 帧,后 36 帧只是计算占位,运动编码器与损失仍需使用有效长度 160。
在帧长度之外,时序压缩进一步决定运动单元的序列长度。四倍下采样可以把与该长度协议匹配的 160 帧压成 40 个运动单元,边界符号随后另行添加。文本描述的长度由语言内容决定:八秒动作既可能用一个动词概括,也可能需要多个短语表达事件顺序。运动位置与文本位置通过注意力建立关联,而非一帧对应一个词。
9.2 归一化与恢复
运动特征先按训练集统计量标准化,再进入编码器;有效长度与时间掩码随批次一起传递。对于离散翻译器,连续特征还要经过量化器得到运动编号;对于连续查询接口,运动特征直接形成语言模型读取的记忆。两条路径的最终目标都是保留描述所需的信息。
坐标恢复沿相反路径进行:反标准化动作特征、累积根运动、重建关节位置,并保留原始帧率。根轨迹与身体朝向共同确定前进或后退,局部关节轨迹确定部位动作;将文本事件映射到对应时间区间,可进一步分析描述中的方向、顺序和部位误差。
10. 评价指标与失败分析
10.1 文字相似性与语义正确性
文本评价包括表达相似性与语义准确性。BLEU 比较 n-gram 重合,ROUGE 衡量参考内容覆盖,CIDEr 利用语料统计衡量描述一致性,BERTScore 比较上下文词表征。这些指标都依赖参考文本:参考描述遗漏的事件,即使被模型正确识别,也未必提高相似度分数。
部位、方向或次数错误可能只改变少量 token,却显著改变动作语义。例如,“左手”与“右手”的互换仍保留大部分词汇重合。因此,自动文本指标还需结合细粒度语义标注,区分事件遗漏、属性错误与 hallucination。
10.2 检索与定位的独立协议
Recall@K 表示正确匹配落在前 $K$ 名中的比例,其含义取决于候选集、查询方向和正例定义。十个候选与整个测试集的 Recall@1 不具有相同难度;存在多条正确描述时,单正样本评价还会低估结果。
对于正持续时间的参考区间与预测区间,时间定位通常比较二者的 temporal intersection over union(tIoU):
端点、持续时间与有效帧定义应在同一协议下处理。一个短暂手势对边界误差更敏感,平均 tIoU 因而需要结合事件长度查看。
10.3 运动信息与语义错误
从上述评价结果定位错误时,可以分别检查空间参照、部位细节和时序表征。方向混淆常与空间参照丢失有关:根轨迹或人物朝向没有保留时,局部步态难以区分向前与向后。部位细节的遗漏可能来自关节映射和运动压缩;短暂的右手变化若被平滑或量化抹去,语言端就缺少相应证据。时序表征不足又会使相同事件集合被当作同一种动作,混淆“坐下后站起”与“站起后坐下”。
语言先验可能将高频共现关系转化为未观测语义。例如,伸手与拿取在训练文本中经常共现,模型便可能把手臂轨迹描述为“拿起杯子”。这种 hallucination 并不一定伴随语言质量下降。动作理解因而需要同时满足表征充分性与语义忠实性:前者决定运动证据能否保留,后者决定输出是否受这些证据约束。
参考资料
Matthias Plappert, Christian Mandery, and Tamim Asfour. Learning a Bidirectional Mapping Between Human Whole-Body Motion and Natural Language Using Deep Recurrent Neural Networks. Robotics and Autonomous Systems, 109:13–26, 2018.
Chuan Guo, Xinxin Zuo, Sen Wang, and Li Cheng. TM2T: Stochastic and Tokenized Modeling for the Reciprocal Generation of 3D Human Motions and Texts. In Computer Vision – ECCV 2022, 2022.
Mathis Petrovich, Michael J. Black, and Gül Varol. TEMOS: Generating Diverse Human Motions from Textual Descriptions. In Computer Vision – ECCV 2022, 2022.
Mathis Petrovich, Michael J. Black, and Gül Varol. TMR: Text-to-Motion Retrieval Using Contrastive 3D Human Motion Synthesis. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 9488–9497, 2023.
Kent Fujiwara, Mikihiro Tanaka, and Qing Yu. Chronologically Accurate Retrieval for Temporal Grounding of Motion-Language Models. In Computer Vision – ECCV 2024, 2024.
Ling-Hao Chen, Shunlin Lu, Ailing Zeng, Hao Zhang, Benyou Wang, Ruimao Zhang, and Lei Zhang. MotionLLM: Understanding Human Behaviors from Human Motions and Videos. arXiv preprint arXiv:2405.20340, 2024.
Jiawei Mo, Yixuan Chen, Rifen Lin, Yongkang Ni, Min Zeng, Xiping Hu, and Min Li. MoChat: Joints-Grouped Spatio-Temporal Grounding LLM for Multi-Turn Motion Comprehension and Description. arXiv preprint arXiv:2410.11404, 2024.
Zhe Li, Weihao Yuan, Yisheng He, Lingteng Qiu, Shenhao Zhu, Xiaodong Gu, Weichao Shen, Yuan Dong, Zilong Dong, and Laurence Yang. LaMP: Language-Motion Pretraining for Motion Generation, Retrieval, and Captioning. In International Conference on Learning Representations, 2025.
Bizhu Wu, Jinheng Xie, Keming Shen, Zhe Kong, Jianfeng Ren, Ruibin Bai, Rong Qu, and Linlin Shen. MG-MotionLLM: A Unified Framework for Motion Comprehension and Generation across Multiple Granularities. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 27849–27858, 2025.
Resources
- Numerical examples.
- TM2T: Repository, Transformer implementation, M2T inference.
- TMR: Model, Encoders and decoder, Contrastive objective.
- LaMP: Repository, Pretraining objectives, Captioning branch.
- CAR repository, MotionLLM repository, MG-MotionLLM repository, MG-MotionLLM M2T implementation.
Figure credits
- TM2T architecture: Figure 2 from the ECCV 2022 paper; caption excluded.
- LaMP pretraining and downstream architectures: official project.
- TMR retrieval and synthesis: Figure 2 from the ICCV 2023 paper; caption excluded.
- MotionLLM qualitative motion comprehension: Figure 7 from the author manuscript.