CH-03 文本驱动的单人动作生成
自然语言可以描述动作的类别、顺序与身体部位,但通常不会完整指定三维运动轨迹。例如,“一个人向前走,随后转身并抬起右手”仍允许不同的步幅、转身半径、行走速度与各阶段时长。将这类描述用于驱动虚拟角色,需要补全未被语言确定的运动变量,并使各关节在时间上协调变化。文本驱动的动作生成(text-to-motion,T2M)以此为目标,根据文本条件学习三维运动的条件分布,在多种符合描述的轨迹中产生具体样本。
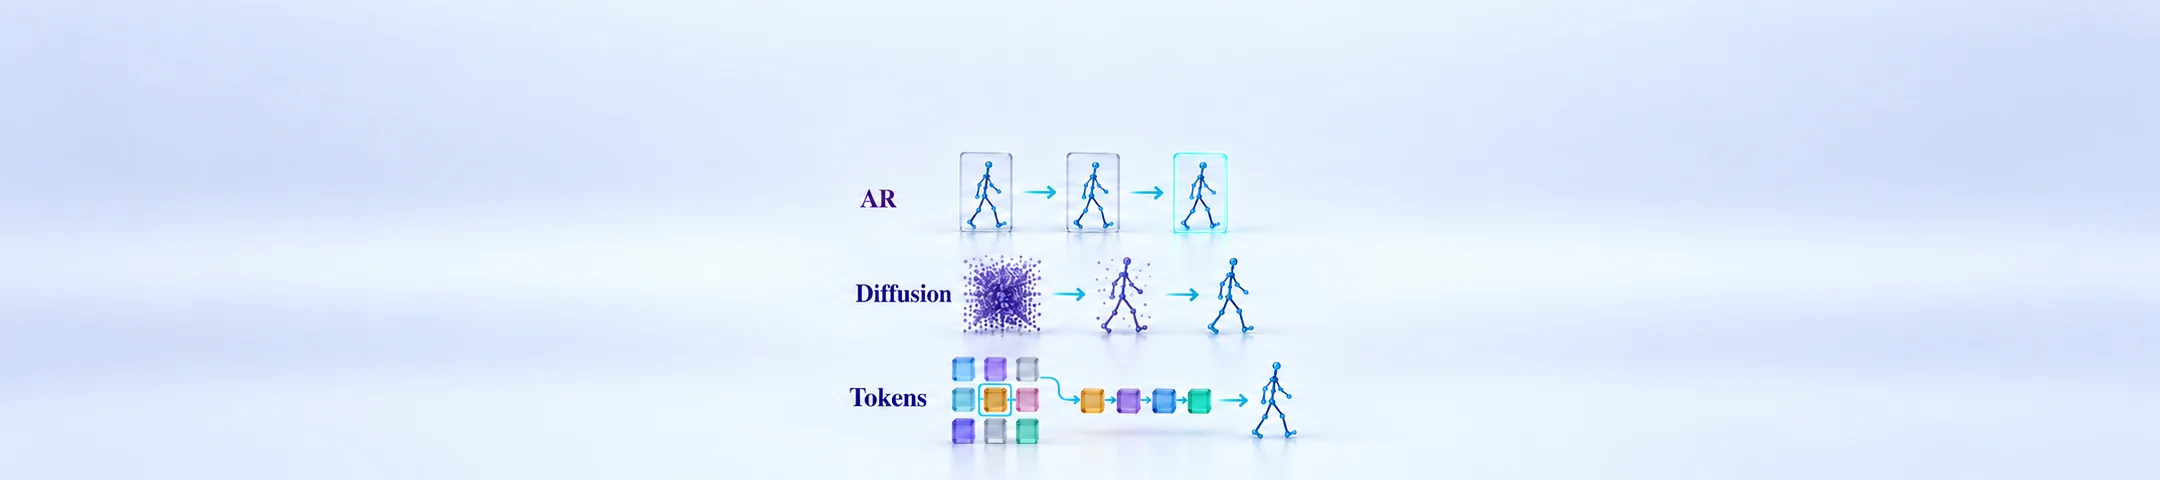
这些未确定变量受人体结构与运动连续性约束。例如,右手抬起时,肩、肘和腕的构型相互关联;行走时,身体平移、足部接触和腿部摆动也必须协调。前两章建立的运动表示与序列建模由此连接到条件生成:模型可以逐段预测、联合去噪整段动作,或生成压缩后的 motion token,再经相应的几何恢复过程得到可见运动。不同路线的区别,在于条件分布的分解方式、表示压缩产生的失真,以及误差沿生成过程的传播机制。
1. 文本条件、动作长度与多解性
设文本为 $c$,动作序列为 $X=(x_0,\ldots,x_{T-1})$,每帧特征 $x_t\in\mathbb{R}^D$。物理帧索引 $t\in\{0,\ldots,T-1\}$ 对应采样时刻 $t\Delta t$,其中 $\Delta t=1/f$。$D$ 可以是关节位置展开后的维度,也可以是根运动、位置、旋转和接触的复合特征维度。生成任务可写成
这一分解区分了长度分布与给定长度的运动分布;实现中可以使用独立模块,也可以通过同一生成器联合建模。具体而言,有的接口要求用户指定帧数,有的先预测长度,还有的逐步产生动作 token 并预测结束标记。例如,输入“跑两步”时,模型还需区分动作次数与输出长度:把序列截成两秒不能保证恰好两步。
帧率决定时间含义。按每帧占据一个播放周期计,20 fps 下80帧的播放时长为4秒,30 fps 下为约2.67秒;首末采样时刻之差则为 $(T-1)\Delta t$。训练长度约束、生成帧数与播放帧率分别决定可生成的范围、序列大小和实际时长。为构造批量张量,短序列通常 padding 到 $T_{\max}$,有效帧掩码为
本章区分三种索引:$t$ 表示 $T$ 个物理帧中的位置;$\ell\in\{0,\ldots,K-1\}$ 表示 $K$ 个压缩片段或 motion token 中的位置;$k\in\{0,\ldots,N_d\}$ 表示离散扩散噪声级。连续生成时间使用 $s\in[0,1]$,它参数化噪声路径,并不具有秒的单位。若时间压缩倍率为 $u$,一个 token 通常对应约 $u\Delta t$ 的运动区间,而一次去噪更新不会使人物在物理时间上前进一帧。
有效帧掩码首先限制重建损失与评价统计;采用注意力 padding mask 的网络,还需屏蔽无效键值。两种掩码的作用不同:前者规定哪些输出接受监督,后者规定网络可以读取哪些位置。生成结束后的无效帧不参与骨长、速度和文本匹配统计。
除了有效长度,数据进入网络前还要统一坐标和尺度。以 HumanML3D 的263维表示为例,预处理先确定地面与初始朝向,再计算根运动、根相对关节位置、6D 旋转、关节速度和足部接触,最后用训练集均值与标准差逐维标准化。若一条描述只对应原运动的某个时间区间,动作裁剪与文字配对必须使用同一区间。批量输入由此成为 [B,T,263],同时保留 [B] 的有效长度;反标准化与根轨迹恢复则构成输出端的逆过程。
评价生成结果时,多样性还需区分两种口径。不同描述产生不同动作,反映整体分布的覆盖;同一描述重复采样得到多个正确动作,反映条件分布内部的多解性。条件多样性的评价以语义一致性为前提;偏离描述的样本扩展了输出分布,却未提高目标条件下的覆盖率。
2. 动作片段与层次化变分生成
建立条件分布的一种早期思路,是先预测长度,再逐段组织运动。直接逐帧生成时,每一步都要决定大量关节特征;motion snippet code 将相邻数帧的局部动态压缩为潜变量,降低时序生成器每一步需要预测的维度。这里的 latent(潜变量)是编码器学习的低维向量,Latent Space 指这些向量所在的表示空间。编码器以运动重建为目标学习片段特征,不预设固定动作类别;能够保留的细节取决于时间感受野、latent 维度和训练动作的分布。
具体而言,这种生成过程由 Text2Length 与 Text2Motion 分别承担长度预测和内容生成。前者根据文本估计长度的离散分布,后者在选定长度下生成运动片段,再由运动解码器恢复逐帧特征。长度通常以片段单位处理,最终再转换到动画帧。两种模块使用配对动作与文字学习;HumanML3D 的原始配对包含14,616段运动和44,970条描述,一段运动可以对应多条表述,描述也可能只覆盖其中一个时间区间。
首先,运动片段编码器独立学习压缩。输入运动的最后四维是足部接触,编码器读取其余259维,通过两层步长为2的一维卷积将时间轴压缩为原来的四分之一:
1 | motion features: [B,T,263] |
当 $T$ 为4的倍数时,片段数量为 $K=T/4$;$d_m$ 是各片段的潜变量维度。解码器用两层转置卷积恢复时间长度,并重建完整263维特征。训练目标由动作重建、潜变量稀疏项与相邻片段平滑项组成:
重建项约束逐帧失真,稀疏项限制编码幅度,平滑项约束潜变量的时间差分。最后一项定义的是 Latent Space 中的正则性,并不等价于关节加速度或接触力连续;解码器的非线性雅可比会改变 latent 之间的距离对应的几何变化。过大的平滑权重因此可能同时削弱高频姿态细节与真实接触切换。完成这一步后,片段编码器提供固定的潜变量目标,运动解码器则继续随时序生成网络微调,使预测片段能够重建为逐帧动作。
在文本端,word Embedding(词嵌入)与词性编码共同构成输入表示。Embedding 把离散词编号映射为可学习或预训练的向量,使时序网络能够比较词语之间的统计关系。每个词的 GloVe 向量为300维,词性向量经线性映射后与 word Embedding 相加,再送入双向 GRU。逐词输出 [B,L,2H_t] 为片段生成提供注意力键值,句子表示 [B,2H_t] 初始化时序生成状态。Text2Length 使用双向 GRU 和分类头,预测片段数量的类别分布,并用真实长度类别的交叉熵训练。
在生成端,即使长度已经确定,同一文字仍有多种合理动作。变分生成用随机潜变量 $v$ 表达这种变化:条件生成模型 $p_\theta(X\mid v,c)$ 提供重建,识别模型 $q_\phi(v\mid X,c)$ 在训练时读取真实动作。其基本目标是最大化条件变分下界
在上述变分目标下,时序模型进一步对片段位置 $\ell$ 建立条件先验和识别分布。先验 GRU 读取上一片段、文本注意力上下文及剩余长度,输出高斯参数 $(\mu_\ell^p,\sigma_\ell^p)$;识别 GRU 额外读取当前真实片段,输出 $(\mu_\ell^q,\sigma_\ell^q)$。训练从识别分布采样,运动解码 GRU 根据随机变量、前一片段和文本上下文预测下一片段。损失同时比较预测片段与真实片段、解码动作与真实动作,并累加各位置的 KL 散度。为简化公式,记 $q_\ell=q_\phi(v_\ell\mid z_{\leq\ell},c)$,$p_\ell=p_\theta(v_\ell\mid z_{<\ell},c)$:
$z_\ell$ 是运动片段编码,$v_\ell$ 是表达多解性的随机变量,二者承担不同功能。推理先采样长度,再仅从先验分布取得 $v_\ell$,逐段生成 $\hat z_\ell$,最后统一送入运动解码器。训练使用真实历史而推理使用生成历史,会形成 exposure bias(暴露偏差):训练时准确的前缀,在推理时被带有预测误差的前缀替代。将预测片段纳入训练输入,可减小两种历史分布的差异。
片段压缩决定局部运动的可恢复程度,条件生成决定文字如何选择片段分布。压缩中丢失的手部细节会延续到生成结果,片段预测偏差则可能在衔接处造成速度突变。帧级重建与片段级监督分别作用于这两个环节。
3. Motion-space Diffusion 与 clean motion 预测
逐段变分生成需要先提交早期片段,后续预测再以它们为条件;较早的错误因此可能影响接下来的运动。Motion-space Diffusion(动作空间扩散)采用另一种组织方式:把完整动作视为一个联合随机变量,每次去噪都同时更新全部物理帧,使前后时刻的姿态可以共同调整。记 clean motion 为 $X^{(0)}$,离散噪声级为 $k$,前向过程为
其中 $\bar\alpha_k=\prod_{i=1}^{k}(1-\beta_i)$,$\beta_i$ 为第 $i$ 级的加噪方差系数,$\bar\alpha_0=1$。$X^{(k)}\in\mathbb R^{T\times D}$ 始终保留完整物理时间轴;改变 $k$ 只改变噪声水平。反向网络读取 $X^{(k)}$、噪声级 $k$ 和文本条件 $c$。噪声越强,局部关节变化越难辨认;靠近低噪声端时,网络需要恢复接触、摆动节奏和细小姿态差异。
MDM 选择预测 clean motion $\hat X^{(0)}=f_\theta(X^{(k)},k,c)$,基本重建项可写为
与预测噪声相比,预测 clean motion 便于从网络输出恢复关节位置,并据此构造几何损失。例如,关节位置损失约束人体的空间构型,相邻帧差分损失约束运动变化,foot contact loss 则在接触时段惩罚足部滑动。相邻帧的位置差分表示逐帧位移;若用于计算每秒速度,还需乘以采样帧率。因此,损失函数的量纲与阈值应随坐标单位及采样频率明确约定。
几何监督的具体形式取决于动作表示。MDM 在 HumanAct12、UESTC 的 rotation 6D 配置中,将旋转参数恢复为关节位置,并以真实序列中足部的低位移时段构造接触掩码,在这些时段压低预测足部的位移。这里的掩码是一种运动学近似,静止的足部也可能尚未接触地面。对于 HumanML3D 复合特征,基本重建目标作用于标准化特征;若进一步引入关节空间监督,则需先恢复空间坐标,再定义相应的几何误差。联合足部高度与速度估计接触也是常见方法,其依据与前述仅采用低位移的掩码不同。
高斯噪声作用于表示所在的欧氏空间,不保持 $R_j^\top R_j=I$、$\det R_j=1$ 或固定骨长等约束。因此含噪状态是推断过程的辅助变量,无需在每个噪声级解释为有效人体姿态;最终解码才把预测变量映射到几何对象。若骨长或旋转约束没有由解码结构严格保证,有限权重的几何损失仍只能约束平均残差,不能把学习到的分布直接等同于物理可行集合。
前向加噪数值算例以正弦信号构造单坐标轨迹,将高维运动的仿射加噪关系约化为一维。已知噪声时,逆运算是仿射可逆的;学习问题的困难在于推理时未知原始信号与所加噪声,必须从条件分布估计二者。
1 | import numpy as np |
运行结果:
1 | alpha_bar=0.95, oracle_max_error=2.22e-16 |
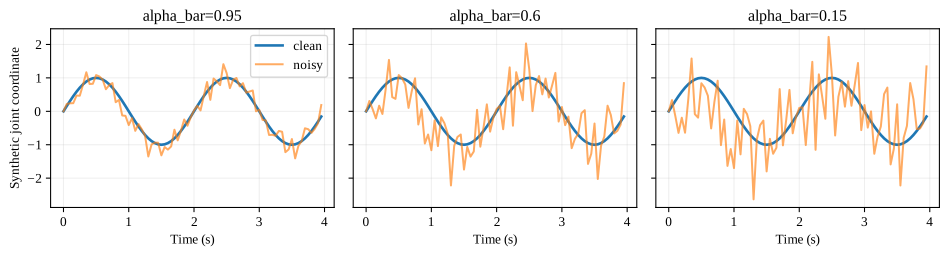
算例中的机器精度误差验证了已知噪声下的代数可逆性,并不对应学习模型的恢复误差。若噪声估计存在偏差 $\delta\epsilon$,由同一公式得到 $\delta X^{(0)}=-\sqrt{(1-\bar\alpha_k)/\bar\alpha_k}\,\delta\epsilon$;高噪声状态对噪声估计误差更敏感,噪声日程与损失权重因而共同影响训练条件数。
反向生成以高斯噪声为起点,网络在每个扩散步估计 clean motion,再由该估计计算下一状态。直到到达低噪声端,才对输出反标准化并恢复关节。训练每次只需随机抽取一个噪声级,推理则沿反向日程依次调用网络;前向公式中的已知噪声在生成阶段由学习到的估计取代。
4. 条件注入、Classifier-free Guidance 与张量实现
去噪目标通过条件网络实现。文本、扩散步与运动帧分别编码后,需要在兼容的隐藏维度中融合。MDM 的核心输入接口是 [B,J,F,T]。其中 $J$ 和 $F$ 的具体含义取决于动作表示:对复合向量配置,它们不一定对应真实关节数与每关节特征数。输入处理将二者合并,转换为 [T,B,J×F],再线性投影到 Transformer 隐藏维度。
在 HumanML3D 配置中,输入是 [B,263,1,T]。展平与转置后得到 [T,B,263],线性层逐帧投影为 [T,B,H]。冻结 CLIP 产生 [B,512] 的句子向量,经投影映射到 $H$ 维;扩散步通过正弦编码与多层感知机得到 [1,B,H] 的 Embedding。二者相加构成一个条件 token,放在运动序列前:
1 | noisy motion → linear: [T,B,H] |
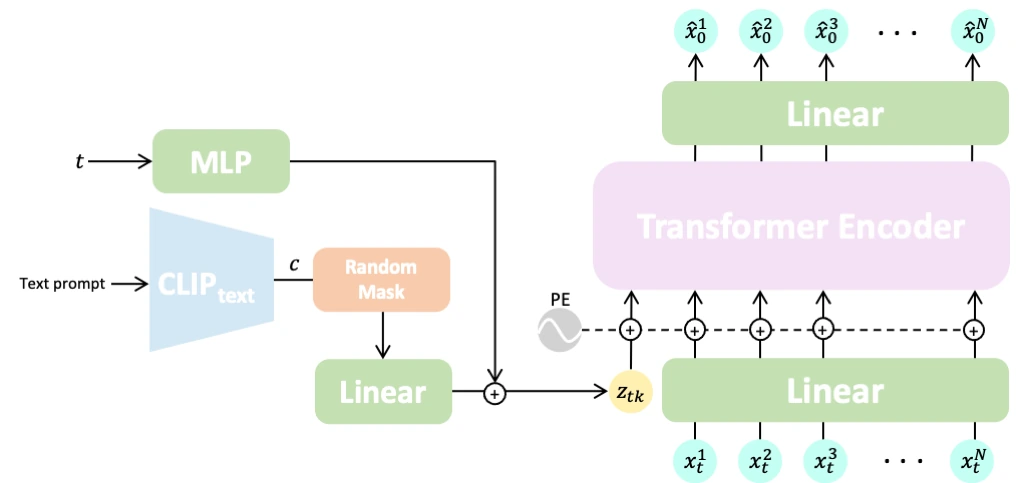
图中 Random Mask 对文本条件执行随机丢弃,为有条件与无条件去噪提供共同训练基础;右侧线性输出层将隐藏特征映射回运动表示。图中的扩散步记为 $t$,对应本章的 $k$;图中用于区分动画帧的上标对应本章的物理帧索引 $t$。
动画帧位置编码区分动作发生在序列的哪一帧,扩散步 Embedding 说明当前噪声水平。编码器自注意力让各帧相互读取,因此可以共同决定转身前后的姿态;该编码器采用双向时序注意力。训练随机抽取噪声级 $k$ 并加噪,输出通过有效帧掩码接受 $X^{(0)}$ 重建监督,文本编码器保持固定。
为了在采样时调节文字影响,训练随机丢弃文本条件,使同一个网络也学会无条件预测。Classifier-free Guidance再利用有条件与无条件预测之差进行调整:
上标 $g,u,c$ 分别表示 guided、unconditional 与 conditional 预测。$w=1$ 等于有条件预测,$w=0$等于无条件预测;$w>1$沿二者差向量外推。外推通常加强文本约束,同时可能减少多样性或放大异常姿态。引导系数调节的是有条件与无条件预测的相对贡献;步幅和速度属于生成轨迹的属性,无法由该系数单独指定。
条件置空在文本向量投影前完成;采样时,同一噪声状态分别通过条件与无条件分支,合成引导预测后再执行反向转移。文字没有随噪声日程变化,因此其编码可以在循环外计算。
时间全连接注意力使第 $t$ 帧的估计依赖整个含噪序列,因而能够联合调整转身之前与之后的姿态。该结构不沿物理帧轴逐帧提交结果,避免了因固定错误前缀而产生的一类单向传播;其误差仍会沿反向去噪链传递,双向注意力本身也不构成骨长、接触或长期稳定性的硬约束。
张量计算算例刻画帧投影、条件 token 和 padding mask 的不同作用。注意力掩码限制信息流,损失掩码定义监督所在的有效子空间:改变后者排除的输出不会改变损失,但不能据此推断模型从未读取 padding 输入。
1 | import torch |
运行结果:
1 | input: (2, 12, 1, 8) prediction: (8, 2, 12) |
5. Latent Diffusion 与运动重建
5.1 运动压缩与 Latent Space 采样
Motion-space Diffusion 在每个去噪步骤都处理完整运动特征,序列越长,重复处理的时序数据越多。Latent Diffusion(潜空间扩散)先用运动压缩器保存主要信息,再在较紧凑的 latent 表示上学习文本条件分布。MLD 先训练运动 VAE,将整段动作压缩为连续潜变量 $z$,再训练条件扩散模型生成 $z$。推理计算链为
编码阶段,运动编码器将 [B,T,D] 投影为时序隐藏特征,加入用于聚合的可学习查询 token,并屏蔽 padding 帧,输出潜分布的均值与方差。重参数化 $z=\mu+\sigma\odot\epsilon$ 得到连续潜变量。下文采用 batch-first 记法 [B,K_z,d_z];官方运动编码器返回的顺序是 [K_z,B,d_z],进入去噪器前再交换轴。$K_z$ 是 latent token 数量,不必等于帧数。解码阶段,解码器读取这些潜变量,以所需长度的帧查询恢复 [B,T,D],并在有效帧上计算重建损失。
VAE 固定后,文本编码与扩散步共同进入 Latent Space 去噪器。训练对真实动作编码得到的 $z$ 加噪,学习噪声预测;推理从同形状高斯噪声出发,逐步生成 $\hat z$,最终只调用一次运动解码器。动作长度由解码查询与掩码决定,而潜变量索引与动画帧索引具有不同含义。
两个训练阶段对应不同的学习目标。首先,运动 VAE 以真实动作作为输入,平衡重建精度与 latent 分布正则;随后固定 VAE,对编码得到的 latent 加噪,并用文本条件训练去噪器。若 $q_\phi(z\mid X)$ 是编码分布、$\mathcal D_\psi$ 是运动解码器,两个目标可分别写为
第一项要求 latent 可恢复已有运动,第二阶段才学习同一文字下多个 latent 的概率分布。过强的压缩会丢失短促接触、手部细节或高频变化;过弱的 Latent Space 约束又可能使生成分布难以覆盖真实编码。Latent Space 容量因而需要在压缩效率与重建保真度之间平衡。
表示误差与生成误差可以通过解码器分离。设真实编码为 $z^\star=\mathcal E(X)$,生成潜变量为 $\hat z$,且解码器在相应邻域中具有 Lipschitz 常数 $L_{\mathcal D}$,则
该不等式区分了两种来源:第一项是已有编码器和解码器造成的重建失真,第二项是生成 latent 偏离真实编码后,经解码器放大的误差。增加去噪步骤可以改善采样的数值近似,却不能直接补回运动压缩时已丢失的细节;在解码器对输入较敏感的区域,小幅 latent 偏差也可能产生明显的关节位移。
整段压缩通常读取未来帧,因此它与在线因果解码不是同一接口。整段解码后的逐帧播放仍依赖完整生成结果,无法在解码过程中依据新指令更新尚未生成的后续运动。
5.2 Latent Consistency 与 few-step sampling
运动压缩减少了每次去噪需要处理的数据,但反复调用去噪器仍会增加响应时间。Latent Consistency(潜变量一致性)进一步学习从不同噪声状态直接恢复同一轨迹端点的映射。这里的 few-step sampling 指仅执行少数去噪步骤,与需要少量示例的 few-shot learning 无关。
MotionLCM 从预训练 diffusion teacher 出发,将教师沿概率流 ODE 的较长计算过程蒸馏到 student。以 $s$ 表示噪声轨迹的连续参数,理想一致性映射满足
两个状态必须属于同一教师轨迹;$s_1,s_2$ 不对应不同的运动帧。具体训练时,先对真实运动的 latent 加噪,再由冻结的教师和 DDIM solver 计算邻近的较低噪声状态。student 处理起点,EMA target network 处理邻近状态,两端预测通过一致性损失联系起来:
其中 $d$ 可使用平方误差或 smooth distance,$\operatorname{sg}$ 表示停止梯度,$\gamma$ 是 EMA 系数。网络输出还通过 skip/output 系数组合含噪输入与 clean latent 估计,在零噪声端满足恒等条件,防止一致性学习退化为与输入无关的常量映射。完成蒸馏后,student 用一步或少量调用近似教师的端点映射,再由固定运动解码器恢复帧序列。最终质量同时取决于教师分布、相邻轨迹状态的数值近似和 student 的拟合能力。
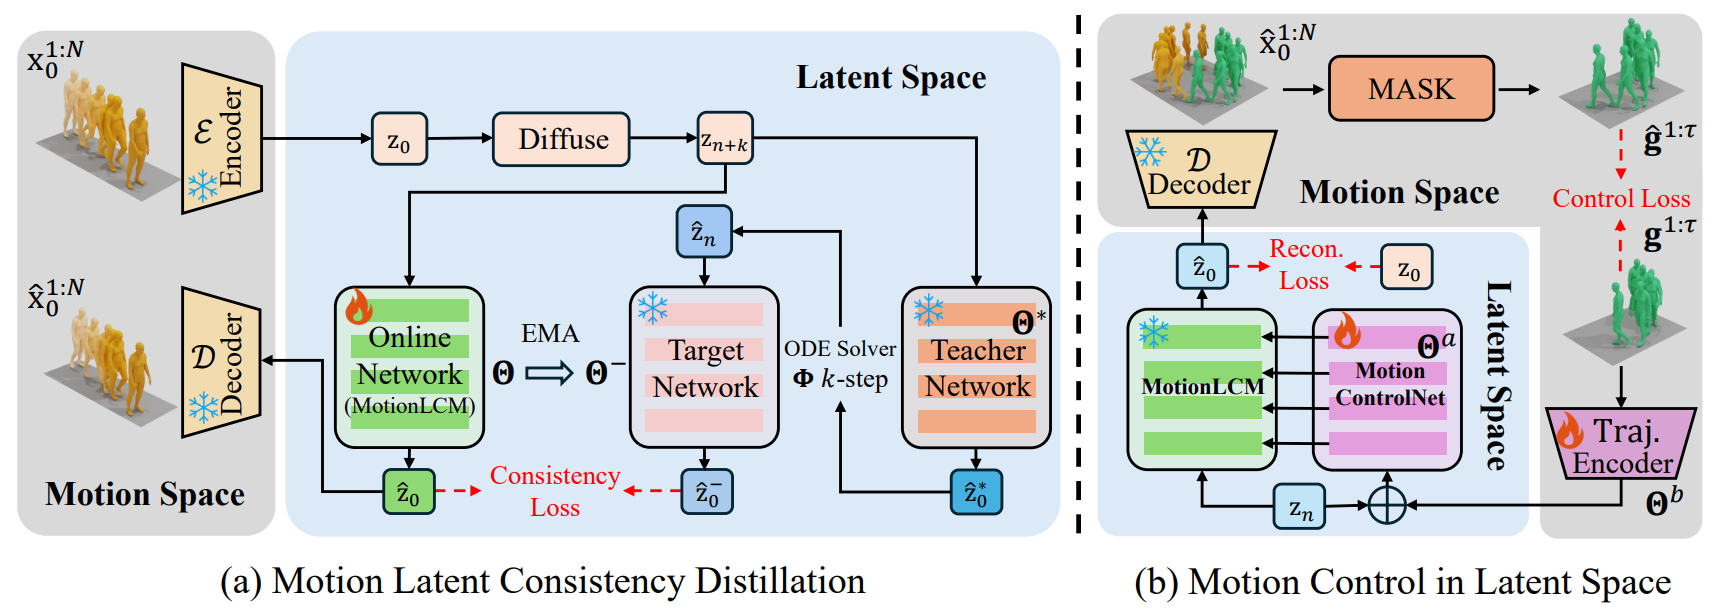
图中左侧通过同一去噪轨迹上的预测一致性减少采样迭代;右侧则引入 Motion ControlNet 与轨迹编码器,将指定关节的空间条件送入潜变量生成,并在解码后的关节上计算控制损失。这两种改进针对不同问题:减少步骤提高响应速度,增加轨迹条件规定位置。“转弯”限定运动语义,转弯位置与半径则由几何条件确定;两类条件在模型中承担互补作用。
6. 离散 motion token 与 autoregressive 生成
Latent Diffusion 在实值向量空间中采样运动。另一种选择是将这些向量量化为有限 Codebook(码本)中的编号,使连续运动转为可由分类头预测的离散序列。autoregressive(自回归)模型随后按照时间顺序,用已有编号预测下一编号。motion token是编码器输出经量化后得到的基本单元。T2M-GPT 将 VQ-VAE 与条件 autoregressive 模型连接:编码器把 $T$ 帧动作下采样为 $K$ 个潜向量,每个潜向量映射到 Codebook 最近邻,得到整数序列 $q_{0:K-1}$;解码器再用码向量恢复运动。token 的时间单位是压缩片段,不是单个关节,也未必是一帧。
在这套离散表示上,生成器建模
式中 $q_K=q_{\mathrm{end}}$,有效运动 token 的索引范围仍为 $0\leq\ell<K$。文本特征构成条件输入;运动 token 经 Embedding lookup 并加入位置编码后进入因果 Transformer。训练使用真实前缀并并行计算各位置的交叉熵,推理则逐个采样 token,直到结束标记或长度上限。目标序列右移与 causal mask 共同隔离当前预测位置及其未来目标,保证训练所用条件与 autoregressive 分解一致。
量化训练还涉及 Codebook 的利用率。EMA 更新、失活码重置等机制帮助码向量覆盖编码分布;仅增加 Codebook 大小可能导致很多编号从未使用。生成器输入中加入一定比例的扰动 token,可以缓解真实前缀与生成前缀的差异,但不能完全消除长动作中的误差累积。
要训练这套离散表示,还需处理量化算子的梯度。设编码向量为 $z_\ell$,Codebook 为 $\{e_v\}_{v=1}^V$,编号为 $q_\ell=\arg\min_v\|z_\ell-e_v\|_2^2$。最近邻选择在量化分区内部保持不变,在分区边界发生离散跳变,因而无法直接为编码器提供有效梯度。straight-through estimator 在前向使用 $e_{q_\ell}$,反向以近似恒等映射将重建梯度传给编码器。常见 commitment loss $\|z_\ell-\operatorname{sg}(e_{q_\ell})\|^2$限制编码结果偏离选中码过远,Codebook 项或 EMA 负责移动码向量。stop-gradient 分别控制编码器与码向量的更新路径,使重建梯度和量化约束作用于对应参数。
token 长度与帧长度同样不能混用。若编码器时间下采样倍数为 $u$,$K$个有效 token 大致对应 $uK$帧;边界补齐和卷积规则会影响精确对应。结束符是分类目标的一部分,padding 只是批处理占位;损失应包含有效结束符并排除 padding。过早生成结束符会截断动作,生成上限被触发则可能留下未完成的语义。
autoregressive 训练优化真实历史下的条件风险,推理却在模型生成的历史分布下继续采样,这一分布偏移构成 exposure bias。为了刻画传播机制,可在连续隐藏状态中考虑同一随机输入耦合下的局部扰动。记对应两条隐藏状态轨迹的距离为 $e_\ell$。若状态更新对历史扰动的放大系数不超过 $L$,单步近似误差不超过 $\varepsilon$,则
$L<1$ 时该上界有界,$L=1$ 时误差可线性累积,$L>1$ 时上界允许几何放大。这里的界适用于满足局部稳定性假设的隐藏状态映射,不能直接跨越离散 argmax 或量化分区边界。实际采样还可能切换到另一条合理轨迹,因此相对单条真值的偏差并不全部属于生成错误。
整段扩散通过联合更新所有帧,绕开了上述逐 token 固定前缀的传播方式,但将误差传播转移到噪声轴;它仍可能产生根漂移、足部滑动及长时段语义失配。离散化失真、条件建模偏差与序列传播应分别评价,不能把扩散的联合更新解释为全局一致性的保证。
7. Residual Vector Quantization 与 Masked Modeling
Residual Vector Quantization(残差向量量化,RVQ)用多个 Codebook 逐级近似同一 latent;Masked Modeling(掩码建模)根据已知位置恢复被遮盖的 motion token。这两种设计分别用于减小运动压缩的量化失真和改善离散序列的生成过程。单层 Codebook 用有限向量近似连续 Latent Space,沿时间推进的 autoregressive 模型则在固定前缀下预测后续位置,无法在同一次采样中依据后续结果修订早期 token。MoMask 分别采用残差量化与双向掩码恢复处理这两个问题。令编码结果为 $z$,第一层选取 $e^{(1)}$;第二层量化残差 $r^{(1)}=z-e^{(1)}$,再得到 $e^{(2)}$。令初始残差 $r^{(0)}=z$,一般地,
残差量化包含两个独立索引:$\ell$ 表示动作时间片段,$h$ 表示同一个片段的残差量化层。量化层索引描述同一时间位置的逐级近似。底层 token 提供较粗表示,更高层纠正 latent 向量中的剩余误差;各层分解的是潜向量误差,不预设身体部位分工。
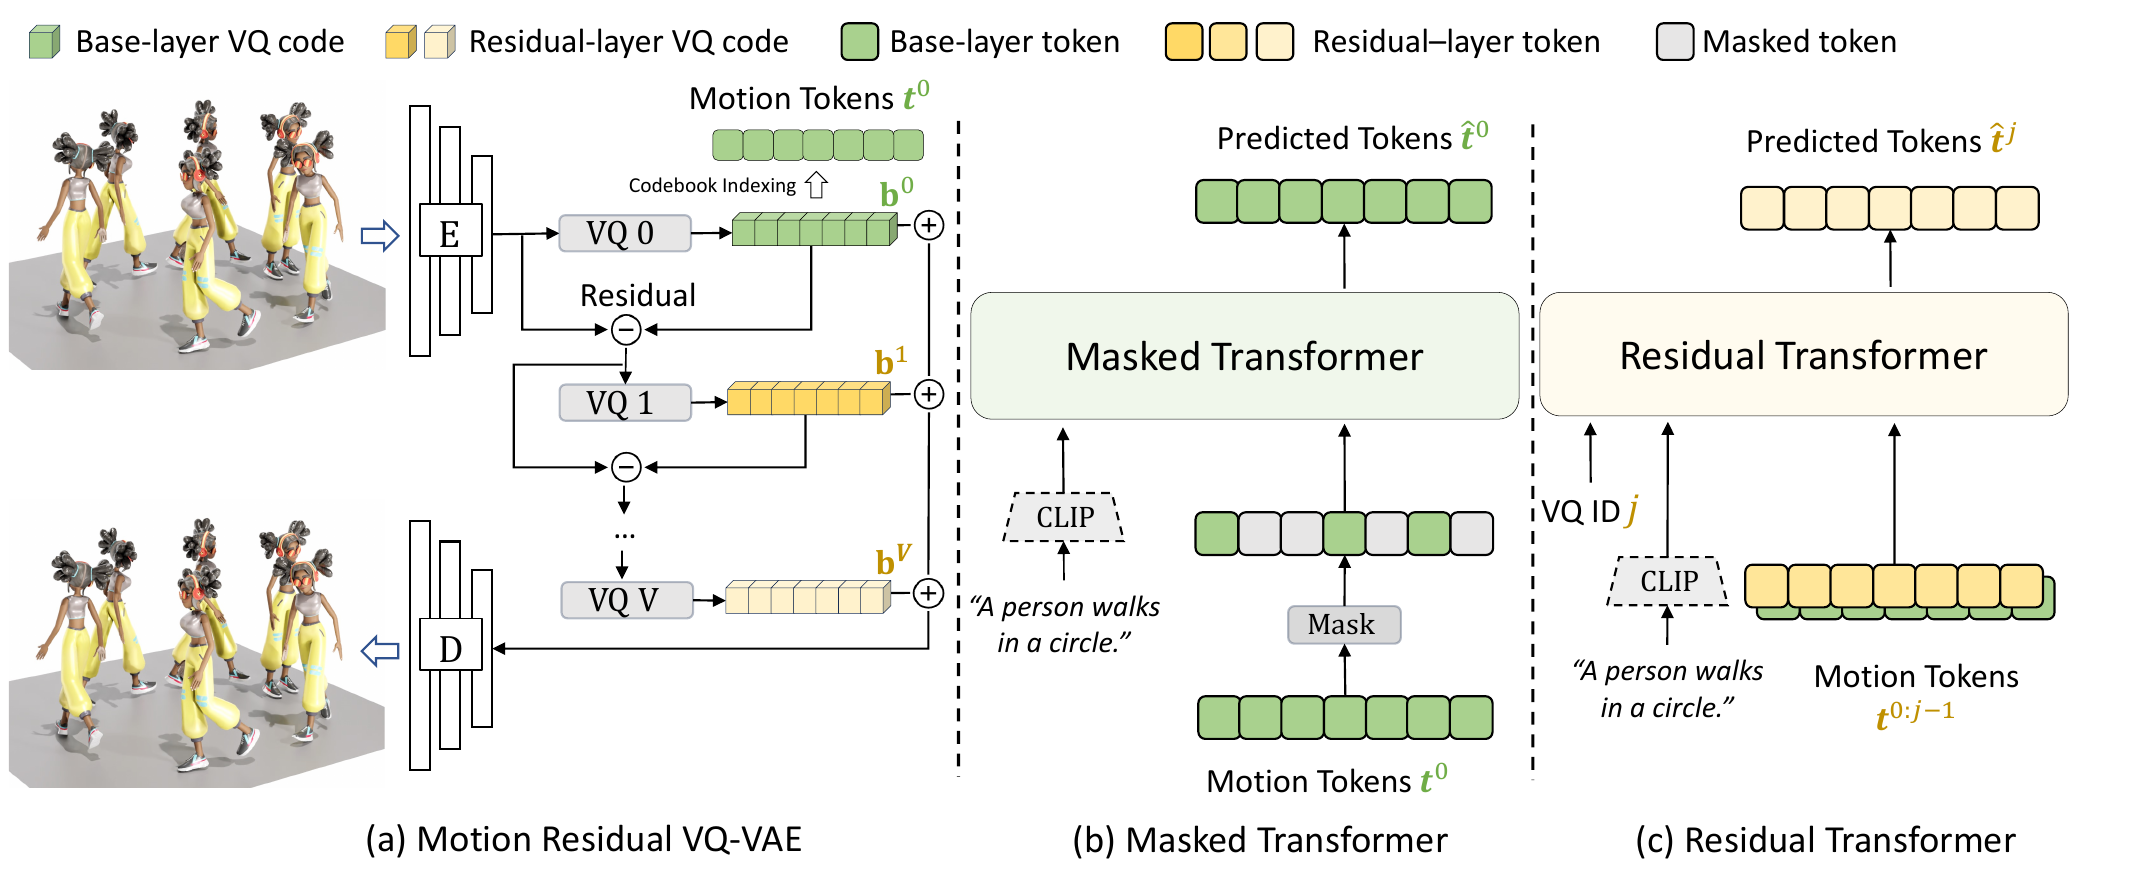
图中左侧先建立可解码的残差 token 表示。编码器把 [B,T,263] 转为 [B,K,d_z],各量化层沿相同时间轴选择码向量,整数编号组成 [B,K,L]。训练通过重建损失与量化约束学习编码器、Codebook 和解码器,并随机减少启用的量化层,使较少的量化层也能提供稳定重建。训练生成器时固定这套运动编码。
底层生成采用双向掩码模型。训练时随机选择有效位置集合 $\mathcal M$并遮盖,模型根据文本和未遮盖 token 恢复目标:
基础层的整数序列 [B,K] 经 code Embedding 和线性投影变为 [K,B,H],CLIP 文本向量投影后作为前置条件 token,形成 [K+1,B,H]。双向 Transformer 对有效位置计算注意力,输出头给出 [B,V,K] 的词表 logits。训练随机抽取掩码比例,只在被遮盖的有效位置计算交叉熵;padding token 参与批处理,却不作为待恢复目标。
图中右侧的残差 Transformer 处理另一条轴。训练随机抽取量化层 $h>1$,把此前各层的码向量相加,得到 [B,K,d_z],再提供量化层编号与文本条件,预测第 $h$ 层的 [B,K] 编号。量化层 Embedding 标识当前预测的残差阶次,避免累计特征与层级目标之间的歧义。这里依次生成的是量化层,时间轴上的位置仍可双向交流。
推理按基础层生成与残差细化依次进行。先确定 $K$,将所有有效基础层位置置为掩码;每轮并行预测编号,并按置信度重新遮盖低置信位置,掩码数量随迭代减少。得到基础层后,依次生成高层残差编号,将码向量求和并交给运动解码器。因此,MoMask 先沿掩码迭代轴建立基础层序列,再沿量化层轴补充细节,最后恢复连续帧;这与沿物理时间逐个提交 token 的 autoregressive 生成不同。
掩码恢复的置信度来自当前采样编号的 softmax 概率。每轮先筛选低概率类别,再从保留的分布中采样候选编号;较高置信的位置被保留,为后续迭代提供双向上下文,尚未确认的低置信位置继续接受恢复。掩码数量按日程减少,使条件信息逐步丰富。这里的“置信”是模型对编号的概率判断,并非对足部接触或动作语义的独立验证;错误但高概率的编号也可能被提前保留。
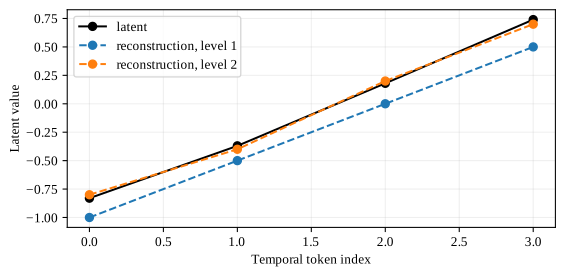
固定 Codebook 的残差量化算例把高维量化几何约化到一维。每层选择一个码向量,累计重建位于多个有限集合的 Minkowski 和中;增加残差层允许在更多码向量的和集中选择重建;若额外 Codebook 包含零,可表示集合不会缩小,但不含零时没有这一包含关系。算例的 Codebook 包含零,因此最近邻选择至少可以保持上一层误差不增。
1 | import numpy as np |
运行结果:
1 | level=1, ids=[0, 1, 2, 3], rmse=0.1843 |
掩码恢复可以保留已知前后 token,填补中间缺失区间。卷积解码器的感受野却跨越 token 边界:一个编辑 token 会影响邻近若干帧,即使这些帧对应的其他 token 没有变化。因此,token 级保持与帧级保持具有不同的空间范围。
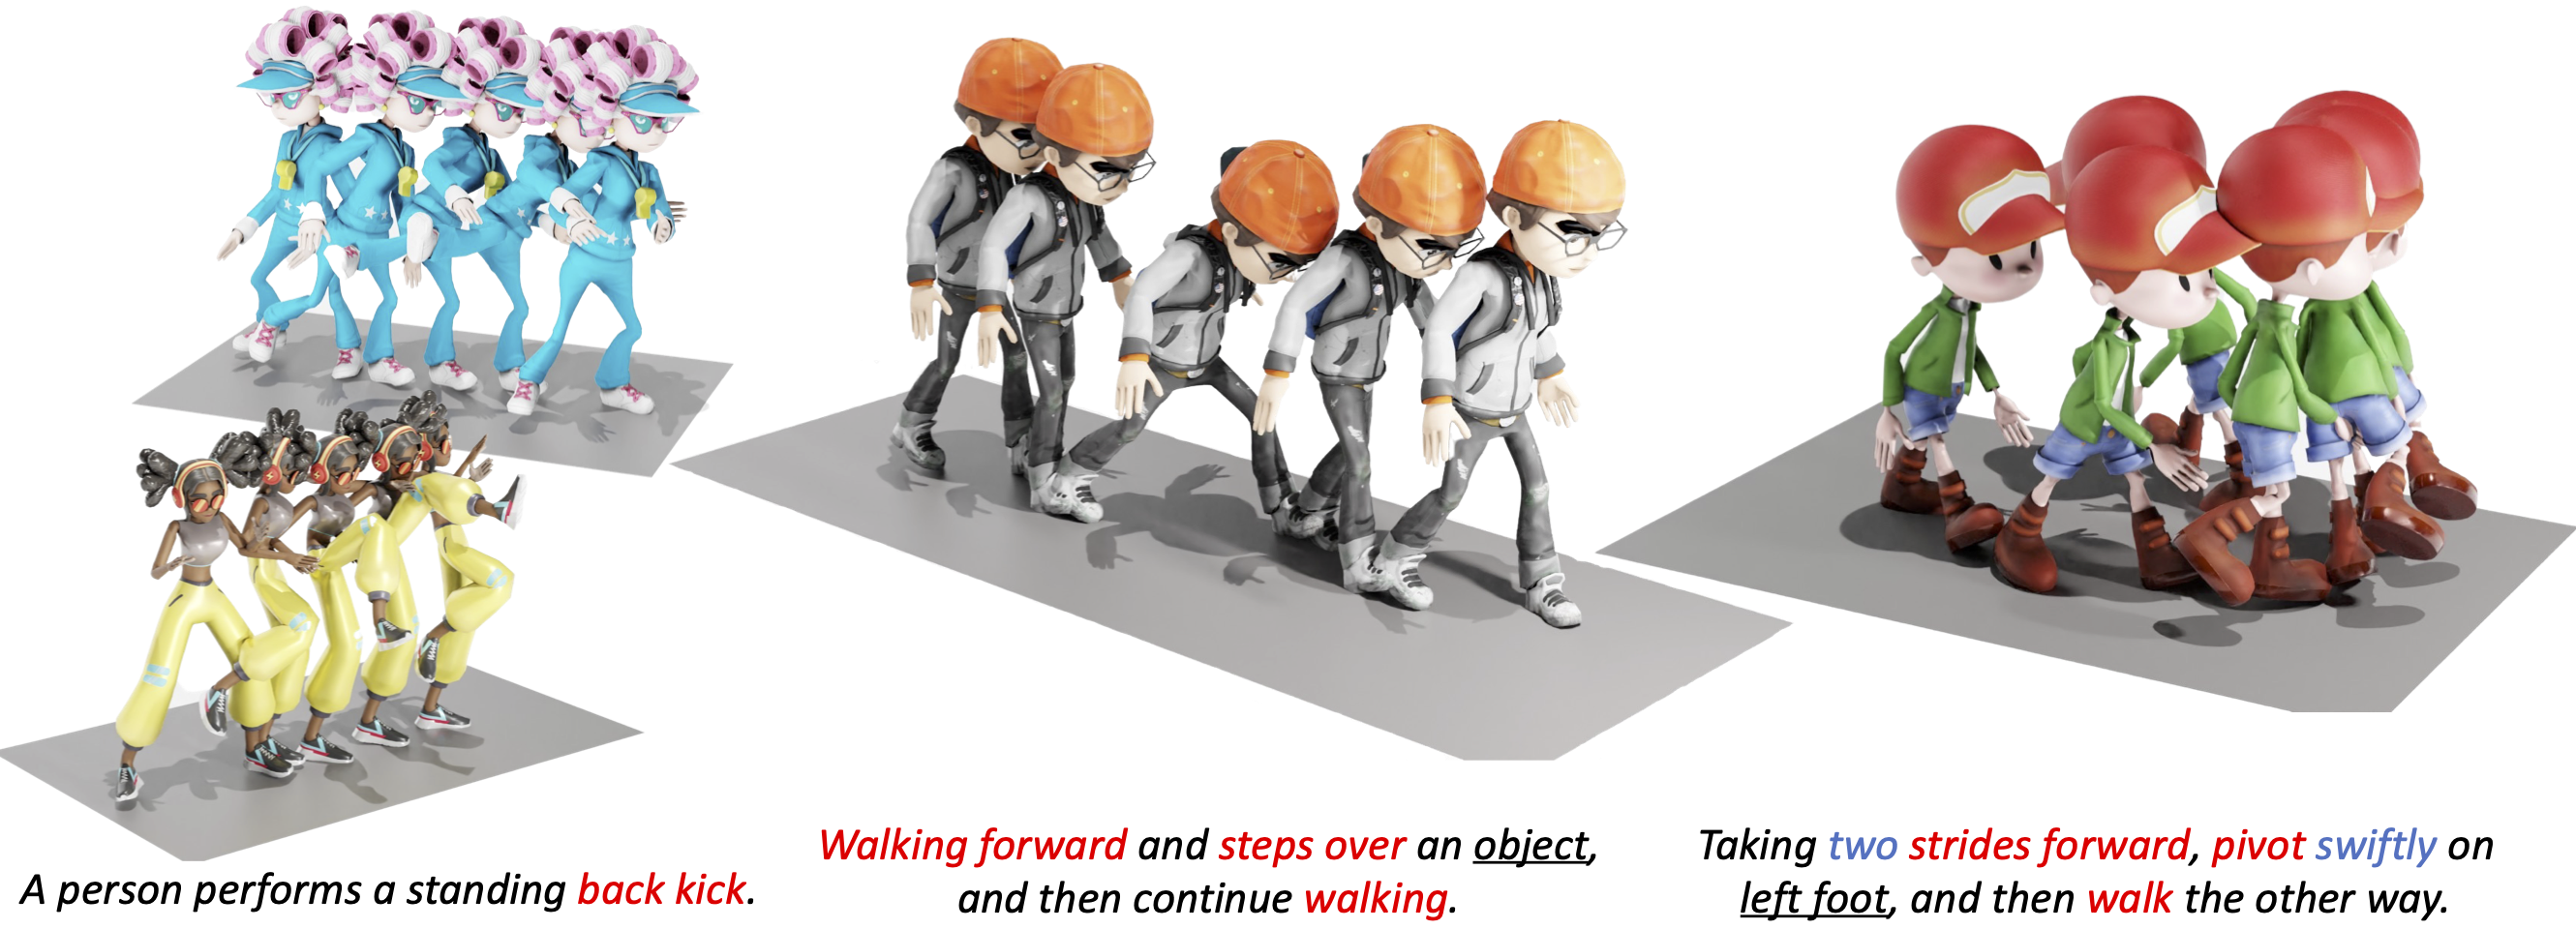
动作 token 经解码与角色重定向后产生可见运动。图中的跨越障碍和迈步转向同时包含根轨迹变化、支撑切换及关节协调,展示了离散序列最终必须满足的连续运动结构。
长度决定有效 token 数。在相应 HumanML3D 配置中,一个 token 对应四帧,帧长度先转换为 token 长度,解码后再恢复四倍时间轴。解码特征经反标准化和根相对关节恢复得到 [B,T,22,3],随后可以驱动骨架或角色。足部 IK 属于解码后的运动修正,主要改善脚部接触;它与基础 token、残差 token 的预测误差应分别分析。
8. MotionMillion 的数据扩展与组合泛化
上述生成器都从配对数据中学习文字与运动的关系,能够覆盖的行为也受数据限制。扩展数据时,可以统一已有动作库,也可以从网页视频估计三维人体运动。MotionMillion 包含超过200万条序列和2,000小时数据,扩大了语义和动作覆盖。视频估计的运动属于伪真值,遮挡、镜头运动与姿态重建偏差使其误差分布区别于高精度动捕。
视频处理链需要处理镜头切换、人体检测、静止或抖动片段筛选、SMPL 运动估计及后续过滤。文本标注由视觉语言模型生成描述并经过质量筛选。各处理阶段具有不同的误差来源。例如,遮挡可能导致手臂估计偏离,摄像机运动可能影响根轨迹,文本描述则可能遗漏动作阶段。这些偏差随动作进入训练集,可能在生成中表现为同类关节偏移或根路径失真;系统性重建误差会随数据扩展进入生成模型的学习目标。
大规模数据还要求编码稳定。MotionMillion 使用根空间中的线速度、以6D旋转编码表示的相邻帧朝向增量,以及局部位置、速度与旋转。该6D增量属于旋转的嵌入表示,并非李代数中具有弧度每秒单位的三维角速度;位置与旋转则来自同一骨架。运动先经过小波变换,再输入编码器;解码器输出经过逆小波变换恢复连续序列。小波将不同变化频率分开组织,有助于编码器保存快速变化,减轻离散压缩后的抖动。
量化采用有限标量量化 FSQ。设低维编码 $z\in\mathbb{R}^{d_q}$,第 $i$ 维有整数 $L_i>1$ 个取值。以 $f:\mathbb{R}\to[0,1]$ 表示有界映射,例如 sigmoid,下式采用从0开始的整数编号形式:
各维编号可以按混合进制合成一个整数 token。FSQ 的词表由固定网格构成,不需要搜索可学习的最近邻 Codebook;编码器仍需通过重建目标学习运动特征到量化网格的映射。固定网格避免了码向量更新中的失活问题,但并不保证训练数据均匀占据所有网格单元;实际编码熵与名义容量 $\log_2 V$ 仍可能相差很大。量化前后的连续映射与运动解码器由重建损失联合训练,得到 [B,K] 的整数运动序列。
生成器将 T5-XL 的逐词特征与 motion token Embedding 投影到同一隐藏维度。若文本有 $L_c$ 个位置、运动有 $K$ 个位置,输入为 [B,L_c+K,H]。混合注意力让文字位置之间双向读取,而运动位置读取全文与已有运动前缀;文本位置不读取运动后缀,防止间接泄漏未来目标。每个 Hybrid Attention Block 包含 RMSNorm、混合注意力和前馈网络,分类头输出运动词表 logits,以运动目标的交叉熵训练。
训练先建立运动编码,再用固定编码产生运动 token 训练生成器。推理编码全文,逐个采样运动 token,随后经过 FSQ 逆映射、运动解码与逆小波变换恢复帧序列。扩大到3B、7B 等参数规模增加了建模容量,其组合泛化能力还受训练数据覆盖与评价分布影响。固定划分内的泛化和域外文本条件下的零样本生成分别对应不同问题。即使样本总量增加,条件空间中的长尾组合仍可能稀疏:若某种组合在采样分布中概率为 $p_c$,$n$ 次独立采样全部遗漏它的概率为 $(1-p_c)^n$。模型规模无法单独改变这一覆盖事实;视频估计引入的系统偏差也不会仅因样本增多而消失。
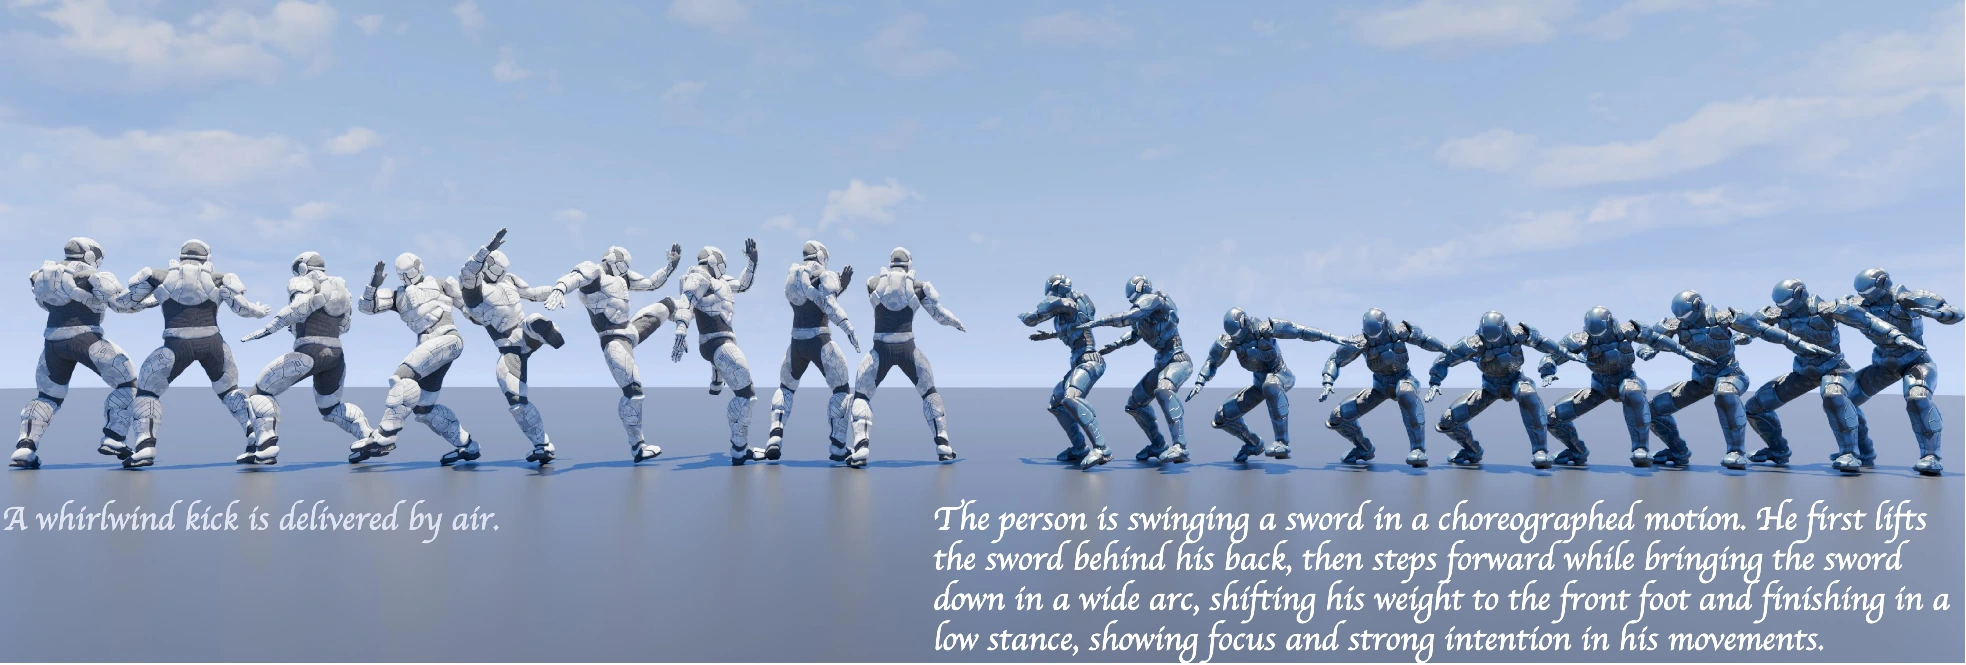
左侧动作包含旋转、腾空和踢腿,右侧按抬臂、迈步挥砍与低位收势组织连续姿态。这类描述将多个局部条件组合为完整动作,因此对生成器的要求超出了单一动作类别识别。
组合泛化包含多个相互独立的动作属性。例如“左脚迈出两步,右手一直保持肩高,最后逆时针转身”包含左右、次数、持续约束和顺序。整体语义相似度对各属性的敏感程度不同,因而需要分别评价部位、数量、持续时间和顺序。MotionMillion-Eval 将域外描述与复杂组合条件纳入评价,用于考察常规短动作配对之外的语义覆盖。
9. Causal Latent Space 与 streaming generation
整段生成适合提前给定文字的短片段,但交互应用可能在运动过程中收到新指令。streaming generation(流式生成)因此要求模型依据已有历史持续输出,并让新条件影响后续运动。MotionStreamer 接收持续到来的多轮文本,逐步生成可以在线解码的动作潜变量:因果时间自编码器保证当前潜变量对应的帧不依赖未来潜变量;autoregressive 网络读取历史潜变量和当前文本,生成条件特征;扩散头据此采样下一个连续潜变量。
其分布分解可概括为
其中 $\mathcal C_\ell$ 表示生成第 $\ell$ 个潜变量时已经到达的文本条件集合,文本指令与潜变量不要求一一对应。潜变量、动作帧和文本输入有各自的时间粒度。局部扩散头的迭代索引描述噪声演化,与上述物理时间粒度相互独立。
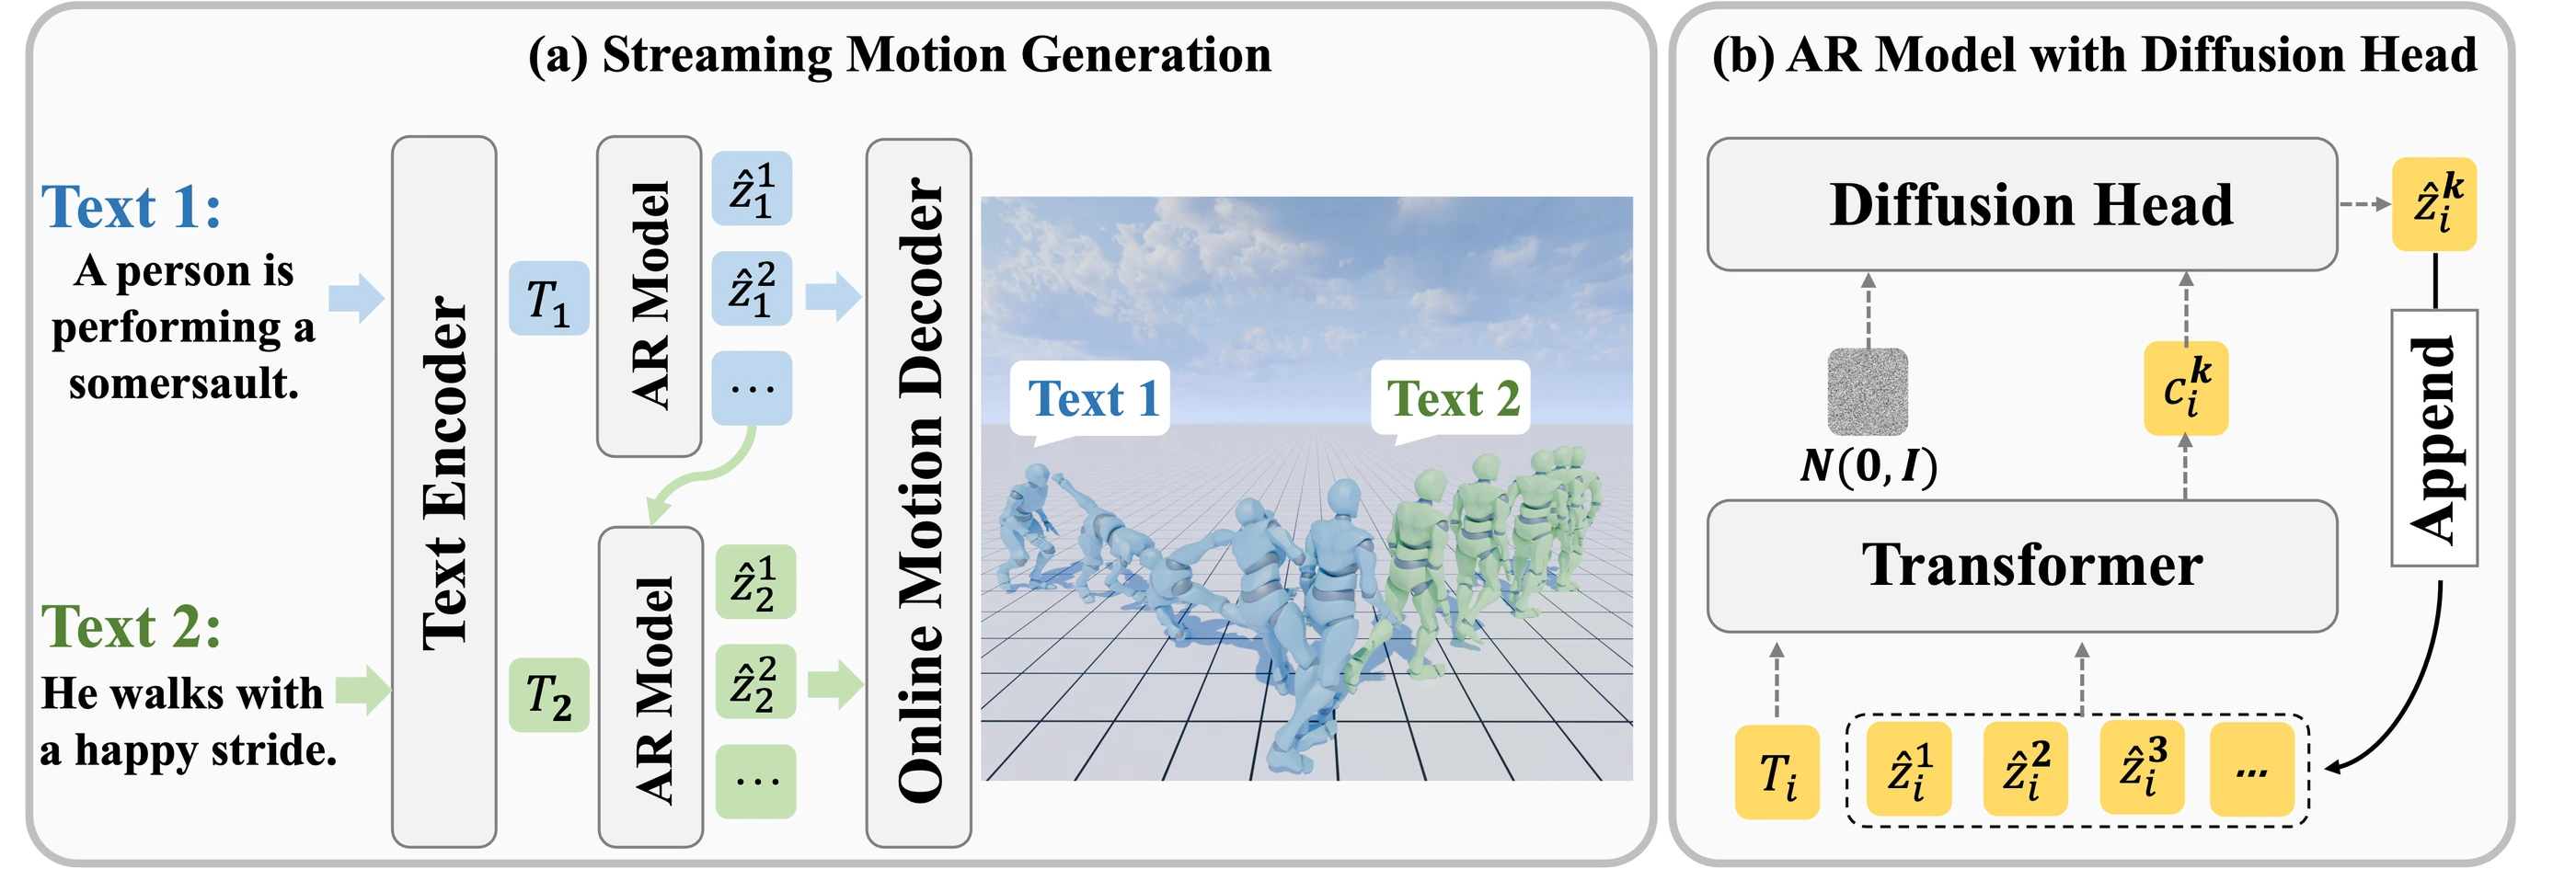
左侧按指令组织潜变量和在线解码,右侧展开一个潜变量的生成过程。Append 将新采样的潜变量加入历史,下一次 Transformer 调用据此更新上下文;局部去噪仅决定当前潜变量,完整运动时间轴由外层 autoregressive 过程推进。
因果压缩要求编码器与解码器都不读取未来。MotionStreamer 将运动重采样到60 fps,使用272维根空间表示,以因果一维卷积将 [B,T,272] 压缩为 [B,T/4,16] 的连续潜变量序列。卷积在时间轴左侧 padding;潜变量的均值与方差由编码器预测,重参数化后接受重建、KL 与根关节重建监督。对根运动额外加权,可以减轻误差累计对后续全身位置的影响。
生成阶段将当前 T5-XXL 文本 Embedding、历史运动潜变量和当前运动前缀投影到共同隐藏空间。因果 Transformer 每个位置只读取已有前缀,输出下一潜变量的条件特征 $h_\ell$。小型 MLP 扩散头再读取 $h_\ell$、加噪潜变量和扩散步,预测噪声:
扩散头将16维加噪潜变量线性投影到内部宽度,扩散步经正余弦 Embedding 和 MLP,条件特征 $h_\ell$ 经另一线性映射;后两项相加形成调制向量。每个残差 MLP 块由它产生归一化的位移、缩放和残差门,输出层再投影回16维噪声预测。训练可并行处理多个时间位置,采样时则只为下一个潜变量执行这条小型去噪链。
因此,Transformer 负责长程上下文,扩散头负责当前连续潜变量的多解分布。若直接用均方差回归下一个潜变量,多峰条件分布的均值可能落在低概率区域,产生幅度减弱或姿态模糊的输出;条件扩散保留了在同一历史下采样不同后续运动的能力。生成一个潜变量后,因果解码器即可产生对应帧,无需等待整段完成。
该架构包含两个嵌套生成过程:外层 $\ell$ 推进运动片段,内层 $k$ 在固定 $\ell$ 上采样该片段的连续潜变量;解码出的物理帧再由 $t$ 索引。局部 diffusion head 并不使整个系统成为整段扩散,因果前缀的误差传播仍由外层 autoregressive 结构决定。
连续潜变量避免了离散 Codebook 量化,但压缩与前缀误差仍存在。为适应生成前缀,Two-Forward 训练首先用真实前缀计算预测,再按逐渐变化的比例用预测潜变量替换部分真实输入,第二次前向在混合前缀上接受监督。此外,Mixed 训练同时使用 HumanML3D 的独立文字动作对与 BABEL 的相邻动作区间:前者没有历史运动,后者带有前一段上下文,网络由此学习新条件与已有姿态之间的衔接。
连续序列也需要停止依据。模型把全零的“不可能姿态”送入因果编码器,建立参考结束潜变量,并将它作为训练序列的末端目标。推理时,当前潜变量与参考结束潜变量的距离小于阈值,当前指令便结束;下一指令替换文本条件,将刚生成的动作作为历史继续采样。停止条件由连续 Latent Space 中的距离判定实现。
流式能力同时受生成、解码与缓冲策略影响。首帧延迟衡量开始输出需要多久,指令切换延迟衡量新条件何时影响运动。已经输出的帧无法由新指令改写,预先缓存的运动又可能推迟响应;缓存长度因而需要在稳定播放与及时控制之间取舍。指令衔接处的根速度和关节加速度刻画转场连续性;因果性规定读取范围,连续性还取决于历史条件与训练目标。
10. 生成结果与误差定位
10.1 关节序列与人体表面
MotionLCM 的生成过程将文本条件映射为运动潜变量,再由解码器恢复逐帧特征。例如,批量中包含两条文本、每条生成100帧时,文本特征、初始噪声、生成潜变量和恢复关节依次具有以下形状:
1 | text_embedding: (2, 1, 768) |
263维特征经反标准化与根运动恢复得到关节坐标,再通过人体表面拟合呈现姿态、朝向与肢体轮廓。MotionLCM 的官方展示中,环形行走与双臂挥动对应两类不同的文本条件:前者同时涉及整体转向和周期步态,后者主要限定上肢的运动事件。下面将各段展示中的关键帧按时间展开,便于对照连续姿态;人物之间的横向间隔用于排列采样时刻,根运动与局部运动的区别也可通过绪论的网格播放器对照。
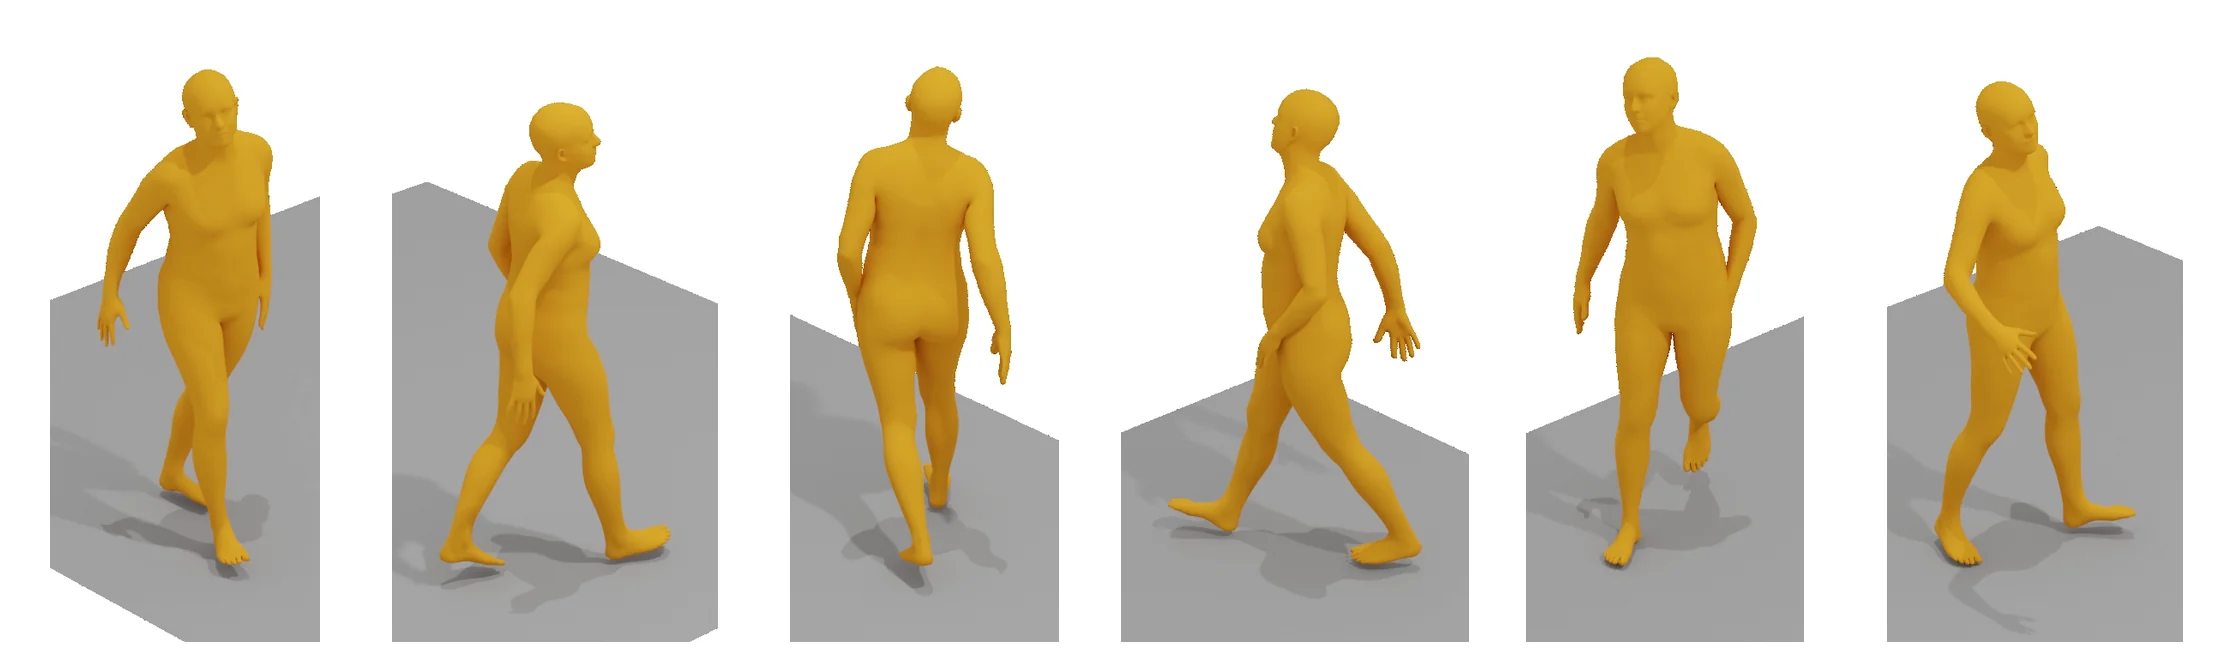
行走描述要求模型同时组织交替支撑、摆臂与转向。各帧的肩胯朝向与腿部配置需要随运动阶段协调变化,逐帧姿态合理并不足以保证整个步态连续。相比之下,“双臂在空中挥动”主要约束上肢的抬升与摆动,躯干和下肢仍需提供相容的全身姿态。
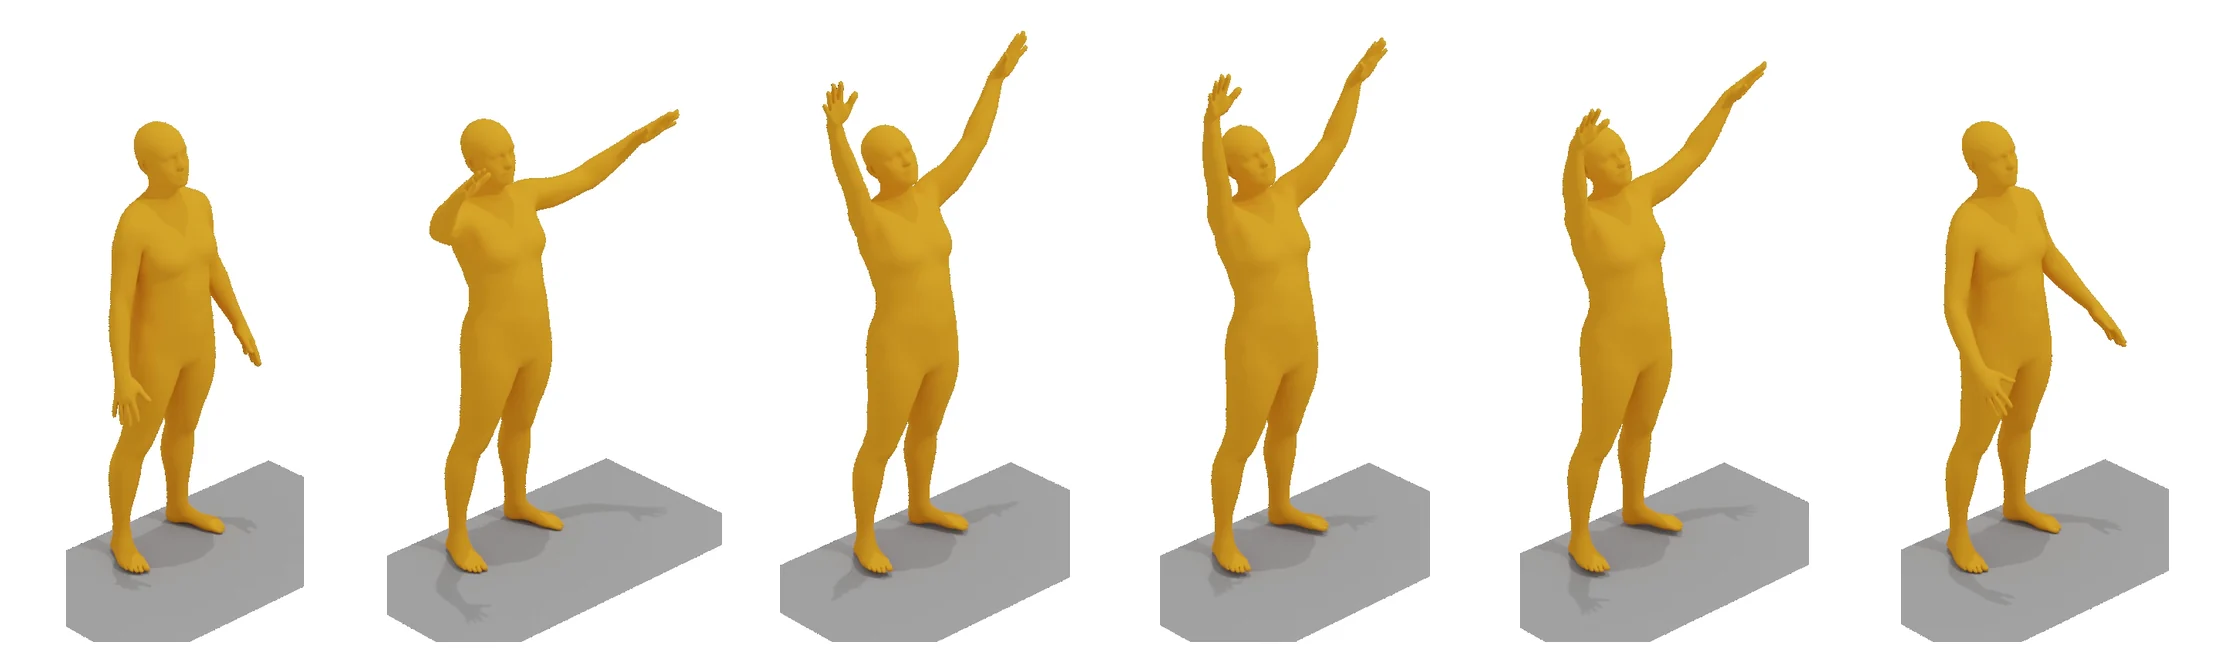
这组姿态呈现了手臂抬起、挥动和回落的事件顺序。“完成上举”与“持续保持上举”具有不同的时间要求:前者规定一个动作事件,后者还规定该姿态需要维持的区间。评价文本一致性时,应区分事件是否发生与持续时间是否满足描述;足部接触与身体平衡则需要另外观察。
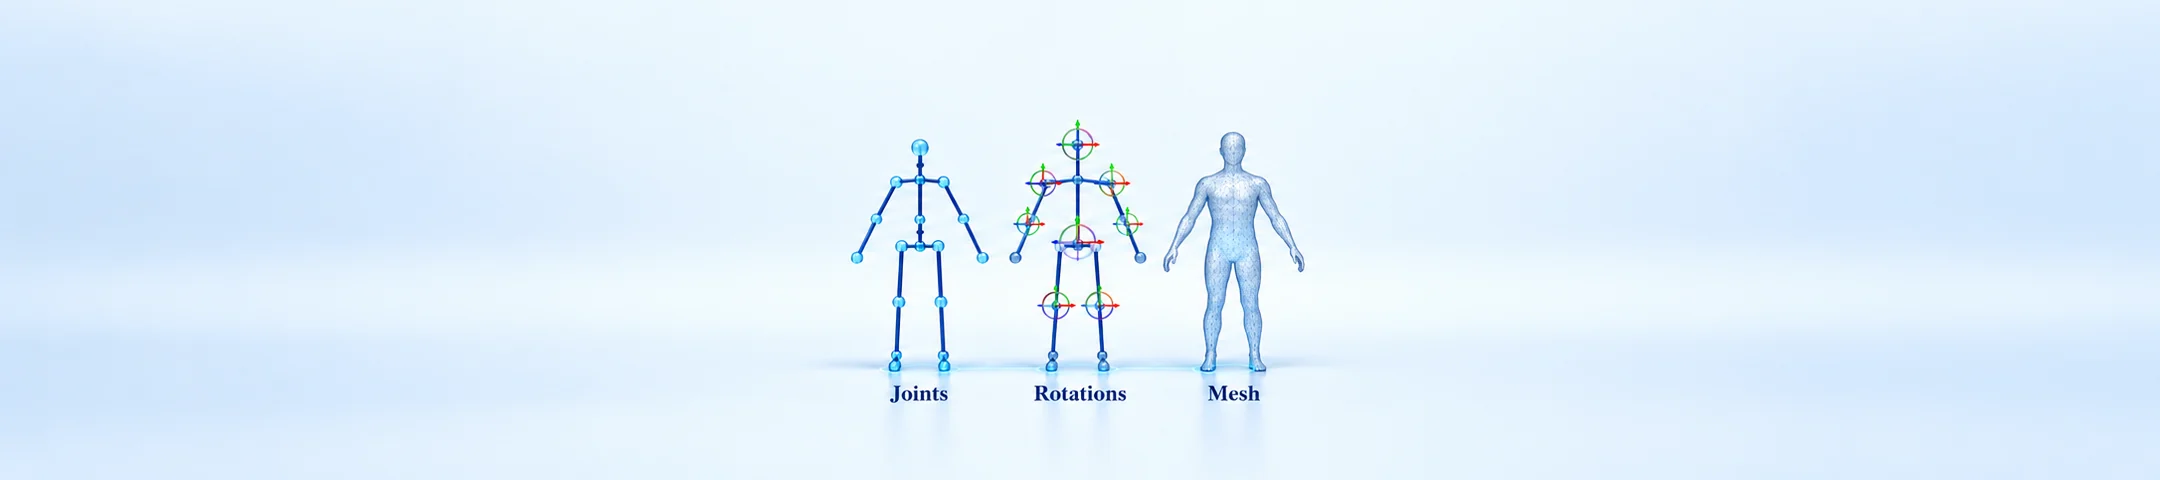
关节到人体表面的拟合还会引入几何误差。关节序列描述位置与速度,人体表面进一步呈现脚底接触、穿透和轮廓。关节位置仅对人体表面施加稀疏几何约束,关节到曲面的映射存在未观测自由度;因此关节轨迹接近并不保证脚底与地面的间距、法向或穿透量同样接近。
10.2 评价指标与误差来源
不同路线最终都输出运动,误差却可能出现在不同层次。首先,编码—解码重建衡量表示能保存的细节;其次,条件生成衡量文字与潜变量或 token 的对应;最后,关节恢复和表面拟合决定这些变量怎样呈现为几何。末端位置偏差可能来自前面的旋转误差,脚底穿透也可能来自最后的拟合,两者在渲染中都表现为姿态异常。
R-Precision 衡量正确文本在候选集合中的检索排名,matching distance 衡量动作与配对文字的特征距离。二者由评估编码器的语义空间决定,方向、次数或短暂状态若未被编码充分区分,也会被分数弱化。FID 比较真实与生成动作的特征分布;Diversity 描述跨条件样本间的变化,Multimodality 描述同一条件内的变化。它们分别观察配对、分布和多解性。评估映射 $E$ 通常不可逆,因而 $E(X_1)\approx E(X_2)$ 并不推出 $X_1\approx X_2$;被编码器压缩的短时接触或局部方向错误可能同时被多种特征空间指标忽略。
指标值还受到表示与评价空间影响。263维与272维表示配套的评价模型可能不同,同名 FID 因而未必处于同一特征空间。动作长度、引导强度和条件采样分布改变生成集合,也会改变检索、分布及多样性统计。
几何指标直接作用于坐标或旋转。接触时的足部速度刻画滑步,脚底最低点与地面的距离刻画悬空或穿透,骨长变化刻画骨架一致性,速度与加速度刻画时间变化。过度平滑会降低加速度,也可能抹去跳跃着地的真实冲击;这些运动学量描述几何与时序,动力学可执行性还涉及质量、惯量、接触力和执行器。
参考资料
Chuan Guo, Shihao Zou, Xinxin Zuo, Sen Wang, Wei Ji, Xingyu Li, and Li Cheng. Generating Diverse and Natural 3D Human Motions from Text. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 5152–5161, 2022.
Guy Tevet, Sigal Raab, Brian Gordon, Yoni Shafir, Daniel Cohen-Or, and Amit Haim Bermano. Human Motion Diffusion Model. In International Conference on Learning Representations, 2023.
Xin Chen, Biao Jiang, Wen Liu, Zilong Huang, Bin Fu, Tao Chen, and Gang Yu. Executing Your Commands via Motion Diffusion in Latent Space. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 18000–18010, 2023.
Jianrong Zhang, Yangsong Zhang, Xiaodong Cun, Yong Zhang, Hongwei Zhao, Hongtao Lu, Xi Shen, and Ying Shan. Generating Human Motion from Textual Descriptions with Discrete Representations. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 14730–14740, 2023.
Chuan Guo, Yuxuan Mu, Muhammad Gohar Javed, Sen Wang, and Li Cheng. MoMask: Generative Masked Modeling of 3D Human Motions. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 1900–1910, 2024.
Wenxun Dai, Ling-Hao Chen, Jingbo Wang, Jinpeng Liu, Bo Dai, and Yansong Tang. MotionLCM: Real-Time Controllable Motion Generation via Latent Consistency Model. In Computer Vision – ECCV 2024, pages 390–408, Springer, 2025.
Ke Fan, Shunlin Lu, Minyue Dai, Runyi Yu, Lixing Xiao, Zhiyang Dou, Junting Dong, Lizhuang Ma, and Jingbo Wang. Go to Zero: Towards Zero-shot Motion Generation with Million-scale Data. In Proceedings of the IEEE/CVF International Conference on Computer Vision, 2025.
Lixing Xiao, Shunlin Lu, Huaijin Pi, Ke Fan, Liang Pan, Yueer Zhou, Ziyong Feng, Xiaowei Zhou, Sida Peng, and Jingbo Wang. MotionStreamer: Streaming Motion Generation via Diffusion-based Autoregressive Model in Causal Latent Space. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 10086–10096, 2025.
Resources
- Text2Motion implementation and HumanML3D preprocessing.
- MDM implementation:
model/mdm.pyandmodel/cfg_sampler.py. - MLD implementation and T2M-GPT implementation.
- MoMask implementation:
models/mask_transformer/transformer.pyandgen_t2m.py. - MotionMillion implementation and MotionStreamer implementation.
- MotionLCM implementation, generated motion arrays, and numerical examples.
Figure credits
- MDM architecture: author project, CC BY-SA 4.0.
- MoMask architecture: Figure 2 of the CVPR paper. Character sequences: author project, CC BY-SA 4.0.
- MotionLCM pipeline: author project.
- MotionMillion result sequences: author project, CC BY-SA 4.0.
- MotionStreamer pipeline: author project.
- Circular-walking and arm-waving sequences: MotionLCM official demonstrations. Adaptations: chronological frame extraction, cropping, uniform rescaling, and temporal layout.