CH-02 3D 人体运动建模范式
统一的运动表示使动作能够被存储、比较与恢复,但它并未确定关节如何协调、姿态如何随时间演化。同样的起始状态与行为条件往往允许多种运动,而各关节和各帧又不能独立取值:支撑脚、根运动与摆动肢体必须形成相容的序列。模型因此需要同时表达时空依赖和条件下的多解性。
Motion modeling(运动建模)通过学习人体状态的联合分布,将这些依赖转化为可预测或可采样的计算过程。模型可以直接处理逐帧特征,也可以先压缩为连续 latent variable(潜变量)或离散 motion token(动作编号);Transformer 等骨干则可用于自回归预测、masked modeling 或去噪估计。不同方案的区别既涉及信息如何传递,也涉及输出分布如何定义。
从人体运动的表示、生成模型的网络架构,再到概率目标与采样算法的设计,运动建模包含几个相互联系的层次。首先,运动表示规定模型需要处理哪些几何变量,以及如何从预测值恢复人体。其次,网络架构规定各关节和各时刻之间的信息传递方式;再次,训练目标规定模型如何学习条件分布;最后,采样算法则规定推理时如何依据已学习的模型构造运动序列。同一个 Transformer 骨干可以用于自回归预测或扩散去噪,但二者的训练输入、预测目标与生成过程仍有区别。
为避免混淆这些计算过程中的时间变量,物理运动以 $t\in\{0,\ldots,T-1\}$ 索引,相邻帧相隔 $\Delta t=1/f$。压缩后的 token 位置记为 $i$,离散加噪步记为 $k$,连续生成参数记为 $s\in[0,1]$。一个去噪步会更新整段运动或一个动作块,其中已经包含多个物理帧;两种时间维度对应不同的依赖关系。
1. 条件分布与动作多解
1.1 条件不能确定全部细节
例如,“向前走”规定了总体行为,却没有指定步幅、速度、起步腿、摆臂或最终位置。即使增加目标轨迹,身体各部位仍可能有多种实现。生成任务需要保留这些未被条件确定的变化,同时满足条件已经规定的部分。
条件生成据此学习已有信息下的运动分布。令运动序列为 $X\in\mathbb R^{T\times D}$,已有条件为 $C$;文字、历史动作、轨迹、关键姿态和场景几何都可以进入 $C$。目标是学习条件分布 $p_\theta(X\mid C)$,而不是默认每个条件对应唯一坐标数组。
动作预测也有多解。例如,根据前两秒行走,人物可能继续前进、转弯或停下;预测均值与采样未来拥有不同用途。补全与编辑则额外包含已知区域,要求模型保留它们或按任务协议重建。
1.2 均方回归的条件均值
多解性会直接影响训练目标。若网络对每个条件只输出一个确定预测 $a(C)$,并最小化平方误差,那么它趋向于学习条件均值。在给定条件下,将 $X-a$ 分解为 $(X-\mu_C)+(\mu_C-a)$,可得
交叉项因条件均值定义而为零,最优解是 $a=\mu_C$。条件均值在欧氏特征空间中合理,却可能落在有效动作集合之外。例如,两种固定骨长姿态的坐标平均,可以使骨骼缩短;两个步态相位的平均,也可能丢失明显的足部抬起过程。
1.3 固定骨长的合成算例
三维单位骨骼的端点位于球面 $S^2$,平面运动则将端点限制在单位圆上。平方误差的最优解是在欧氏嵌入空间中计算;平面算例取同一条件下的两个等概率姿态,展示非凸几何约束为何不能由无约束均值保持。
1 | import numpy as np |
运行结果:
1 | sample bone lengths: [1.0, 1.0] |
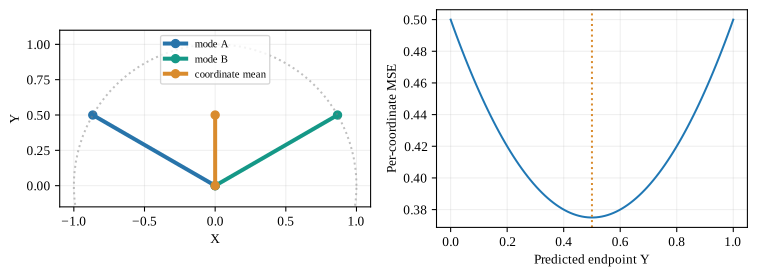
算例中的最优均值位于单位圆的内部。将其径向投影回圆周可以恢复骨长,却不会恢复被均值合并的两个模式。旋转预测与 FK 通过参数化维持运动链结构,随机潜变量或条件分布则保留多解性;二者分别解决约束满足与概率覆盖。
2. 时间与空间的张量组织
要用神经网络表示运动的条件分布,首先需要确定网络以什么单位接收运动信息。以整帧、关节或身体部位为单元,会形成不同的时空信息传递结构,并影响计算复杂度与控制粒度。
2.1 整帧、关节与部位
具体而言,整帧特征 [B,T,D] 将每帧位置、旋转和根信息合在一个向量里,便于沿时间建模。关节特征 [B,T,J,d] 保留关节轴,适合利用骨架连接或关节之间的注意力。部位分组则把躯干、上肢和下肢组织为较少单元。
输入单元同时规定网络的归纳偏置。整帧对应单个 token 时,关节间关系主要由通道投影与后续特征变换编码;每关节对应一个 token 时,模型需要显式区分关节身份、时间位置及骨架连接。根运动还可采用独立通道或全局 token,以保留整体位移与局部姿态之间的结构差异。
多人的人物轴、残差量化的层轴和动作的时间轴也必须分开。例如 [B,N,Q] 中 $N$ 是时序压缩后长度,$Q$ 是残差量化层数,不应被当成 $Q$ 个运动帧。
以整帧输入为例,HumanML3D 的 [B,T,263] 特征先经过线性层 $H=XW+b$,其中 $W\in\mathbb R^{263\times d_h}$。输出 [B,T,d_h] 保留帧数,将每帧的几何通道映射为隐藏特征;时间位置编码随后加到这个张量上。注意力层沿 $T$ 个位置交换信息,前馈层则在每个位置内变换特征。最后用 $d_h\rightarrow263$ 的输出层恢复逐帧运动参数。线性投影负责表示转换,时间注意力负责跨帧关联,两者承担的计算不同。
2.2 循环、卷积与图
网络骨干规定各输入单元的信息聚合方式。循环神经网络(RNN)利用隐藏状态递推编码历史;时序卷积网络(temporal CNN)在局部时间窗口内提取模式,并可通过膨胀卷积扩大感受野。因果卷积仅依赖当前及过去输入,双向窗口则可利用未来上下文,两者分别适用于不同的信息可见协议。
若输入保留关节轴,还可以把骨架视为图:关节是节点,骨骼连接是边。图网络利用邻接矩阵 $A$ 混合相邻关节的特征,一个基本层可写为
其中 $\tilde A$ 包含归一化与可能的自连接。骨架相邻关节具有运动学关联,但长程交互也很重要。例如,两手可能共同托举,支撑脚与根姿态共同决定身体状态。增加图边、全局单元或注意力,可以引入更远关系。
图中的边规定特征交换路径;固定骨长和关节限位则由运动表示、输出变换或训练损失表达。例如,图网络预测局部旋转后再执行 FK,就能同时利用拓扑信息与固定骨架。
2.3 联合与分解注意力
Self-attention 直接建立序列位置间的关联,能够建模超出局部时间窗口或单条骨架边的依赖。将 $TJ$ 个关节—时间位置联合建模时,注意力矩阵规模为 $O(T^2J^2)$;先进行帧内空间注意力,再进行逐关节时间注意力时,规模降为 $O(TJ^2+JT^2)$。分解结构减少计算量,同时限制单层中直接交互的路径。
这里的复杂度指注意力权重的主要规模,省略批量、head 数与通道投影成本。联合注意力在一次聚合中建立任意两位置的直接联系;空间—时间分解通过中间位置传递跨关节、跨时刻信息。增加层数能扩大组合依赖,但并不使分解参数化与任意联合注意力完全等价。两种结构都需要几何输出约束,注意力关联本身不执行骨长投影。
时间位置编码区分前后,关节身份编码区分左右与部位。若将两人接入共同注意力,还需要人物身份与相对几何,以便网络区分自己的手臂运动和对方的身体反应。
3. 有效长度与任务掩码
动作长度不一,预测与补全任务允许读取的时间区间也不同。统一的张量形状无法表达这些差异,需要用 Mask 显式规定有效位置及允许的信息依赖。具体而言,Padding mask 排除批量补齐产生的占位值;causal mask 限制未来信息;观测 mask 则区分已知状态与待生成区域。它们分别对应数据有效性、因果协议和任务条件,不能互相替代。
3.1 Padding 的计算影响
不同长度动作通常补齐到统一长度 $T_{\max}$。令 $m_{b,t}=1$ 表示有效帧,特征损失可以写为
分母按有效元素数归一化,使相同序列不会仅因 padding 长度不同而改变损失尺度。若将占位值纳入监督,模型会额外拟合无运动含义的通道值,损失也不再准确反映有效帧的重建误差。
这一目标对有效帧等权,因此较长序列在批量损失中占比更高。若训练目标要求每段运动等权,应先在每个样本内部除以有效长度,再对样本求平均。两种归一化对应不同的经验分布,不能仅因输出都是标量便视为等价。
掩码同样需要进入注意力、池化和分布统计。即使最终损失忽略 padding,前面的注意力若已经读取补齐位置,有效帧输出仍可能被影响。归一化统计量应从训练集有效帧估计,而非混入测试动作和补齐值。
若损失涉及时间差分,掩码还需要检查成对位置是否有效。计算 $p_{t+1}-p_t$ 时,对应掩码应检查 $m_t m_{t+1}$;只检查第一帧有效,会把片段末帧与补齐值之间的跳变当作真实速度。二阶差分则需要连续三个有效位置。长度掩码必须随所计算的量变化,不能对所有损失直接复用同一张帧掩码。
3.2 未来信息的可见范围
预测任务允许读取历史,禁止读取目标未来;中间补全允许读取缺口之后的已知片段;离线理解可以读取整段动作。因果性来自完整数据流的约束,而不只来自某一层的下三角掩码。
因果结构需要贯穿编码、生成和解码三个环节。例如,如果编码器把未来帧压缩进当前潜变量,生成器便会间接获得未来信息;如果解码器依赖后续潜变量,当前动作就需要等待后续生成。因此,流式系统通常将可见历史与等待窗口同时写入各个模块的结构。
4. Latent Space 与 VAE
4.1 Autoencoder 的压缩接口
直接建模逐帧特征时,生成器需要处理完整时间轴上的几何通道。相邻运动帧具有较强相关性,学习式压缩可以将重复的局部变化组织为较少的潜单元,再由解码器恢复细节。Autoencoder(AE,自编码器)以 $Z=E_\phi(X)$ 编码动作,并通过 $\hat X=D_\psi(Z)$ 重建序列。编码器产生的中间表示空间称为 latent space(潜空间),其变量不必与某个具体关节或物理帧一一对应。时序下采样产生 $Z\in\mathbb R^{N\times d}$,其中 $N<T$;全局聚合结构则可将整段运动编码为固定数量的潜向量。
时序压缩率与存储压缩率不同。例如,时间位置减少为原来的四分之一,但潜维度增加时,浮点数总量未必减少四倍。压缩器的感受野还会影响短手势、快速转身和接触边界能否保留。
重建目标主要约束训练样本所覆盖的 latent space 区域,并不规定任意潜变量的解码行为。普通 AE 的聚合编码分布可能不连续或高度不均匀,因而从预设分布直接采样未必得到有效动作。生成模型需要进一步约束潜分布,或单独学习潜变量的生成过程。
4.2 变分下界
Variational autoencoder(VAE)通过近似后验 $q_\phi(Z\mid X)$ 与先验 $p(Z)$ 建立可采样的潜变量模型。后验描述观测动作对应的潜分布,先验规定生成时的采样分布。对于条件生成模型,边缘对数似然满足
这里简记 $q_c=q_\phi(Z\mid X,C)$、$p_c=p(Z\mid C)$,分别表示条件后验与条件先验。该式是对潜变量边缘似然使用 Jensen 不等式得到的 evidence lower bound(ELBO,证据下界)。实际系统也可以先训练不带文字的动作 VAE,再单独学习条件潜分布;此时动作压缩损失与文字生成损失不属于同一次直接优化。
对于对角高斯后验和标准正态先验,KL 为
采样写成 $z=\mu+\sigma\odot\epsilon$,$\epsilon\sim\mathcal N(0,I)$,便于梯度传播。重建项保留细节,分布项约束 latent space;权重过大可能损失重建,过小可能削弱采样组织。若解码器主要依赖其他输入而忽略潜变量,后验就容易趋近先验、丢失动作信息,形成 posterior collapse(后验坍塌)。
分布正则的双重作用可由一个恒等式分离。以不带条件的动作压缩器为例,令聚合后验为 $q(Z)=\int q_\phi(Z\mid X)p_{\mathrm{data}}(X)\,dX$,则
KL 既促使聚合后验匹配先验,也限制潜变量携带的动作信息。将其权重增大并非单纯改善采样分布:重建所需的细粒度信息也可能被压缩。条件解码器若能绕过潜变量完成主要重建,第一项可能趋近零;这是 posterior collapse 的信息论含义,与 VQ 中部分 codebook 条目闲置属于不同机制。
4.3 文本与运动的分布对齐
在动作 VAE 的基础上进行文本条件生成,还需要让语言指向相应的潜区域。TEMOS 为文本和运动分别设置编码器:文字编码为 $q_{\mathrm{text}}(z\mid C)$,配对动作编码为 $q_{\mathrm{motion}}(z\mid X)$,两者都是由均值和方差描述的高斯分布。训练时分别从两个分布采样,再交给同一个动作解码器恢复序列。
运动分支能够读取完整训练动作,文本分支只能读取配对描述,因此两条路径获得的信息不同。共享解码器分别将两个分支的样本恢复为动作,并对同一个真实序列计算重建损失;这样,语言产生的潜变量也必须携带可供动作解码器使用的信息。分布对齐进一步约束两条路径在相同语义下的对应关系。简记 $q_{\mathrm{txt}}=q_{\mathrm{text}}$、$q_{\mathrm{mot}}=q_{\mathrm{motion}}$,$p_0=\mathcal N(0,I)$,联合目标由以下几类项组成:
两条重建路径采用 Smooth L1 loss(平滑 L1 损失)。除了分布对齐,采样后的文本与运动向量 $z_{\mathrm{txt}}$、$z_{\mathrm{mot}}$ 还接受 Embedding similarity loss,以约束配对样本在共享表示中的位置:
训练按权重组合这些损失,梯度同时进入文本编码器、运动编码器和共享解码器。其中,双向 KL 将两个分布的均值与不确定性纳入对齐,先验项则使采样区域接近标准正态。由于文字没有指定全部步态与姿态细节,过强的对齐或先验约束仍可能损失运动变化;重建质量与条件下的多样性需要共同评价。
下图给出双分支的完整数据流。运动帧和文本分别经各自编码器聚合,distribution token 的输出参数化高斯分布;采样后的潜向量输入共享解码器,时间位置编码则规定输出时刻。训练同时使用运动与文本分支,生成时由文本分支提供潜变量分布。
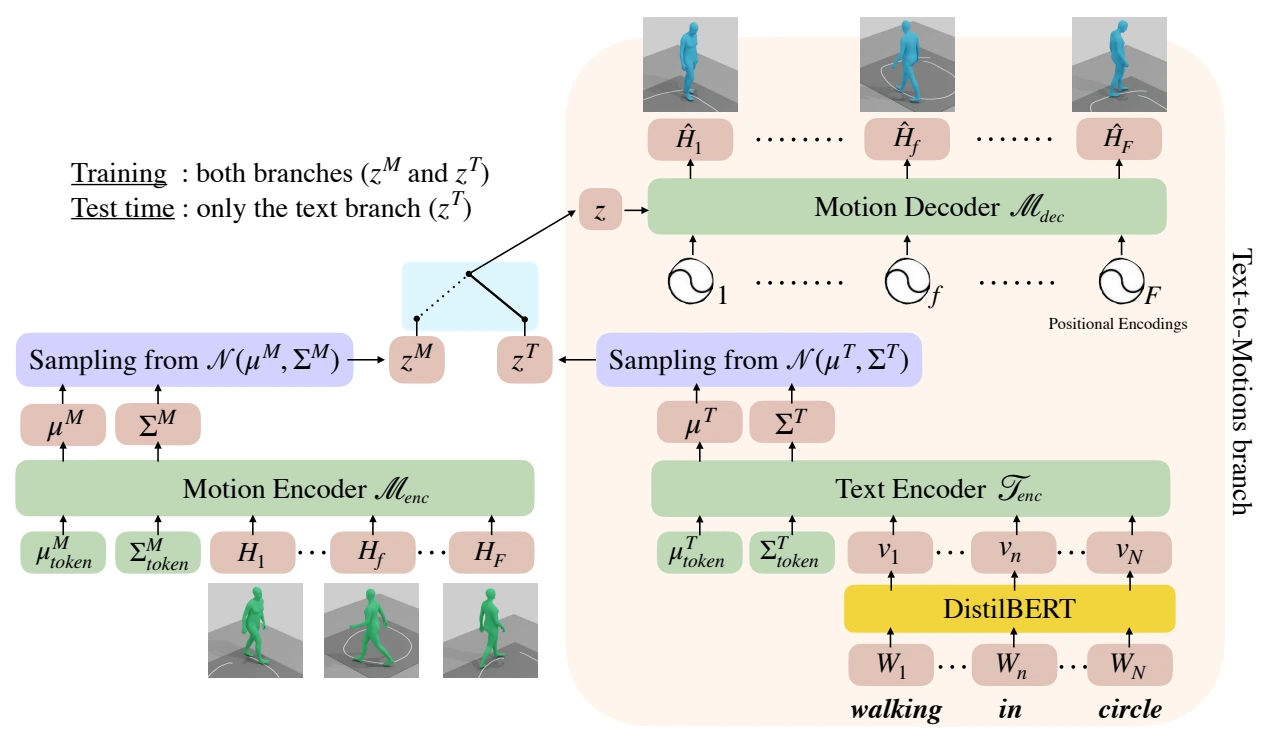
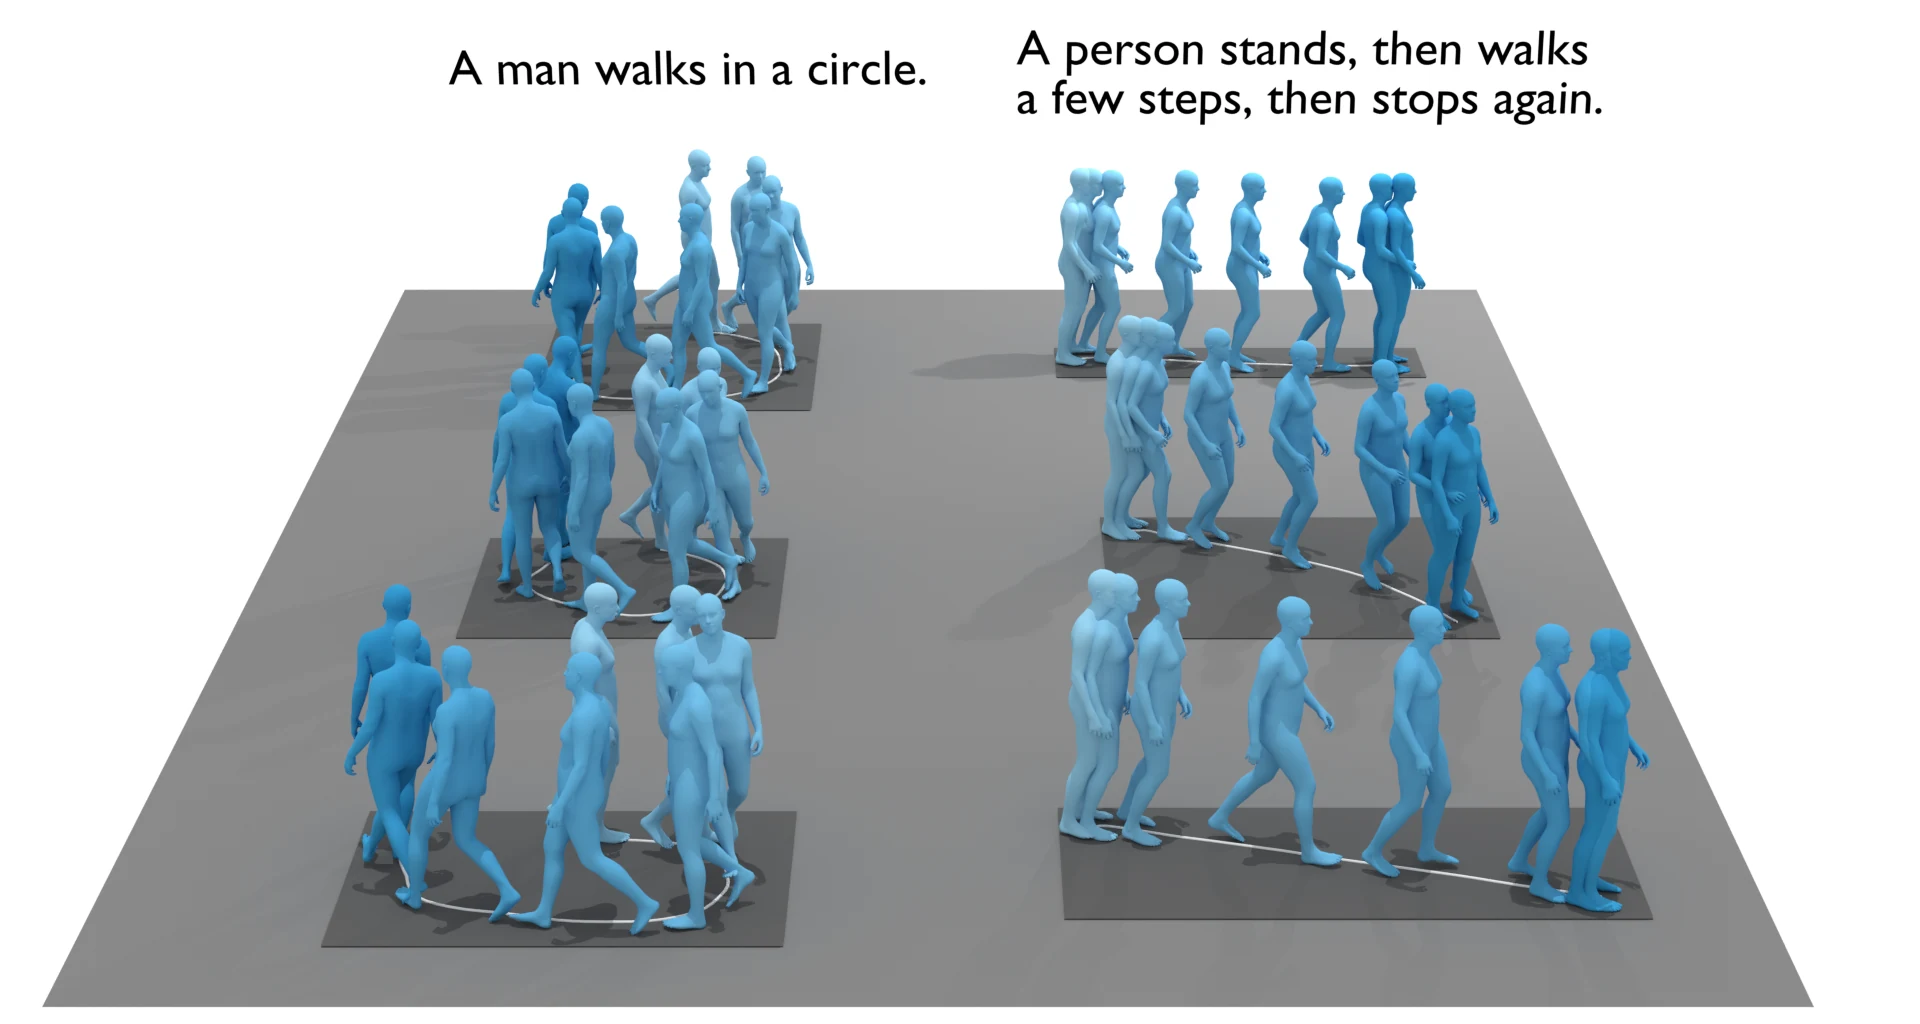
推理时,这一流程依次完成三个步骤:首先由文字给出分布参数,随后采样得到潜向量,最后由解码器结合目标长度输出逐帧姿态。同一句话因此能够生成多条动作。下图左侧保留了环形行走的语义,右侧保留了“站立—行走—停止”的阶段顺序;各次采样的路径形状、步幅与局部姿态仍可变化。
4.4 Latent Diffusion 的编码与解码
MLD 将动作压缩与条件生成分成两个阶段。第一阶段用动作 VAE 学习一个较低维、可重建的 latent space;第二阶段固定 VAE,在 latent space 中学习文字条件去噪。扩散网络由此集中处理少量潜变量,逐帧展开由运动解码器完成。
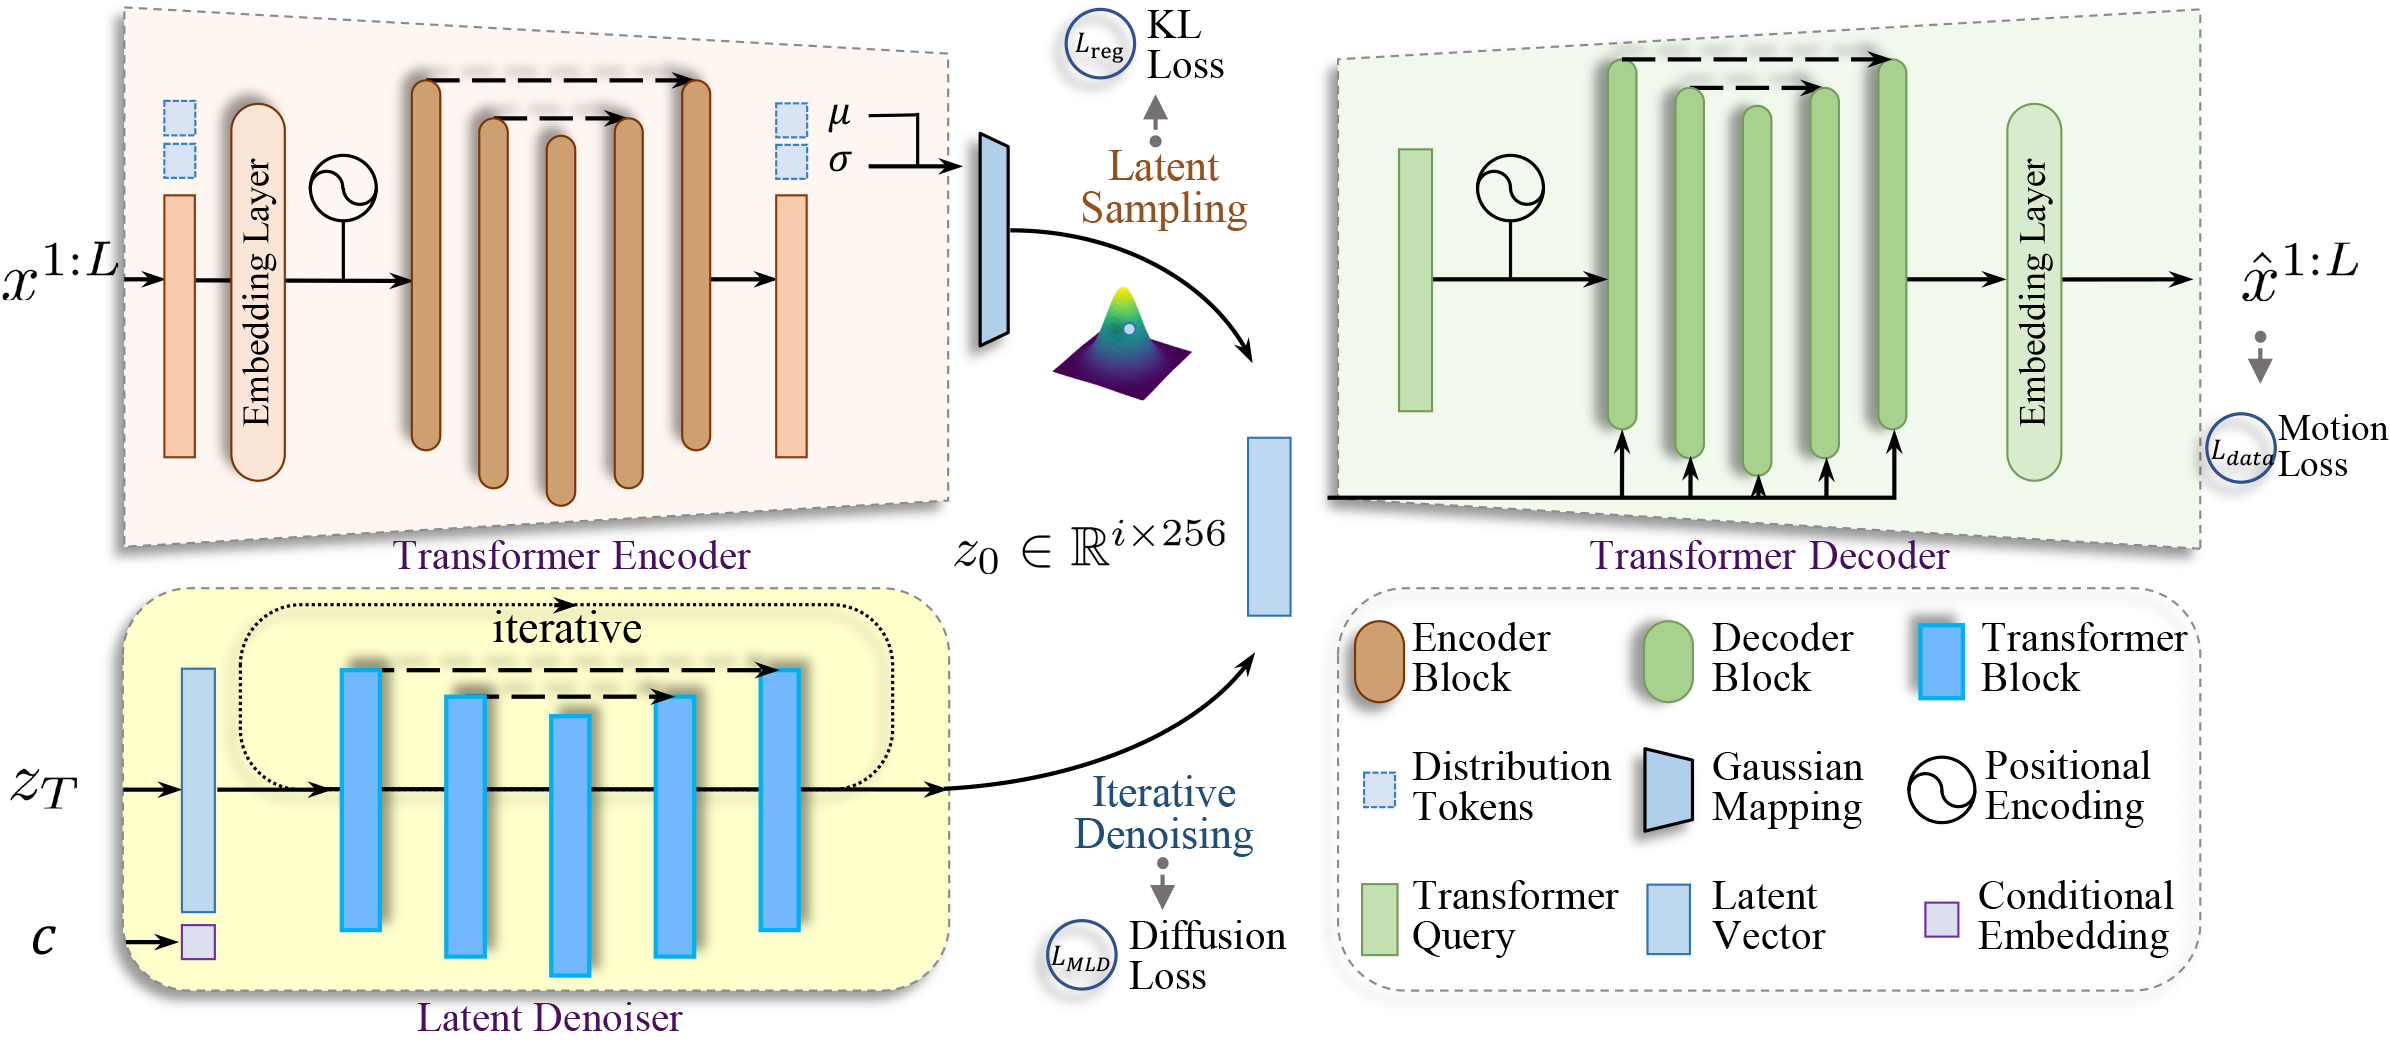
具体到编码过程,MLD 的压缩接口将变长时间序列映射为固定数量的随机潜向量。MldVae.encode 的 skel_embedding 将 [B,T,D] 投影并重排为 [T,B,d_z];轴交换适配注意力接口,未改变运动时间顺序。分布 token 分支在前方接入 $2N$ 个可学习查询,其中 $N$ 个读出均值,其余读出对数方差。经过全局注意力,这些查询聚合全部有效帧,形成 [N,B,d_z] 的高斯潜变量。$N$ 是聚合查询数,不能解释为均匀抽取的 $N$ 个运动帧。
与编码过程对应,解码器需要把固定数量的潜向量重新展开到目标长度 $T$。decode 为每个输出时刻建立一个初值为零的查询向量,并加入时间位置编码。在 all_encoder 分支中,潜向量与这些查询拼接后共同进入 Transformer,最终只保留查询位置的输出;encoder_decoder 分支则让时间查询通过交叉注意力读取潜向量。末层把隐藏特征投影回 $D$ 个动作通道,得到 [B,T,D]。
每个解码 query 对应一个目标采样时刻。目标长度决定 query 数量,positional encoding 区分时间位置,潜变量提供运动内容。长度条件因而通过 query 序列作用于输出,而无需为不同帧数设置独立输出层。
5. VQ、残差量化与 FSQ
5.1 Vector Quantization
连续潜变量便于重建几何,而采用词表分类的序列模型需要有限的符号空间。将动作接入这类模型时,可以把潜变量进一步映射为离散编号。Vector quantization(VQ,向量量化)维护一个由码向量 $e_v$ 组成的 codebook,将连续向量 $z$ 映射到最近码向量:
最近邻选择产生离散索引,不能直接通过该选择对编码器求导。经典 VQ-VAE 因而采用 straight-through estimator(STE,直通梯度估计),将解码器对量化向量的梯度近似传给量化前的连续向量。令 $e=e_{v^*}$,$\operatorname{sg}$ 表示 stop-gradient(停止梯度),其量化目标为
这三项分别约束重建、码向量与编码器输出:重建项更新解码器,并通过 STE 更新编码器;第二项使选中的 codebook 向量接近编码器输出;第三项是 commitment loss,使编码器输出接近选中的向量,避免连续特征不断偏离离散集合。若采用 exponential moving average(EMA,指数移动平均)更新 codebook,则按各条目的分配次数与向量和更新其中心,代替第二项的显式梯度更新。两种实现共享最近邻量化接口,但 codebook 的优化过程不同。
有效压缩能力同时取决于 codebook 容量与 code usage。若训练样本集中分配到少数条目,其余条目长期缺少更新,会出现 dead codes。EMA 更新、低频条目重置及训练目标调整分别作用于统计更新和利用率,但并不改变最近邻量化的基本定义。
5.2 Residual Vector Quantization
单次量化只能在有限码向量中选择,未被表示的部分形成量化残差。Residual vector quantization(RVQ,残差向量量化)用后续 codebook 继续表示这个残差。令 $r_0=z$,每层选择 $e^{(q)}_{v_q}$,并更新
第一级量化近似原潜向量,后续各级近似尚未编码的残差。时间轴 $N$ 与量化层轴 $Q$ 因此具有不同语义:同一时间位置上的多个索引共同恢复一个潜向量,而非对应额外运动帧。
MoMask 的 RVQVAE 以 [B,D,T] 布局进行时序压缩,由 ResidualVQ 把每个连续潜向量分解为多层离散索引。解码端 forward_decoder 按索引查表,并沿残差层轴求和,再由运动解码器展开时间轴。求和作用于同一潜位置的不同精度层,不能沿时间轴进行;高层编号也无法脱离低层编号独立解释为完整动作。
5.3 Finite Scalar Quantization
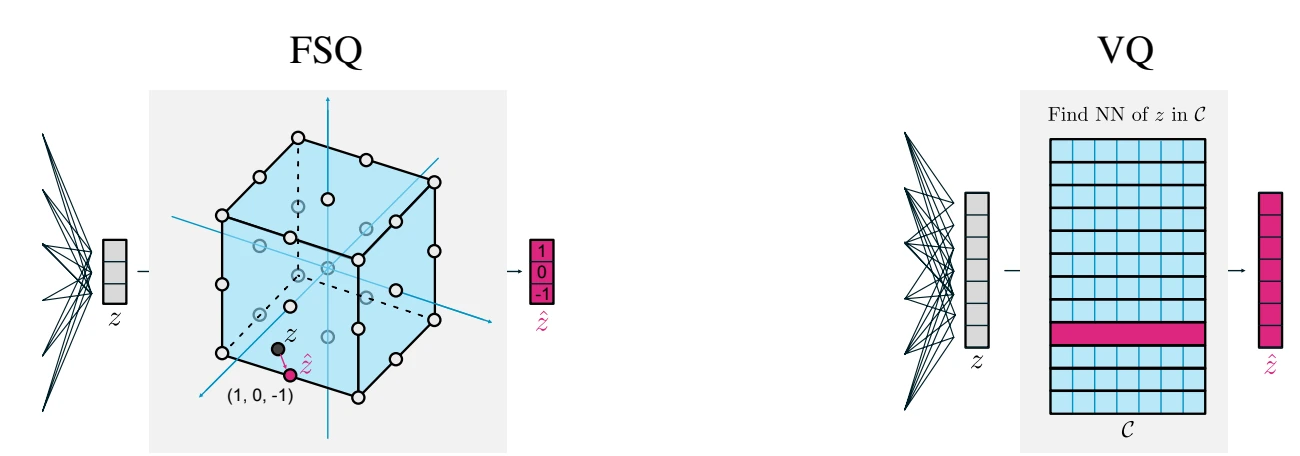
量化不一定需要搜索可学习向量 codebook。Finite scalar quantization(FSQ,有限标量量化)先把表示投影到少量连续维度,每维经过有界变换并量化到有限等级。若第 $i$ 维有 $L_i$ 个值,组合得到 $\prod_iL_i$ 个隐式码字。
FSQ 用固定标量网格完成离散化,把学习重点放在网格前的投影和网格后的解码,省去了最近邻 codebook 更新与经典 VQ 的 commitment loss。各维等级决定理论容量,训练数据则决定实际使用哪些组合。
下图对照两种量化几何:FSQ 将低维坐标映射到规则网格,VQ 则从可学习向量集合中选择最近条目。前者的离散集合由各维等级的笛卡尔积隐式定义,后者的几何分布由 codebook 学习决定。二者均可输出离散索引,供后续序列模型预测。
离散压缩的存储预算可以按编号计算。若时序长度为 $N$,每位置有 $Q$ 层、每层 codebook 大小为 $V$,固定长度编码约需要 $NQ\lceil\log_2V\rceil$ 比特,不包含 codebook、模型权重与元数据。增加残差层提高容量,也增加编号存储和生成开销;相同时间压缩率不意味着相同码率。FSQ 则由各维等级的乘积决定单个组合编号的范围。
5.4 三种量化的二维算例
二维算例将量化单元的几何结构显式化:单层 VQ 选择一个离散代表,残差量化通过向量和扩大可重建集合,FSQ 则使用坐标等级的笛卡尔积。箭头对应残差在第二层的近似,不表示真实动作在物理时间上的变化。
1 | import numpy as np |
运行结果:
1 | first-stage code ids: [3, 1, 4, 4] |
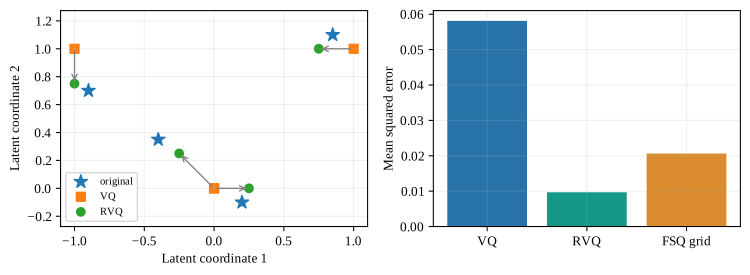
量化产生 $\delta z=\hat z-z$。令未量化潜变量的重建为 $X_{\mathrm{base}}=D(z)$、量化后的重建为 $\hat X=D(\hat z)$,量化引入的额外变化满足 $\hat X-X_{\mathrm{base}}\approx J_D(z)\delta z$,其中 $J_D(z)$ 是解码器关于潜变量的 Jacobian。若运动空间的局部误差采用权重 $W\succeq0$,则
矩阵 $J_D^\top WJ_D$ 把运动空间的敏感性拉回 latent space。与原始动作 $X$ 比较时,总残差为 $(X_{\mathrm{base}}-X)+(\hat X-X_{\mathrm{base}})$,还包含压缩器已有的重建误差,二者不能混同。同样的欧氏量化误差,沿手部接触敏感方向与冗余方向可能产生完全不同的后果。二维 codebook 图说明离散逼近的结构,实际运动保真度还取决于解码器的局部条件数和所选择的几何失真。
6. 自回归与掩码生成
压缩器建立了动作与潜变量或编号之间的映射,条件生成器进一步学习给定文字时应当产生哪些中间表示。自回归与掩码建模分别采用按顺序预测、依据可见内容恢复的组织方式。
6.1 Autoregressive 概率分解
Autoregressive modeling(自回归建模)选定生成顺序,每一步根据已有输出预测下一个单元。对连续潜变量或离散编号 $U=(u_1,\ldots,u_N)$,链式法则给出
这是链式分解,不要求 $u_i$ 必须离散。离散模型可输出词表概率,连续模型则需要连续分布头。生成顺序可按时间、部位或其他协议选择;动作时间顺序是一种常用安排。
训练通常使用 teacher forcing,以真实前缀为条件,并通过 causal mask 并行计算各位置的预测损失;推理则基于已生成前缀逐步采样。两阶段条件分布的差异构成 exposure bias,早期预测误差可能通过后续条件累积。
这种偏移发生在生成序列的条件分布上,不等于每帧位移积分造成的根漂移。即使生成器完全并行,增量表示也可能积累位移误差;反之,自回归模型若具有校正反馈、适当训练覆盖和稳定状态更新,也不必随序列长度单调退化。概率分解、表示恢复与闭环执行应分别分析。
6.2 Masked Modeling
Masked modeling把一部分单元暂时隐藏,要求模型根据剩余内容恢复它们。对随机掩码集合 $\mathcal M$,离散模型读取已知编号与条件,在缺失位置学习
迭代 masked sampling 可从全部或部分未知 token 开始,联合预测候选分布,按置信度保留部分结果,再更新其余位置。单次前向能够并行预测多个位置,但最终样本仍由多轮更新共同确定。
掩码模型允许使用两侧已知内容,适合整段生成和补全;若用于严格在线输出,则需重新限制可见范围与不可撤销区域。最大 softmax 概率只是模型置信度,不必等于动作的语义正确率。
6.3 三条独立设计轴
这类生成器的设计涉及三个不同维度:连续或离散描述输出空间;因果或双向描述信息范围;整段或分块描述处理粒度。离散编号可以因果生成,也可以双向掩码恢复;连续潜变量可以整段去噪,也可以由自回归骨干调用小型生成头逐块采样。
这些设计轴可以组合。例如,连续动作块能够按时间自回归生成,每个块内部再通过扩散采样获得细节;离散 token 也能够在双向上下文中通过掩码恢复。动作表示、信息可见范围与采样顺序共同确定模型行为。
7. Diffusion 与 Flow Matching
除了按顺序预测或恢复被遮蔽的单元,连续运动或连续潜变量还可以通过逐步改变随机样本来生成。扩散学习不同噪声水平下的恢复,流匹配学习噪声到数据路径上的速度场;这两种方法的迭代轴都不同于人体的运动时间轴。
7.1 前向加噪与去噪目标
Diffusion model(扩散模型)先规定一个逐步加噪的前向过程,再学习其反向恢复。对 clean motion 特征或潜变量 $X_0$,给定噪声步骤 $k$ 时可直接采样
其中 $k$ 表示 diffusion timestep,与人体运动的帧索引不同。对常用离散前向过程,$\beta_k$ 是第 $k$ 步的噪声方差,$\alpha_k=1-\beta_k$,累计系数定义为
$\bar\alpha_k$ 控制加噪后保留的原始信号比例:它越小,输入中的噪声占比越高。模型输入仍包含整段 [T,D] 序列或其潜表示,并额外接收 timestep Embedding 及条件特征。常见预测参数化包括 noise prediction、clean motion prediction 与 v-prediction。这里的 $v$ 是信号与噪声的组合参数:
它用于定义去噪监督,不表示人体关节在物理时间上的速度,也不等同于下一节 Flow Matching 所学习的路径速度场。不同预测参数化对应不同的监督尺度。
若预测噪声,可由
恢复 clean motion 的估计。不同目标之间可以进行代数转换,但损失的时间权重与数值尺度随参数化改变,训练目标也需相应定义。
MDM 的 GaussianDiffusion 用 q_sample 构造带噪输入,并根据目标类型组织监督。START_X 以 clean motion 作为回归目标,EPSILON 则以加入的噪声作为目标。前者直接给出动作估计,便于继续恢复关节并计算运动几何损失。
7.2 误差随噪声强度变化
加噪状态固定时,噪声预测误差 $\delta\epsilon$ 引起的 clean motion 误差满足
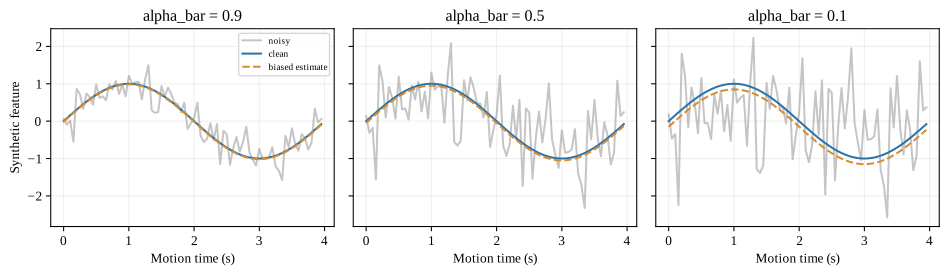
高噪声区间的放大系数更大,因此不同预测参数化的等权 MSE 隐含不同的 clean motion 误差权重。为观察这一影响,正弦轨迹算例固定噪声估计偏差,只改变 $\bar\alpha_k$,用于分离这一代数敏感性。
1 | import numpy as np |
运行结果:
1 | alpha_bar=0.9: oracle error=0.00000000, biased MAE=0.016667 |
7.3 连续速度场
Flow Matching(流匹配)通过学习向量场,把随机样本连续地输送到数据分布。以噪声 $\epsilon$ 到数据 $X$ 的直线路径为例,训练路径与目标速度为
训练目标最小化路径速度的平方误差。多条样本路径可以经过相同中间状态,因此最优网络学习条件均值场
该向量场与中间边缘密度 $p_s$ 满足相应的连续性方程 $\partial_s p_s+\nabla_x\cdot(p_s v^*)=0$。在正则性与精确建模条件下,积分 $d x/ds=v^*(x,s,C)$ 输送这些边缘分布;推理轨迹并不需要复现某一对训练端点的直线。有限网络误差和 ODE 离散误差都会改变最终分布。$s$ 描述分布输送,网络输出中的物理帧轴 $t$ 仍完整保留。
扩散与流匹配都学习连续分布,但路径、目标和采样器有所不同。它们可以在原始运动特征上工作,也可以在连续 latent space 工作;若结合自回归,每个动作块内部还可以具有自己的去噪或积分循环。
8. 条件注入与训练接口
概率目标中的条件 $C$,最终必须变成网络实际读取的张量。条件注入决定文字或控制信号在哪一层、以什么形式影响预测;同一种生成目标可以搭配不同注入方式。
8.1 条件进入网络的位置
文本条件可编码成单个全局向量,也可保留词序列。将这些特征接入运动网络,常见方法有三种:拼接把条件作为额外输入;交叉注意力让运动查询读取条件键和值;特征调制根据条件产生缩放与偏置,例如 $h'=\gamma(C)\odot h+\beta(C)$。
全局向量概括整体行为,词序列保留更细的语言结构。为了落实“右手”“两次”“先后”等信息,模型还需要从配对数据中学习文字与身体部位、运动时段的对应。
以交叉注意力为例,设运动隐藏状态为 $H_x\in\mathbb R^{B\times T\times d}$,文本特征为 $H_c\in\mathbb R^{B\times L\times d_c}$。交叉注意力先计算 $Q=H_xW_Q$、$K=H_cW_K$ 和 $V=H_cW_V$。每个注意力头形成 [B,T,L] 的权重,让每个运动时刻按相关性读取 $L$ 个文字位置,再把汇总结果通过输出投影和残差连接送回运动特征。文字长度 $L$ 与动作长度 $T$ 可以不同,两种序列通过注意力权重建立联系。
Timestep Embedding 编码噪声水平,经 MLP 映射到隐藏维度后,可以与文本条件相加、作为独立 token,或用于预测归一化层的缩放和偏移。该条件使同一去噪网络能够在不同噪声尺度下采用相应的恢复函数。
轨迹、关键姿态和可见运动需配合观测 mask 表示其有效区域。零值本身可能是合法坐标,不能同时充当缺失标记。控制目标与预测状态还需转换到一致坐标系后计算几何损失,例如世界位置不能直接与根局部坐标比较。
8.2 条件丢弃与引导
Classifier-free guidance(CFG)通过条件 dropout 训练同一网络的有条件与无条件预测,再在采样时组合二者,以调节条件响应。对噪声预测,一种常用参数化为
其中,$\epsilon_u$ 与 $\epsilon_c$ 分别是网络在相同带噪状态和噪声步骤下,使用空条件与文本条件得到的噪声预测;$w$ 为引导强度。对于预测 clean motion 或速度场的模型,应在相应输出参数化下组织引导。增大 $w$ 可能提高条件响应,也可能降低多样性或放大异常,不存在与所有表示和数据通用的最佳强度。
当 $w>1$ 时,组合对两条预测进行外推,而非在二者之间做凸插值。CFG 调整条件相关方向上的生成偏置,没有把样本投影到接触、骨长或轨迹的可行集合。严格控制仍需要额外的几何目标、受约束参数化或优化步骤。
条件丢弃不等于删除 padding 掩码。无条件分支仍需要有效长度和任务允许的可见范围,否则同时改变了条件语义与序列接口。
8.3 两阶段训练与采样
前述压缩与生成模块通常分两个阶段训练。第一阶段学习动作重建。数据加载器将动作裁剪为有效片段,按训练统计量标准化,并生成长度掩码;编码器与解码器通过重建误差联合更新。VAE 同时加入分布正则,量化模型则更新 codebook 或执行标量量化。
第二阶段固定压缩器,用它把真实动作转换成潜变量或编号。具体而言,Latent Diffusion 为每个样本抽取噪声步骤,构造带噪潜变量,训练条件网络预测相应目标;离散模型则隐藏或右移动作编号,以交叉熵学习编号分布。固定压缩器使这些训练目标保持稳定,生成网络可以专注于条件与运动之间的关系。
训练完成后,推理流程依次经过条件生成、运动解码和几何恢复:条件网络先产生潜变量或编号,运动解码器恢复逐帧特征,再经过反标准化和坐标恢复得到骨架。几何损失若要参与第二阶段训练,还需要让梯度通过解码器回到生成网络;固定解码器参数与切断经过解码器的梯度,是两个不同操作。
9. 几何、接触与物理监督
生成分布需要符合数据,也需要保留表示中的几何关系。训练损失因此可以在标准化特征之外,继续观察恢复后的关节、旋转和接触;这些监督的有效范围由其具体观测量决定。
9.1 从特征损失到几何损失
标准化特征的 MSE 方便训练,但不同通道的几何含义不同。因此,可以增加 FK 后的位置误差、旋转测地误差、逐帧速度误差和骨长约束,使目标与可见运动更接近。
速度监督使用 $\Delta p$ 还是米/秒,需要与帧率一起定义;加速度、jerk 等高阶差分会进一步放大噪声。用于衡量平滑性的阈值不能脱离单位与采样率。
复合表示同时保存位置和旋转时,还可比较直接恢复位置与旋转 FK 位置,约束两个冗余接口的一致性。若只在其中一条路径上计算误差,另一条路径可能仍有较大偏差。
9.2 足部接触与滑步
若 $c_{t,j}=1$ 表示某足部处于接触,可施加
该损失惩罚标注接触阶段的足部位移。它的有效性依赖接触标签:误标会约束空中足部保持静止,漏标则会遗漏支撑阶段的滑动。足部高度、速度及地面几何可共同提供接触证据。
除了接触标签,接触物体的运动状态也决定约束的参照:固定地面上的支撑足与移动物体上的接触足应区别处理。后者需要约束相对接触点速度,不能要求世界速度绝对为零。人体自穿透、环境穿透和人与物体接触还需要对应几何表示与距离计算。
9.3 运动学合法与动力学可行
FK、旋转投影和接触位移损失分别约束骨长、旋转合法性及支撑点运动,属于运动学层面的几何条件。动力学可行性还要求惯性、重力、接触力和关节力矩满足运动方程,并遵守摩擦与驱动能力限制。几何连续性因此是物理执行的必要考虑之一,但不能单独保证动态平衡。
物理执行需要状态、控制和环境动力学。把生成动作交给模拟器或机器人,还涉及形态重定向、关节限位、控制频率和动作跟踪。运动序列模型与控制策略的输入输出应保持区别。
在理想刚性单边接触模型中,间隙 $\phi(q)$ 与法向反作用力 $\lambda_n$ 满足 $0\le\phi(q)\perp\lambda_n\ge0$,切向力满足库仑摩擦锥 $\|\boldsymbol\lambda_{\mathrm{tan}}\|_2\le\mu\lambda_n$。距离损失只观测 $\phi$,无法判定是否存在满足运动方程与执行器限幅的接触力。这一可行性问题将几何生成连接到后续交互与机器人章节中的动力学优化。
10. 生成质量的评价
训练目标说明参数怎样更新,评价协议则说明输出在独立测试中表现如何。人体动作涉及语义、多样性和几何等不同属性,单个指标通常不能同时覆盖它们。
10.1 分布与语义
运动 FID 在固定动作编码器的特征空间中比较真实与生成分布的均值和协方差,可写为
FID 概括动作集合的分布差异。R-Precision 则把生成动作放入文本—动作检索任务,统计正确描述进入前若干候选的比例;matching distance 计算配对文本与动作的特征距离。这两个量侧重语义对应,具体尺度由评估编码器及候选集合决定。
评估器改变时,数值尺度也可能改变;采用不同表示、训练拆分或样本数得到的 FID 不能直接排名。基准结果通常还需要多次采样和相应不确定性统计。
10.2 多样性与多模态性
diversity 通常比较不同动作样本的特征距离;multimodality 则固定同一文字条件,比较多次生成。前者观察总体差异,后者观察同一条件下的多解。
特征差异可能来自合理风格,也可能来自错误姿态或噪声。因此,多样性描述的是样本间的变化幅度,语义匹配和几何质量进一步区分这些变化是否构成合理动作。
10.3 泛化能力与测试分布
测试分布决定了评价所回答的问题。具体而言,新人物检验身体差异,新动作类别检验行为迁移,新的语言组合则检验模型能否将已知部位、方向和顺序重新组合。同一原始片段的裁剪或镜像若同时进入训练与测试,会使结果更多反映对已有运动的记忆。
分布指标与具体错误可以相互补充。例如,总体特征分布接近真实数据时,模型仍可能把“先抬手再转身”生成成相反顺序;几何平滑的行走也可能偏离目标方向。将条件拆成部位、方向、次数与顺序,再结合轨迹和接触观察,就能把总体分数联系到运动中的具体属性。下一章将以单人文本生成展开这些生成目标及其网络实现。
参考资料
Diederik P. Kingma and Max Welling. Auto-Encoding Variational Bayes. In International Conference on Learning Representations, 2014.
Aaron van den Oord, Oriol Vinyals, and Koray Kavukcuoglu. Neural Discrete Representation Learning. In Advances in Neural Information Processing Systems, volume 30, 2017.
Fabian Mentzer, David Minnen, Eirikur Agustsson, and Michael Tschannen. Finite Scalar Quantization: VQ-VAE Made Simple. In International Conference on Learning Representations, 2024.
Mathis Petrovich, Michael J. Black, and Gül Varol. TEMOS: Generating Diverse Human Motions from Textual Descriptions. In Computer Vision – ECCV 2022, 2022.
Xin Chen, Biao Jiang, Wen Liu, Zilong Huang, Bin Fu, Tao Chen, and Gang Yu. Executing Your Commands via Motion Diffusion in Latent Space. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 18000–18010, 2023.
Chuan Guo, Yuxuan Mu, Muhammad Gohar Javed, Sen Wang, and Li Cheng. MoMask: Generative Masked Modeling of 3D Human Motions. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 1900–1910, 2024.
Jonathan Ho, Ajay Jain, and Pieter Abbeel. Denoising Diffusion Probabilistic Models. In Advances in Neural Information Processing Systems, volume 33, pages 6840–6851, 2020.
Guy Tevet, Sigal Raab, Brian Gordon, Yoni Shafir, Daniel Cohen-Or, and Amit Haim Bermano. Human Motion Diffusion Model. In International Conference on Learning Representations, 2023.
Yaron Lipman, Ricky T. Q. Chen, Heli Ben-Hamu, Maximilian Nickel, and Matt Le. Flow Matching for Generative Modeling. In International Conference on Learning Representations, 2023.
Chuan Guo, Shihao Zou, Xinxin Zuo, Sen Wang, Wei Ji, Xingyu Li, and Li Cheng. Generating Diverse and Natural 3D Human Motions from Text. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 5152–5161, 2022.
Mathis Petrovich, Michael J. Black, and Gül Varol. TMR: Text-to-Motion Retrieval Using Contrastive 3D Human Motion Synthesis. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 9488–9497, 2023.
Resources and figure credits
- Numerical examples.
- TEMOS project: qualitative sequences. TEMOS paper: Figure 2. Training branches; losses.
- MLD project: method illustration. Implementation; motion VAE.
- FSQ paper: Figure 1. Implementation.
- MoMask project; motion tokenizer; residual VQ.
- MDM implementation; diffusion targets and geometric losses.
- HumanML3D representation; TMR implementation.