CH-10 人体与场景的交互动作
“走向门旁的椅子并坐下”不仅指定动作类别,还限定了目标对象与执行环境。生成系统需要识别指令所指的椅子,规划能够容纳身体通过的路径,并根据坐面高度与朝向调整落座姿态。一段在空旷空间中合理的动作,放入具体房间后可能穿过家具或失去支撑;运动的可行性因而取决于人体与环境的关系。
人体与场景交互(Human–Scene Interaction,HSI)将环境几何、支撑关系和对象语义纳入运动建模。例如,狭窄通道限制身体包络与转向空间,落座和躺卧则要求指定身体区域与目标表面相容。与搬动物体时联合生成物体轨迹的任务相比,静态场景交互以已知环境为条件,连接目标定位、空间规划与局部动作生成。距离场提供碰撞与接触的几何查询,Language Grounding(将语言指代对应到场景中的对象或区域) 确定目标,Motion Primitive 与 Affordance 则进一步组织长时路径与局部交互;后两种表示将在本章第五、六节定义。
1. 场景条件下的生成分布
将场景几何及对象语义记为 $S$,语言指令记为 $c$,初始人体状态记为 $x_0$;动作序列 $X$ 包含人物在场景共同坐标系中的根运动和身体姿态。物理帧索引为 $t\in\{0,\ldots,T-1\}$,间隔 $\Delta t=1/f$;扩散层级使用 $k\in\{0,\ldots,K\}$,与空间点编号和动作帧均分开。场景条件动作生成表示为
这一条件分布隐含了目标定位、空间规划和动作生成之间的依赖。引入目标变量与路径变量后,可进一步写成结构化分解:
其中 $\mathcal C=(S,c,x_0)$ 汇总生成条件,$g$ 为目标对象或区域,$\mathcal T$ 为路径。三个因子分别描述 Language Grounding、路径规划与条件动作生成;实际网络可以显式划分模块,也可以联合学习这些依赖。路径分布保留文本条件,使接近方向、速度或绕行方式等语言要求能够影响规划。
场景交互与物体交互有交叠。例如,坐在固定椅子上主要涉及人体与静态环境的关系,搬动椅子则还要生成物体状态。两个人抬桌子穿过房间同时包含人–人、人–物和人–场景关系。按交互实体拆开研究有利于分析,但真实任务经常需要多个关系同时成立。
场景观测完整性决定条件变量是否可直接视为已知。完整地图支持确定几何上的规划,在线 RGB-D 则只观察可见表面;此时规划应依赖场景后验或带不确定性的地图。未观测区域既不能直接归为自由空间,也不能由生成先验的高置信度补全自动获得真实性,需要通过新观测更新可行路径与目标判断。
2. 距离场、接触与身体尺度
路径和接触都依赖人体与环境之间的距离,因此首先需要可计算的场景几何接口。Signed Distance Field(SDF,带符号距离场) $\phi_S(p)$ 将空间点映射为到场景表面的距离,并用符号区分内部与外部。这里约定障碍物外部为正、内部为负,表面为零;实现采用相反符号时,损失与阈值也要对应修改。
令人体网格顶点或表面 marker 为 $v_{t,i}$,基于 SDF 的穿透惩罚可定义为
对于已经指定的接触点集合 $\mathcal C$,可进一步鼓励其接近场景表面:
非穿透损失约束所有参与查询的身体点不得进入障碍内部,接触损失则要求已经指定的身体部位接近目标表面。无穿透的悬空人体仍可能违反支撑条件,而与错误椅子接触的人体仍可能违反语言目标。因此,几何约束与目标语义应作为独立条件共同参与建模。
逐个网格顶点检查适合精细接触,导航还常需要计算成本较低的人体几何近似。把人体近似为圆柱或胶囊后,可以通过扩张障碍物求可通行区域。例如,取 $y$ 为竖直轴,将障碍投影到水平面,并构造二维距离场 $\phi_{\mathrm{nav}}(x,z)$;若身体在该平面的圆形包络半径为 $r$,则 $\phi_{\mathrm{nav}}(x,z)-r$ 给出根位置的水平安全裕量。这里的障碍集合不包含支撑地面,地面高度与足部支撑另行检查。这个代理把身体体积纳入路径检查,但抬起的手、侧身的肩膀和弯曲的膝盖仍可能超出固定包络。
扫描场景也不一定形成封闭的实体。薄板、缺失表面和重建孔洞会让距离场的“内部”定义不稳定;离散网格插值则可能漏掉狭窄障碍。实际接触处应结合原始网格、表面法线和足够密集的人体点检查,不能仅依赖一个低分辨率距离场值。
2.1 SDF 梯度与几何误差反传
精确欧氏 SDF 在光滑表面附近、最近点唯一且函数可微的区域满足 Eikonal 条件 $\|\nabla\phi_S(p)\|_2=1$。其梯度等于最近表面的外法线方向;表面点上即为单位法向量。medial axis、棱角及最近点不唯一处可能不可微,不能在这些位置假设存在唯一平滑法向。
人体表面由配置 $q_t$ 决定,写成 $v_{t,i}=F_i(q_t)$。令 $J_i=\partial F_i/\partial q$ 为位置对局部配置坐标的 Jacobian,在 $\phi_S(v_{t,i})<0$ 的穿透区域,链式法则给出
SDF 梯度给出世界坐标中的表面法向,$J_i^\top$ 将这一方向映射到根位姿与关节配置的局部变化。梯度下降沿负梯度修正穿透点;旋转变量经过 Retraction(将局部增量映回配置流形的运算) 或合法的旋转参数化更新后,仍需保持在旋转群上。网络以位置或旋转通道输出动作时,这条计算链把几何残差连接到可训练参数或采样引导,避免将穿透误差仅作为渲染后的统计量。
离散插值与神经近似场通常不严格满足单位梯度条件。若 $\|\nabla\phi_S\|$ 偏离一,相同距离残差会产生不同尺度的更新;梯度方向错误还可能将人体推向错误表面。Eikonal 正则约束梯度模长,但不足以独立确定正确表面和法向,仍需边界或距离监督。低分辨率距离场因此可以作为快速引导,精细接触应结合原始几何和可靠法向复核。
除了接触位置,法向还约束接触姿态:脚底接近地面时,其朝向仍可能倒置;背部接近墙面时,也未必形成预期支撑。距离、身体表面方向与接触部位共同定义局部几何,而支撑力是否可行还需要第十一章的接触动力学。
整场景距离场通常只保留最近表面距离,不保留对象身份。目标椅子紧邻桌子时,针对整场景的接触损失可能将人体吸引到非目标表面。对象专属距离场或实例索引用于指定接触对象,整场景距离场用于无碰撞约束;两者的几何查询范围应明确区分。
3. 场景约束对人体恢复的作用
场景几何可以为三维人体恢复提供观测以外的约束。单目图像存在深度与遮挡歧义,坐姿人物的腿部和骨盆尤其容易被家具遮挡。仅依赖二维重投影误差时,多种三维姿态都可能解释同一图像,其中部分解会穿过地面或家具。
PROX 将接触与非穿透项纳入 SMPL-X 拟合,以场景约束缩小逆问题的解空间。令 $E(q)$ 表示这些损失构成的总能量,最优人体配置为
其中,图像项要求估计人体的二维投影与观测一致,人体先验约束姿态和形态,场景项通过非穿透与指定接触排除部分不合理的三维解。表面几何通过可微人体模型把残差传到配置参数,而非直接增加新的图像观测。因此,场景可以改善可辨识性,却不能保证遮挡关节具有唯一真值;由拟合构成的数据仍保留观测与先验共同造成的偏差。
人体恢复与动作生成共享场景几何接口,但推断方向不同:恢复任务根据图像与场景估计已发生的运动,生成任务根据场景与目标构造新的运动。共同坐标系、实际尺度及接触部位是两类任务计算几何损失的前提。
由恢复结果构成的数据还要区分真实测量与拟合标签。经过场景优化的人体参数可能更合理,却仍受到传感器噪声、遮挡和模型形状的影响。把所有拟合结果当成无误差的接触真值,会使生成器继承其中的偏差。训练时可以使用置信度、质量筛选与独立接触校验,减少异常样本的影响。
大场景常采用人体附近的局部裁剪来降低点云规模。裁剪中心如果随人体变化,生成结果需要变换回共同世界坐标,目标点与场景点也必须使用相同变换。不同窗口的局部坐标接缝错误,会表现为根轨迹跳变或目标漂移。记录窗口原点、朝向和尺度,能够让局部感知与全局规划保持一致。
4. 语言定位与场景动作配对
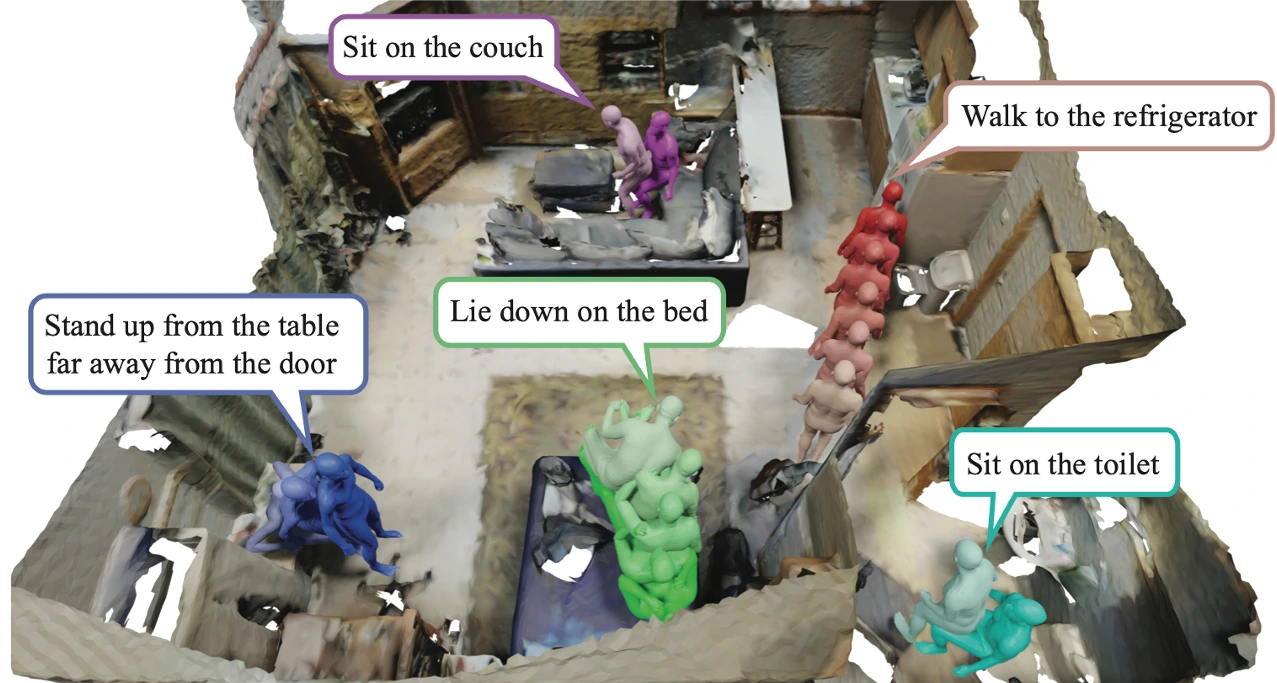
几何条件能约束人体的位置,要学习语言驱动生成,还需要把场景、目标描述与完整动作配成训练样本。HUMANISE 将已有动作与三维室内场景对齐,并提供描述目标对象及空间关系的语言。其主要动作类型包括行走、坐下、站起与躺下,将动作类别、目标对象与空间指代共同纳入生成条件。
配对过程本质上是在场景内求满足动作接触结构的空间配准。例如,坐姿末端与椅子中心重合只约束少量平移自由度,坐面高度、身体朝向、足部支撑与整个接近过程的无碰撞性仍是独立条件。几何筛选决定新增样本是否保留原动作的约束结构,也决定训练分布中是否混入不相容的场景—动作组合。
对齐生成的数据与现场捕捉存在分布差异。真人会根据局部障碍调整身体,而一个原先在空旷空间记录的动作,即使终点适合椅子,接近阶段也可能缺少必要的避让。因此,数据对齐适合提供结构化监督,却不能替代所有真实场景中的行为变化。
4.1 场景与语言的条件融合
首先,数据处理对场景和人体采用同一个坐标变换,采样场景点,并把可变长度动作通过 padding 对齐为固定窗口;padding mask 使补齐帧不参与动作编码和重构。根朝向转换为六维旋转,身体关节保留轴角参数,根平移、根朝向和身体姿态组成每帧的动作向量。
完成坐标统一与时间窗口整理后,可变点数的场景与可变长度的文本映射到共同特征宽度。Point Transformer 将点云编码为 512 维 scene token,BERT 的 768 维 token embedding 经线性层投影到相同宽度。两类 token 拼接为 $[B,N_s+N_l,512]$ 后进行注意力融合,其中 $N_s$、$N_l$ 分别为场景与语言 token 数。场景 token 与对应坐标聚合为场景向量,语言分支使用首个 token 的特征;二者结合人体形状参数,得到 512 维条件 $C$。辅助回归头由 $C$ 预测目标对象中心,使 Language Grounding 获得显式空间监督。
4.2 Conditional VAE 与逐帧时间查询
在这一条件编码基础上,训练动作组成 $[B,T,d_x]$ 张量,其中 $d_x$ 为每帧运动特征维度;动作经双向 GRU 编码,序列特征与 $C$ 拼接后预测 32 维 latent variable 的均值和 log-variance。通过重参数化进行可微采样:
解码器将 $[z,C]$ 映射为一个 512 维 memory token。带 temporal positional encoding 的 $T$ 个 query 经两层、八头 Transformer decoder 读取该条件,再预测逐帧动作。
上述编码与解码构成 Conditional Variational Autoencoder(Conditional VAE,条件变分自编码器)。用场景与语言特征构成条件 $C$,训练后验 $q_\psi(z\mid X,C)$ 与解码器 $p_\theta(X\mid z,C)$:前者在训练时读取真实动作,后者根据条件与 latent variable 恢复运动。一个通用目标为
实际监督由四类重构量与定位量组成:根平移、根旋转、身体姿态的 $L_1$ 误差,人体表面标记点的 $L_1$ 误差,以及目标中心的平方误差;KL 项把动作后验约束在标准正态先验附近。表面标记点使参数误差与身体形状联系起来,目标中心监督使条件编码保留语言所指的位置。
推理从标准正态先验采样 $z$,以场景—语言条件和带物理帧位置编码的 queries 恢复运动。所有帧共享同一全局 latent variable,使同条件多解在整段序列上协调;重构项过强而 KL 约束不足时,训练后验可能偏离采样先验,KL 过强则可能使解码器忽略 latent variable,出现 posterior collapse(后验塌缩)。目标定位监督使不同采样仍以指令所指的对象为条件;latent variable 提供运动变化,Language Grounding 监督则约束这些变化发生在哪里。
语言定位还需要分清几何近邻与语义关系。“门旁的椅子”不一定是距离人体最近的椅子;“桌子后面的椅子”中的“后面”还可能采用观察者视角或桌子自身方向。训练标注应说明参考系,测试时也要区分单一候选与多个相似候选对象。
描述同一目标时,还可能存在多个等价路径。例如,人物可以从桌子的左侧或右侧接近椅子,坐下时也可能先转身或侧步。这些路径都可能到达目标并避开障碍,偏离某一条参考路径不必然意味着任务失败。若指令明确要求“从桌子左边绕过去”,路径方向就成为受控条件,生成分布相应收缩到满足该方向的运动。
5. Motion Primitive 与长时序策略
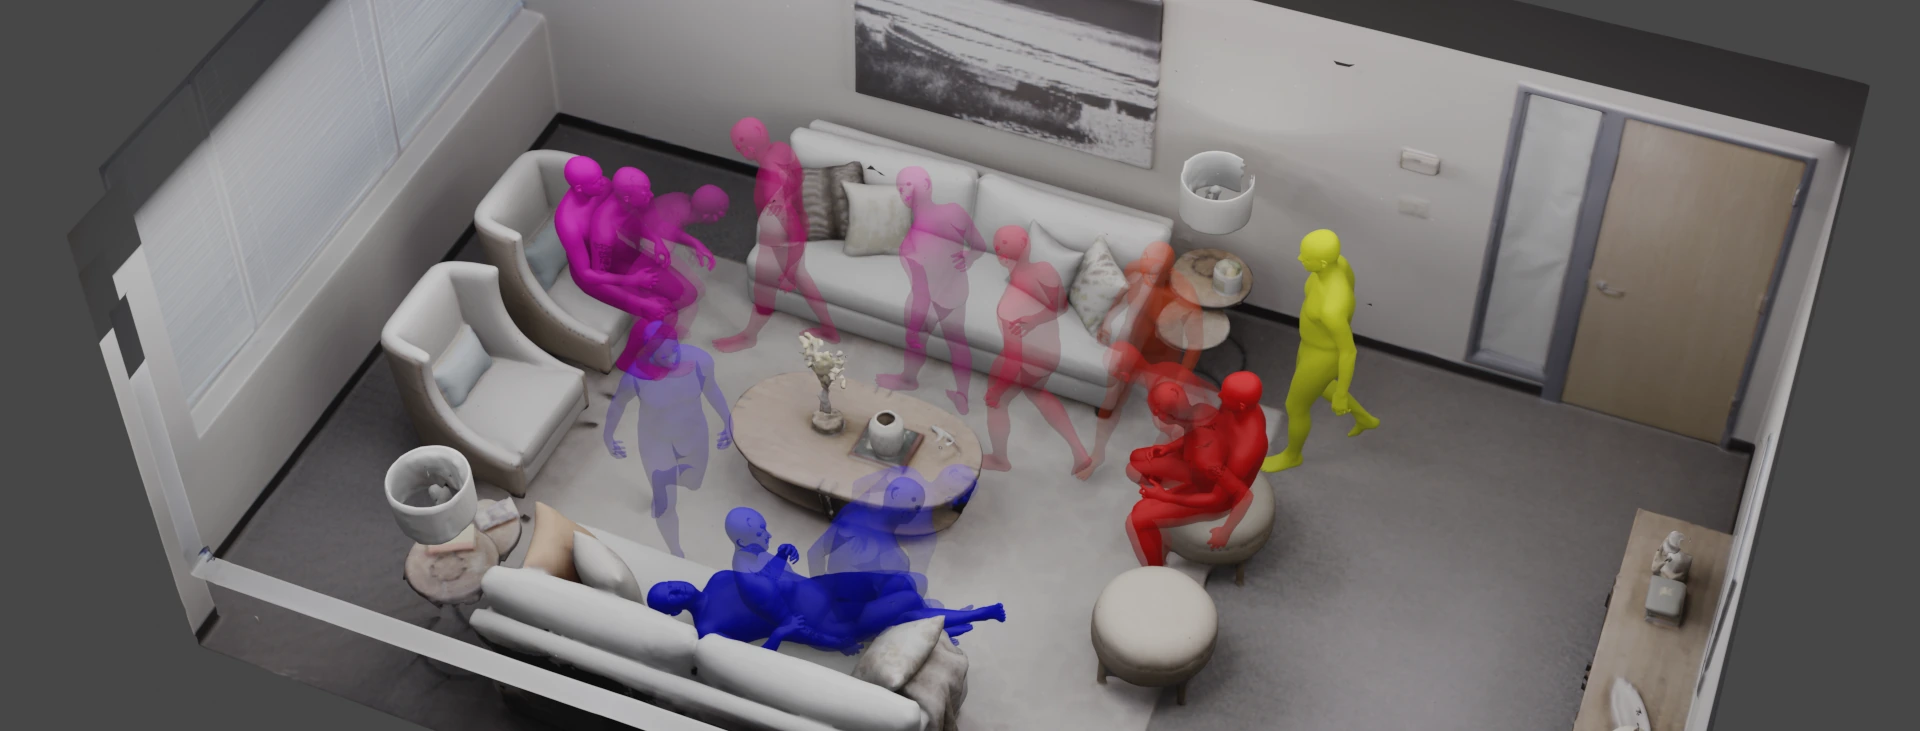
在同一房间连续完成行走、落座与躺卧,既要求局部接触动作自然,也要求后续运动根据当前位置和目标继续调整。长时任务规划与短时姿态变化因而需要不同粒度的决策。Motion Primitive(运动原语)将短时动作编码为可组合的生成单元,长序列通过滚动选择 Motion Primitive 构建。DIMOS 在已学习的 primitive latent space 中训练场景感知策略,根据当前人体状态、局部环境和目标选择下一段运动,并衔接导航与落座等交互阶段。
下图展示多个 primitive 的连续组织:人体先接近并坐上凳子,再转向另一把椅子,最后走向沙发并躺下。不同交互阶段共享场景坐标,前一阶段的终止状态成为后一阶段的初始条件。
用 $\ell$ 标识 Motion Primitive 的决策次数,令该次决策对应的物理起始帧为 $t_\ell$,当前人体状态为 $\xi_\ell$,局部场景特征为 $f_S(\xi_\ell)$。策略选择 latent action:
其中 $G_\varphi$ 是已训练的局部动作生成器,$g$ 是当前目标。时间区间采用左闭右开约定,$H$ 为输出 Motion Primitive 的帧数;实际执行或提交 $h\leq H$ 帧后,可在 $t_{\ell+1}=t_\ell+h$ 重新决策。决策轴 $\ell$、物理帧轴 $t$ 与生成采样轴承担不同作用。DIMOS 的动作空间为生成器 latent space,奖励通过目标到达、避障与交互质量选择运动学片段;这种策略并不直接求解关节力矩或接触反作用力。
导航网格为全局路径提供可通行路点,局部策略再决定如何运动。两者有不同的空间分辨率:全局规划可以避开大件家具,局部身体仍可能在拐角处碰撞。路径搜索结果需要与人体尺寸、可转向范围和动作原语的运动距离相匹配。
DIMOS 的 locomotion policy 将身体 marker 历史与指向目标的方向特征送入 GRU,局部可通行地图经 MLP 编码后与时序特征拼接。Actor 输出 primitive latent action 的分布,critic 估计状态价值;两者共享输入表征,使路径目标与局部避障共同影响 primitive 选择。
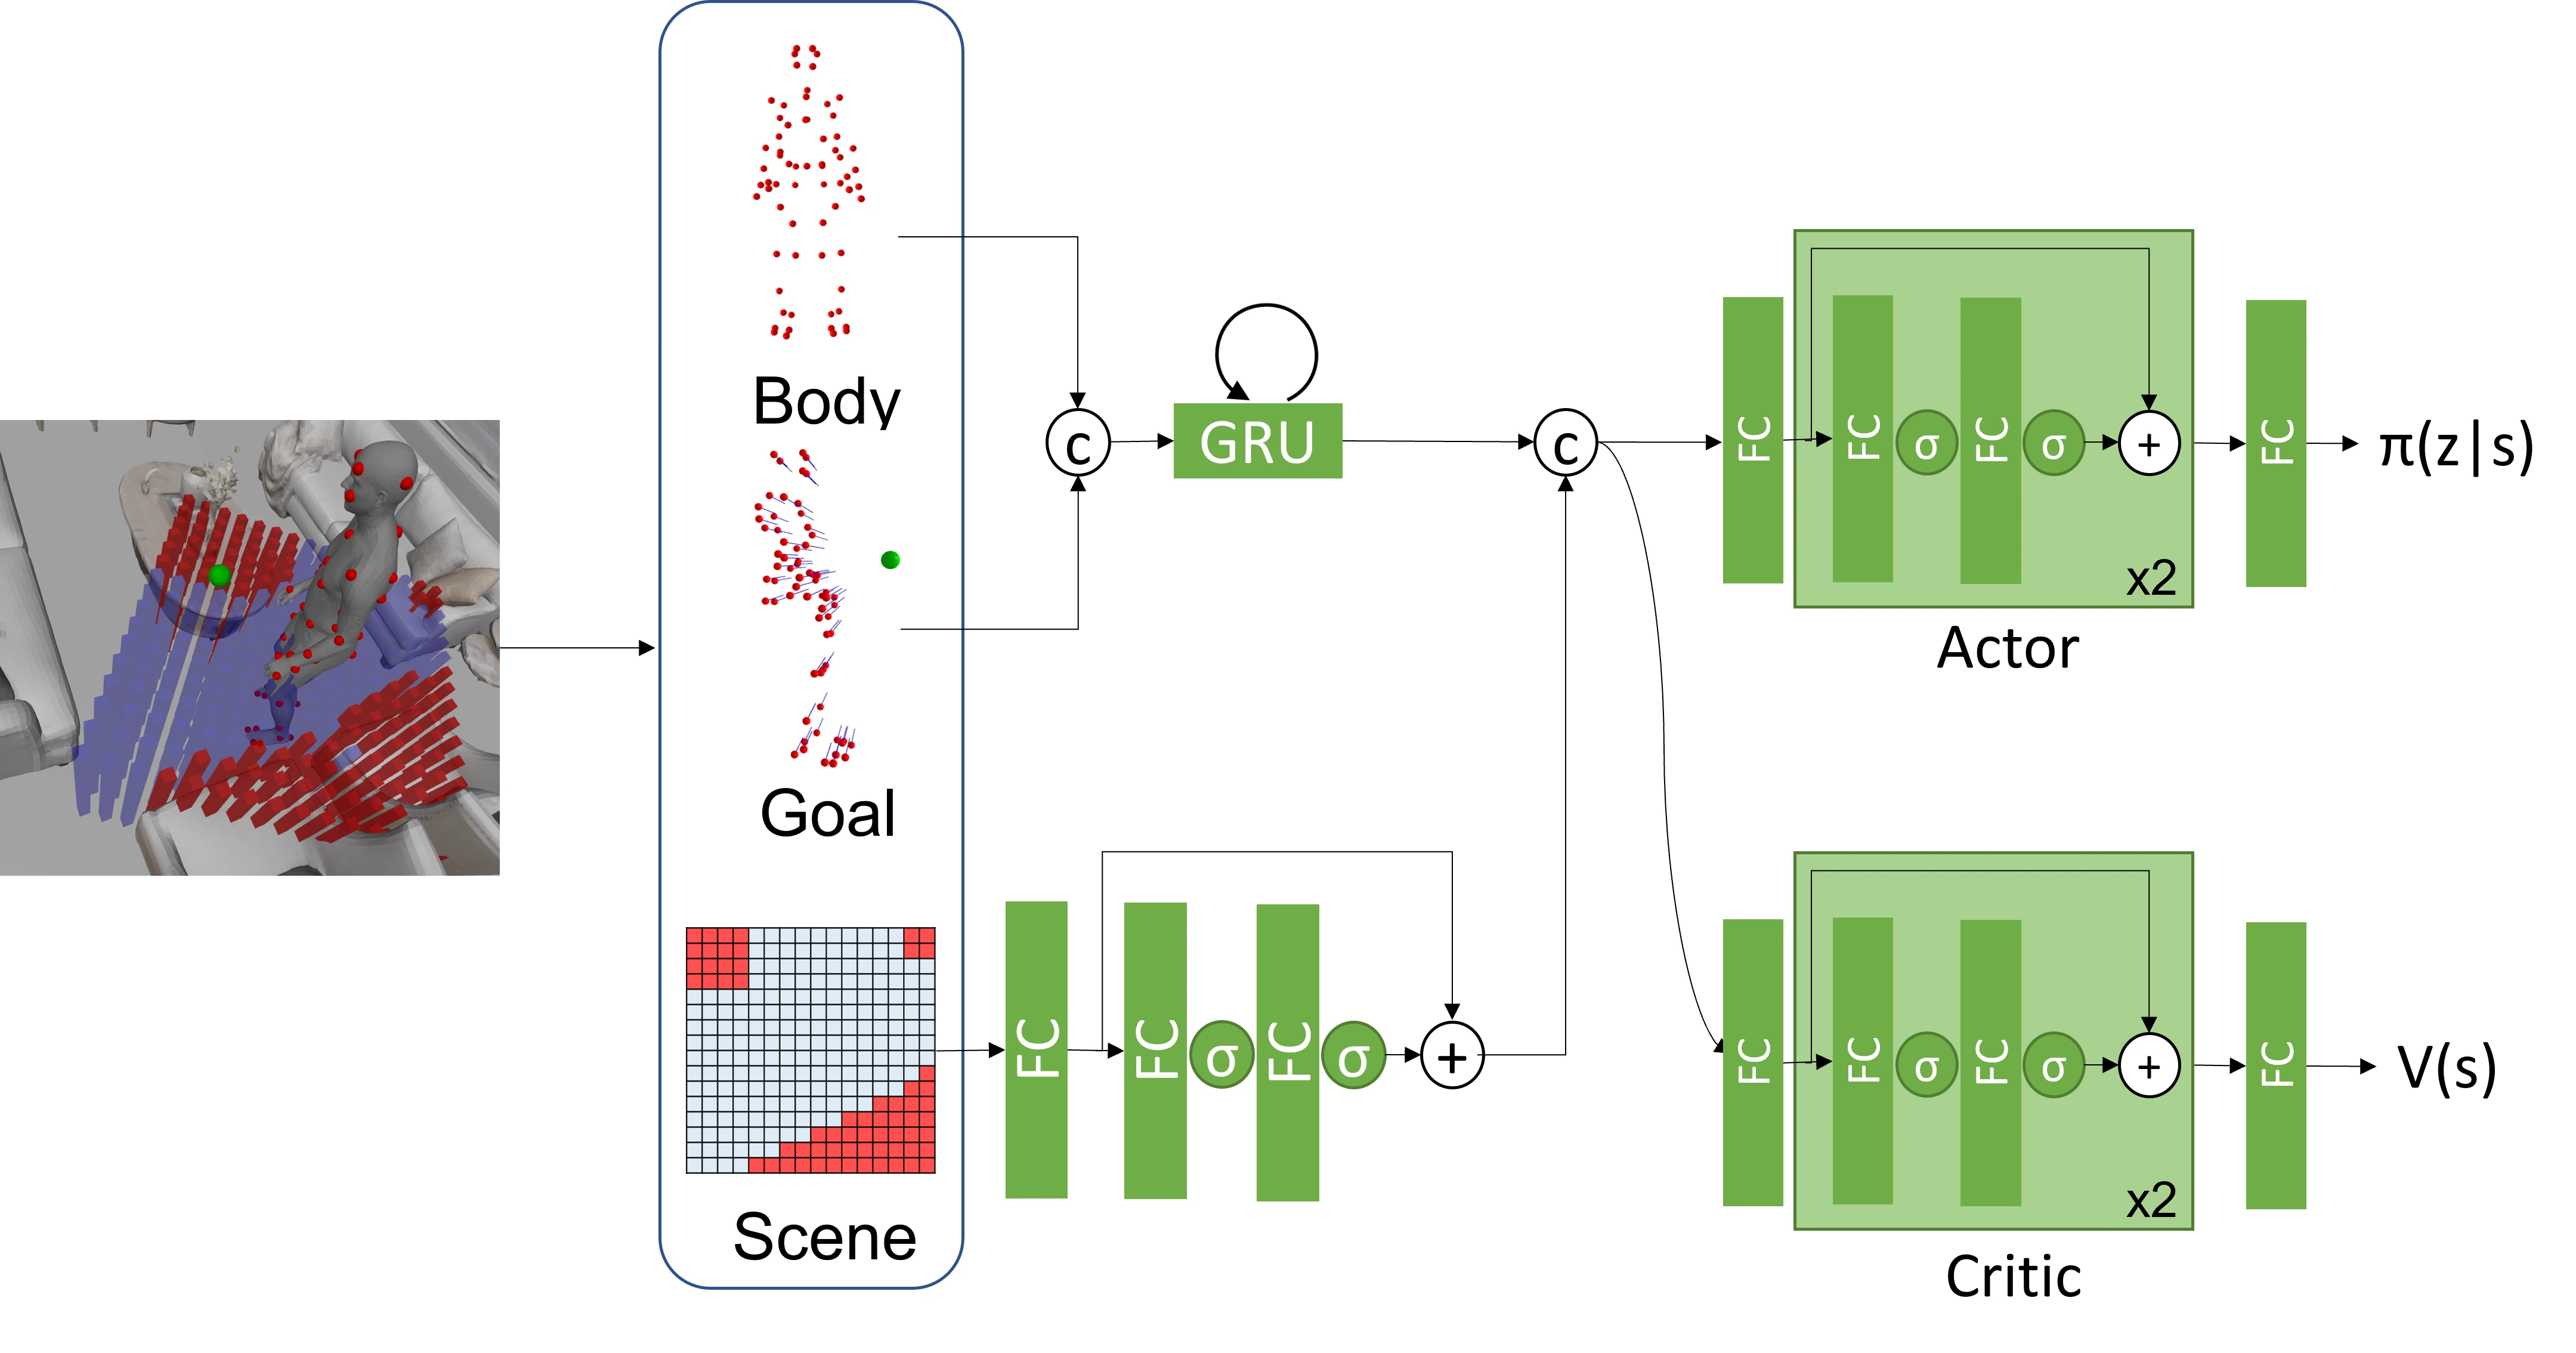
DIMOS 将 AMASS、BABEL 与 SAMP 中的运动整理为局部 Motion Primitive,分别学习行走、坐下和躺下的 marker predictor。训练先监督单个片段,再将连续多个片段展开进行 rollout training,使生成器适应自身输出作为下一片段初始条件的情况。导航策略和交互策略随后在这些生成器的 latent space 中选择动作;几何到达、穿透和足部接触等奖励提供目标导向监督。
导航策略使用局部可通行地图,交互策略则增加身体 marker 到物体表面的 SDF 值与梯度,以及 marker 到目标姿态的距离和方向。前者关注如何接近对象,后者关注身体各部位如何与目标表面对应。策略选择局部运动的组合,固定的生成先验提供运动候选;候选动作的范围仍受训练数据中的支撑方式和运动类型限制。
滚动生成会将当前片段的误差传入下一次决策。因此,后续策略必须读取实际生成状态,持续修正根位置和朝向偏差;始终使用理想参考初始化片段,会使规划过程失去状态反馈。
导航与落座的切换条件需要表达接近方向。例如,只用根位置到椅子中心的距离作为终止信号,会让人物可能从椅背一侧进入落座阶段。更完整的切换检查可以包含目标表面、朝向、相对速度以及足够的转身空间。人体体型改变后,这些量也会变化:同一椅子对不同腿长可能需要不同终点和膝关节范围,不能只把原动作整体平移过去。
6. Affordance 连接目标定位与动作生成
路径规划确定接近过程,局部交互还需要指定人体与环境的对应区域。Affordance(可供性)描述环境支持某种行为的条件,例如坐面支持落座、空旷地面支持行走。它与动作类型、人体尺度和当前占用状态有关,可作为对象语义与局部几何约束之间的中间表示。
AffordMotion 采用一种可从动作数据计算的 Affordance 表示,记录场景中哪些区域接近哪些人体关节。场景点 $u_i$ 与动作关节 $p_{t,j}$ 构成距离,再经过随距离下降的函数 $\rho$ 与时间聚合,得到
该表示对时间置换不变。若 $P$ 为任意帧置换,则 $A(PX)=A(X)$,因此聚合映射非单射:同一个空间访问图对应多个时序轨迹。例如,坐下与站起可能具有相近的访问集合,却拥有相反的阶段顺序。Affordance 在此压缩的是空间交互支持集,时序方向和接触先后仍须由语言、历史状态及运动生成器提供,不能从聚合图唯一恢复。
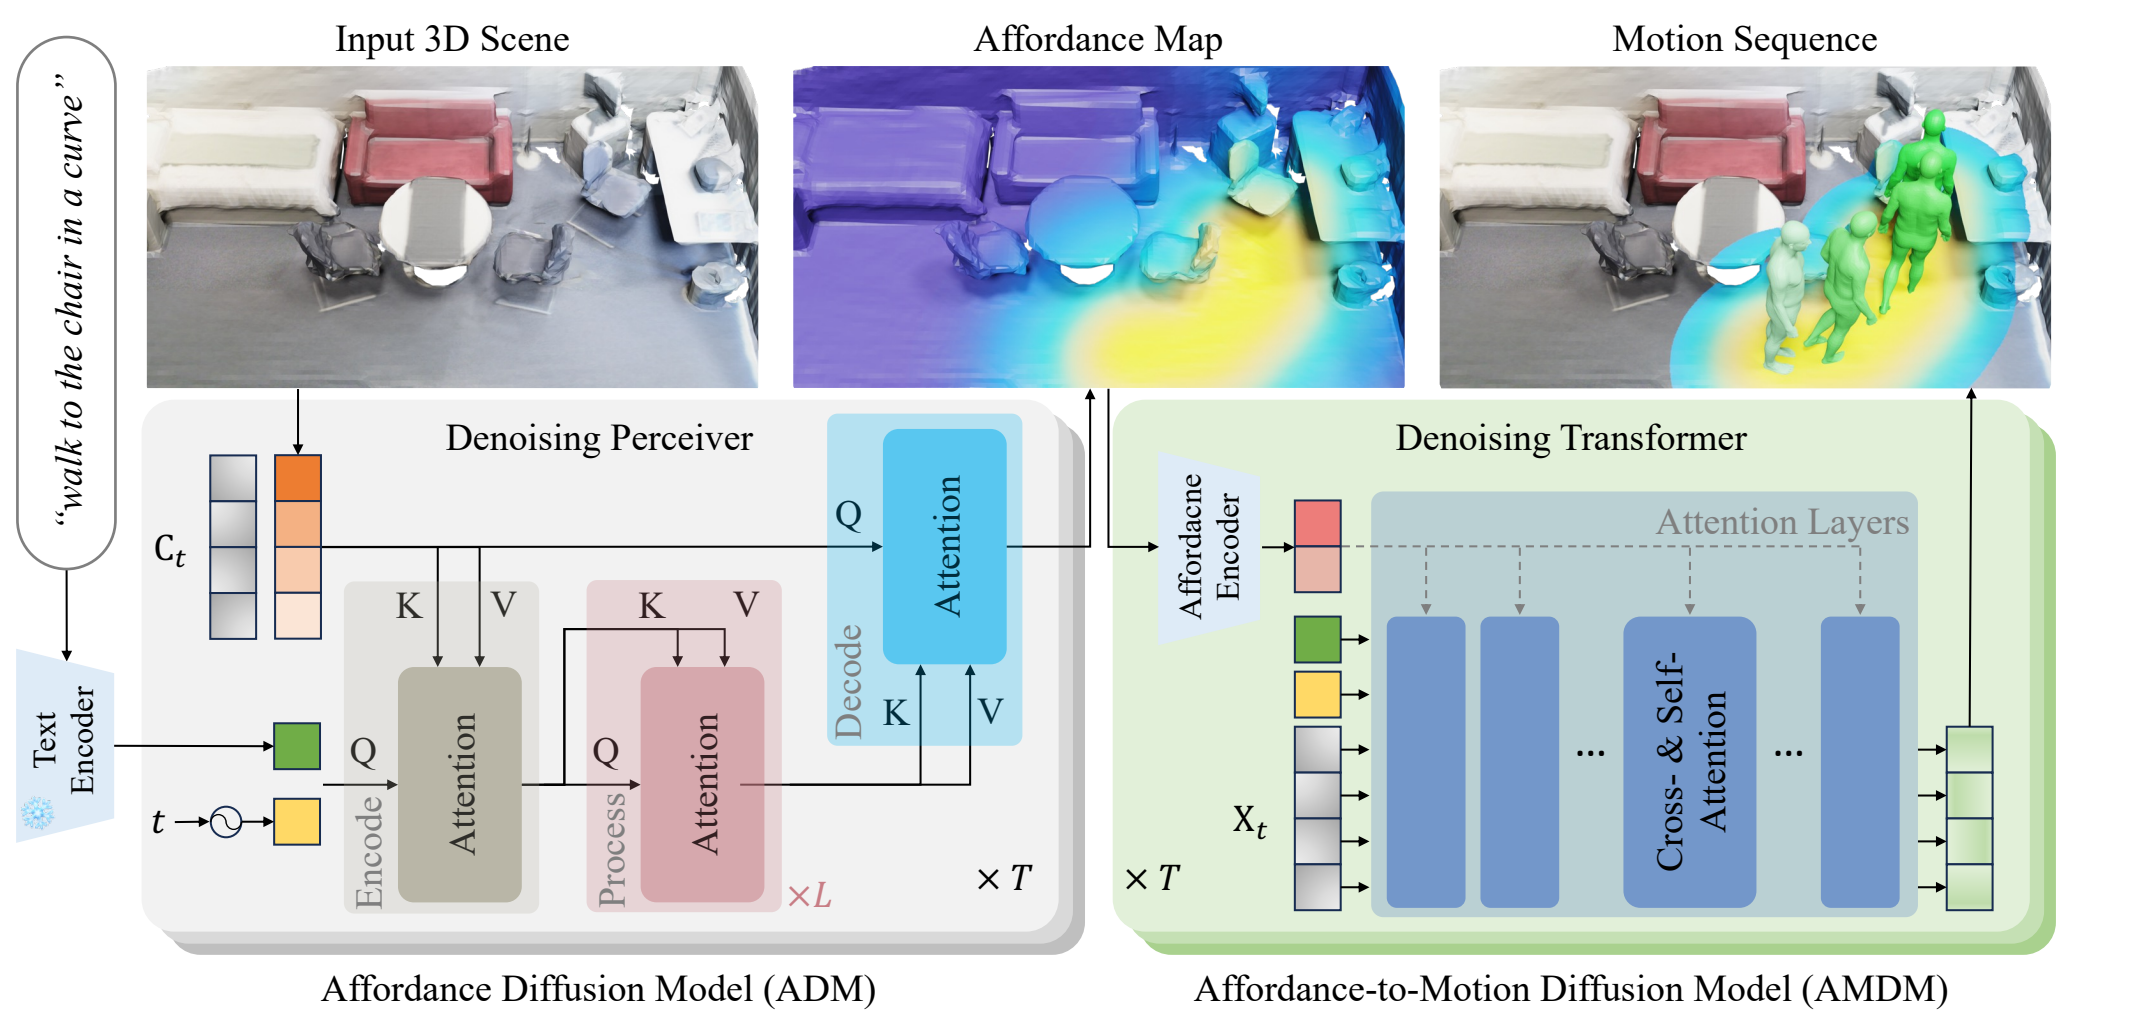
基于这一中间监督,两阶段模型分别学习交互区域分布与条件动作分布。第一阶段 Affordance Diffusion Model(ADM) 根据语言和场景生成 Affordance Map;第二阶段 Affordance-to-Motion Diffusion Model(AMDM) 根据文字、场景与预测图生成运动。语言目标由此与关节附近的空间区域联系起来,动作生成器获得比一个全局场景向量更明确的几何条件。
6.1 Affordance Map 与动作的张量接口
预处理在人体轨迹附近裁剪场景,采样 8192 个点,并计算每个场景点到二十二个关节轨迹的最近距离。以连续距离表示关节–场景关系的配置,选择骨盆、双脚、颈部和双手六个关节通道,得到 $A\in\mathbb{R}^{B\times N\times6}$,其中 $B$ 为 batch size,$N$ 为场景采样点数。关节位置生成配置将动作展平为 $[B,T,66]$,保留二十二个关节的三维运动。
ADM 中,带噪图、每点三十二维场景特征、CLIP 文本向量与一百二十八维 diffusion-step Embedding 按点拼接。点级 MLP 先提取局部特征,再将全场景均值送回每个点,使局部位置与全局上下文同时进入图预测。最后的线性层恢复六个关节通道。
AMDM 将场景坐标与 Affordance Map 编码为 spatial token,投影到 512 维;带噪动作也映射到同一宽度。diffusion-step token、text token、spatial token 与 motion token 拼接为 $[B,2+N_g+T,512]$,其中 $N_g$ 为空间 token 数,再经过位置编码和五层、八头 Transformer。padding mask 屏蔽补齐动作,输出保留对应动作帧的 token,再映射回六十六维关节位置。
6.2 分期训练与级联采样
两个扩散网络分别训练。将 ADM 对无噪声图的预测记为 $\hat A^{(0)}$,将 AMDM 对 clean motion 的预测记为 $\hat X^{(0)}$,各自的条件输入为
在有效场景点与有效动作帧上,两者分别最小化均方误差:
上标 $(0)$ 表示完整图或完整动作序列的零噪声状态,而非第零个物理帧。训练 AMDM 时,真实运动导出的 $A^{(0)}$ 提供空间条件;推理先由 ADM 的扩散链获得 $\hat A^{(0)}$,再启动 AMDM 的另一条扩散链。两条链分别细化空间交互分布和全部 $T$ 帧动作,生成链的步数不会直接增加动作持续时间。
级联生成存在条件分布偏移:AMDM 训练时接收由真实动作计算的 Affordance Map,推理时接收 ADM 预测的 Affordance Map。前级定位误差因此可能传递到关节轨迹,第二阶段对空间偏移的鲁棒性决定级联系统的稳定性。
区域正确也不意味着姿态正确。人在洗手池附近执行洗手动作,却背对水龙头,能够产生合理的接近区域,同时违背操作要求。局部表面朝向、身体方向、目标部位与动作阶段应与区域信息结合评价。
Affordance 随环境状态变化。桌面占用会改变放置区域,人体尺寸变化会改变落座的可达范围。仅编码静态点云的表示无法完整表达未知占用、物体可移动性与支撑能力;动态场景需要将对象状态和感知不确定性共同纳入定位与规划。
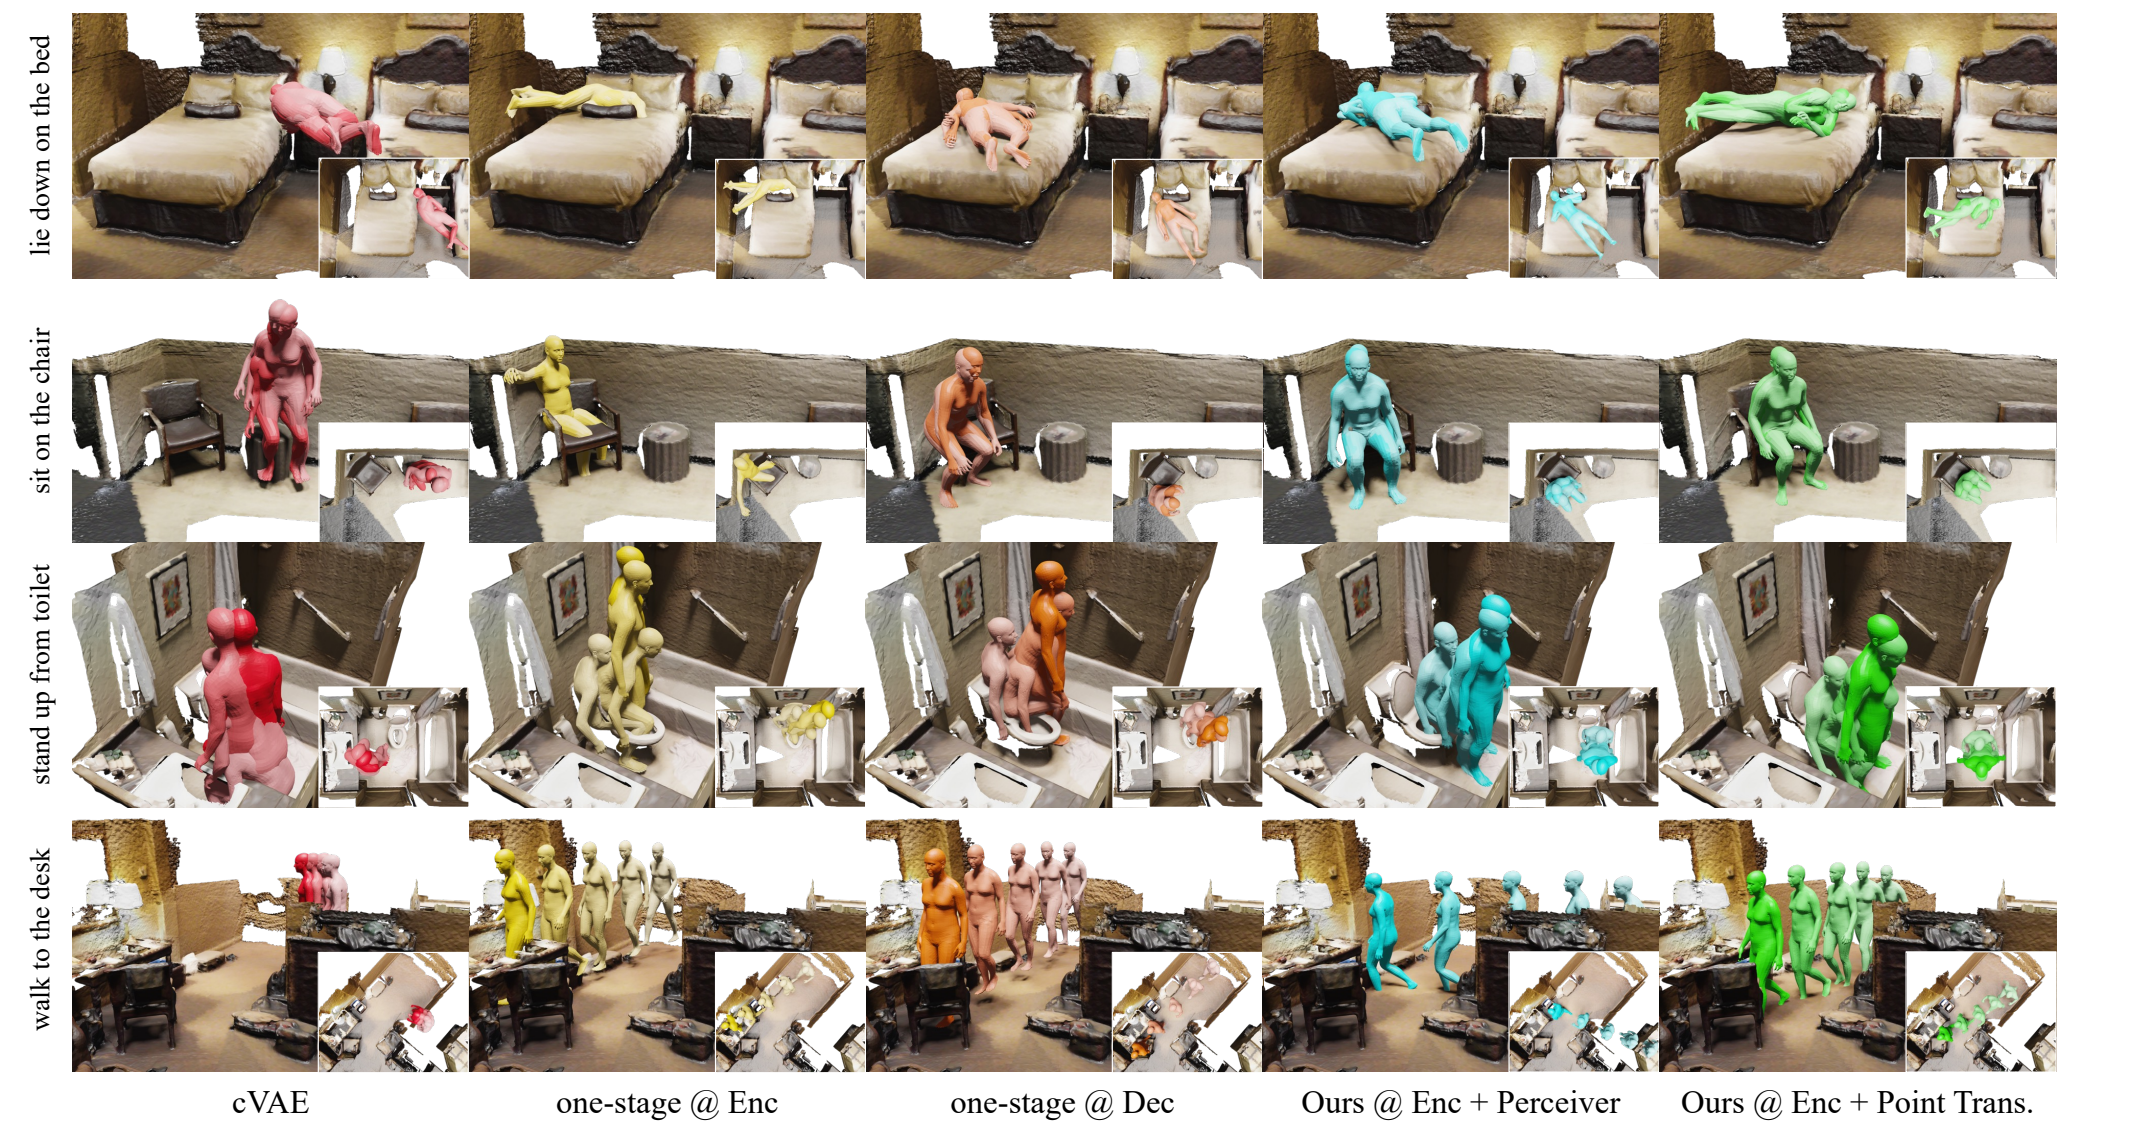
下面的生成结果展示语义目标、身体姿态与场景位置之间的对应。侧视图主要反映身体高度和接触姿态,俯视图补充目标对象、路径及朝向;联合观察两种视角有助于定位动作类别、空间定位与局部接触中的不同误差。
7. 算例:点路径与身体碰撞包络
将人体水平占据范围近似为固定半径的圆盘后,可以把身体碰撞检查转为根位置的点碰撞检查:障碍物按身体半径向外扩张,形成障碍集合与圆盘的 Minkowski Sum(两个集合中所有点两两相加形成的集合)。对半径 $r=0.2$ 米的代理,根路径的可行条件为 $\phi_{\mathrm{nav}}(p)-r\geq0$。矩形障碍算例比较直线路径与指定绕行路径,分离路径长度和几何可行性这两个目标。
1 | import numpy as np |
运行结果:
1 | straight: 最小身体裕量=-0.600 m, 路径长度=4.000 m |
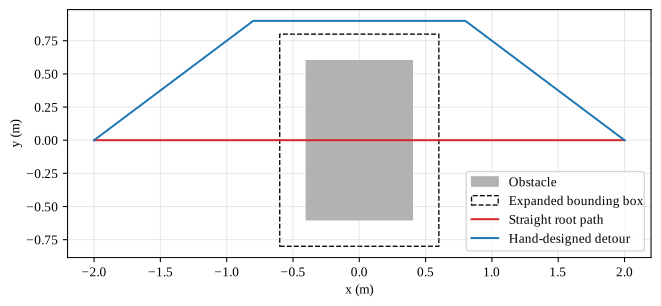
绕行增加路径长度,但将最小身体裕量从负值变为正值。精确圆盘膨胀在矩形拐角处形成圆弧,图中的扩张包围盒则是保守近似。该结果说明路径规划必须发生在考虑身体体积后的自由配置集合中;关节化人体的包络随姿态变化,单一根位置距离仍只是高维碰撞约束的低维近似。
8. 算例:时间聚合保留区域而丢失顺序
时间最大聚合将轨迹映射到访问区域的等价类。对一维关节轨迹及其时间反转,空间样本集合完全相同;使用高斯距离核后,每个场景点的最大响应因而不变。该低维算例直接检验聚合映射的不可逆性,而不依赖网络容量或训练误差。
1 | import numpy as np |
运行结果:
1 | 场景点数: 121 |
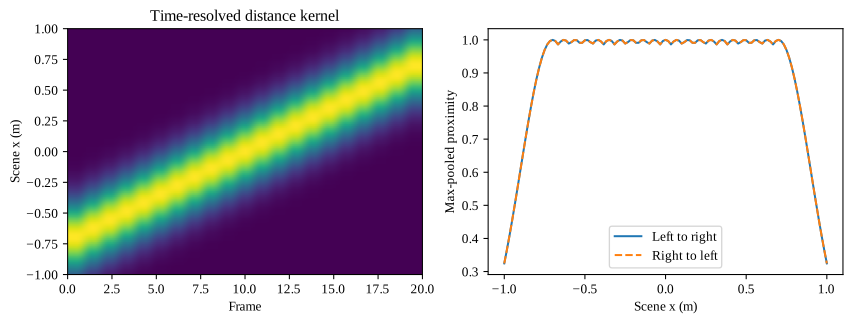
两条起点相差 $1.4$ 米的轨迹得到逐点相同的聚合图,构成非单射性的直接反例。任何仅接收该图的确定性解码器都无法唯一判断原始方向;文本或历史条件可以选择兼容轨迹,却不能使已丢失的顺序自动重现。这个差异来自表示中删除了时间顺序;它说明聚合图缺少哪些信息,而非真实运动过程失去了因果关系。对先绕行再落座等组合任务,应额外评价阶段顺序与持续时间。
9. 场景任务的分层评价
场景条件动作生成的误差,可以分别从目标定位、导航路径和局部身体交互三个环节检查。目标对象准确率衡量指令是否落在正确椅子上;路径碰撞与长度衡量接近过程;终点、身体朝向、坐面接触和网格穿透衡量落座过程。定位正确而身体背对目标,与运动自然但坐错对象,分别要求修正空间条件与语义定位。
点云与网格提供不同精度的几何接口。最近点距离受点云密度影响,网格距离更适合检查接触附近的细小间隙;SDF 适合高效检测穿透,但薄板和缺失表面会影响内外定义。评价采用的表面、采样密度与符号约定,应与所描述的接触关系一致。
场景观测也决定规划条件。完整扫描可以提供确定的障碍集合,局部感知中的空缺则可能来自自由空间或遮挡。将未知区域纳入状态表示,并在必要时继续观察,能够避免把“没有测到障碍”等同于“可以通过”。
AffordMotion 的部分结果呈现交互区域正确但身体朝向不符的误差,反映了空间接近关系与完整交互状态之间的差异。除目标区域外,评价还应保留朝向、阶段和持续时间,并覆盖未知布局、相似对象与组合指令。
参考资料
Mohamed Hassan, Vasileios Choutas, Dimitrios Tzionas, and Michael J. Black. Resolving 3D Human Pose Ambiguities with 3D Scene Constraints. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 2282–2292, 2019.
Zan Wang, Yixin Chen, Tengyu Liu, Yixin Zhu, Wei Liang, and Siyuan Huang. HUMANISE: Language-conditioned Human Motion Generation in 3D Scenes. In Advances in Neural Information Processing Systems, 2022.
Kaifeng Zhao, Yan Zhang, Shaofei Wang, Thabo Beeler, and Siyu Tang. Synthesizing Diverse Human Motions in 3D Indoor Scenes. In Proceedings of the IEEE/CVF International Conference on Computer Vision, 2023.
Zan Wang, Yixin Chen, Baoxiong Jia, Puhao Li, Jinlu Zhang, Jingze Zhang, Tengyu Liu, Yixin Zhu, Wei Liang, and Siyuan Huang. Move as You Say, Interact as You Can: Language-guided Human Motion Generation with Scene Affordance. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2024.
Resources and figure credits
- Numerical examples.
- HUMANISE condition encoder and VAE; reconstruction and grounding objectives.
- AffordMotion ADM; AMDM; diffusion configuration.
- HUMANISE examples: official repository.
- DIMOS sequence and locomotion policy: official project; training implementation.
- AffordMotion pipeline and HUMANISE comparison: paper, Figures 2 and 3.