CH-08 文本驱动的多人交互动作生成
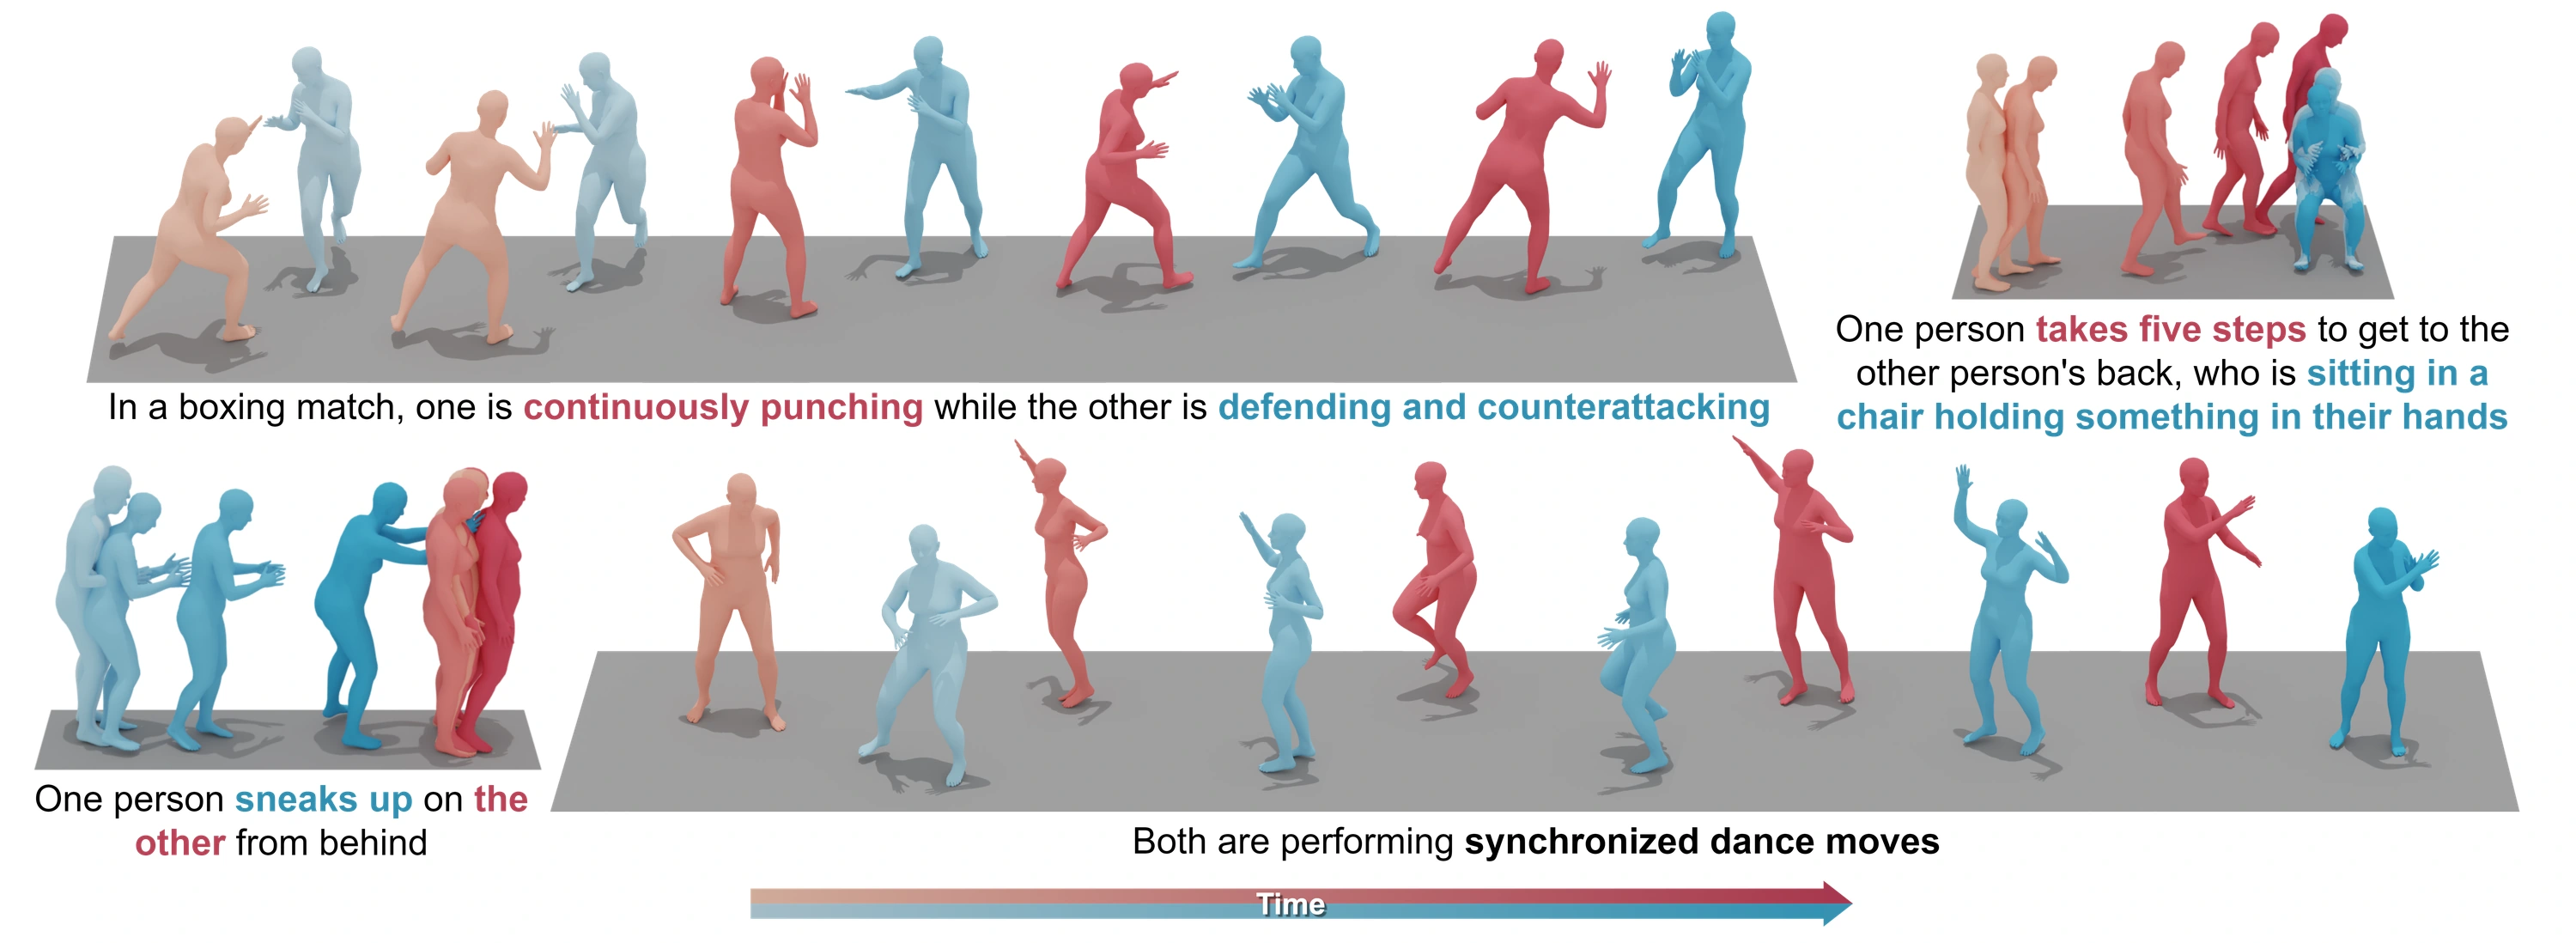
两段自然的单人运动并置,并不必然构成一次有效交互。例如,握手要求双方手部轨迹在同一时刻接近,递交要求交付与接收行为相互配合,拳击对练则要求防守响应与攻击过程协调。这些条件取决于双方的相对位置和事件关系,不能由任一人的局部动作单独确定;独立采样即使保持了单人运动质量,也可能产生接触错位或响应时机不一致。
多人交互动作生成(human-human interaction generation)因此建模多个主体的运动联合分布,以及主体之间随时间变化的空间、接触和行为关系。自然语言可以指定角色与行为,却通常不足以确定初始间距、接触时刻和具体路径。模型需要在共同坐标系和统一时间轴上保留这些变量,并让双方运动相互条件化。本章以双人交互为基本情形,依次讨论关系表示、协同扩散、离散动作补全和受观测历史约束的在线反应。
1. 双人序列的任务定义
双人交互是多人联合建模的基本情形。设人物 $A$、$B$ 的动作序列分别为 $X^A,X^B$,两段序列采用相同的物理帧索引 $t\in\{0,\ldots,T-1\}$ 和采样间隔 $\Delta t=1/f$。文本条件记为 $c$,共享环境条件记为 $\mathcal S$。当两人的动作都需要生成时,模型学习的是双方运动的条件联合分布:
联合生成同时确定两段运动的时序与空间关系,但相同的时间轴并不要求两人执行相同的行为。例如,拥抱可以接近对称,递交、搀扶和攻防则具有明确角色差异。人物编号 $A,B$ 是数据索引;施助者、受助者或攻击者是语义角色,二者需要通过条件表示建立对应。
若人物 $A$ 的动作已经给定,未知量就只剩人物 $B$。这形成伙伴条件下的反应生成:
离线反应生成以 $A$ 的完整序列为条件,因而可以利用其未来轨迹协调当前动作。在线策略则受观测历史约束:在时刻 $t$,只能以当前及此前状态预测未来运动。将双方已观测历史记为 $\mathcal H_t=(X^A_{\leq t},X^B_{\leq t})$,在线条件分布为
上述条件信息决定了任务难度。未来轨迹预测包含不确定性,完整轨迹条件则直接消除了其中一部分。因此,离线反应与在线反应需要分别评价,后者还需衡量预测误差累积及响应延迟。
在群体舞蹈、队形变化与共同搬运中,双人关系进一步扩展为多主体关系图。关系边可表示接触、跟随或共同操作对象,并随时间改变。由双人模型扩展到任意人数时,需要同时处理可变主体数、身份一致性和稀疏关系结构,固定双分支架构本身不具备这些性质。
2. 共同坐标系保留交互关系
用于交互建模的运动表示,首先需要保留不同主体之间的相对位置和朝向。单人动作常将初始根位置与朝向规范化,以消除无关的全局摆放差异;若对双方独立执行该操作而不保存相对变换,就会同时消除初始距离和相对朝向,使面对面接触与远距离动作难以区分。
设人体局部关节为 $u^A_{t,j},u^B_{t,j}$,根的世界位姿为 $(R^A_t,r^A_t)$ 与 $(R^B_t,r^B_t)$。世界坐标关节为
从 $A$ 观察 $B$ 的相对根位姿为
这些关系可统一写为李群 $SE(3)$ 上的相对变换。令根坐标系到世界坐标系的映射为
对两人施加同一个世界坐标变换 $h\in SE(3)$ 后,各自根位姿变为 $hg^A_t$ 和 $hg^B_t$,而相对变换满足
这种 Relative Egocentric Coordinates(以人物自身坐标系表达的相对坐标) 消除了共同世界摆放的影响,同时保留双方的六维相对位姿。若分别丢弃两人的根变换,则相当于对 $SE(3)\times SE(3)$ 的独立作用取商,连同相对距离和朝向一起删除;仅由两个局部骨架无法恢复这些变量。
这一几何不变性不意味着任意旋转都保持物理任务不变。对具有固定重力方向和地面的动作,主动旋转人体而不旋转环境会改变支撑关系;常用规范化仅移除水平平移和 yaw,属于保持重力方向的平面 $SE(2)$ 子群。完整 $SE(3)$ 的被动坐标变换仍然合法,但必须同时变换重力、地面法向和场景几何。
随人体运动的相对坐标系还包含非惯性效应。对离散观测所采样的连续轨迹,令 $r^{B\mid A}=(R^A)^\top(r^B-r^A)$,以物理时间求导得到
其中 $\omega_A^{A}$ 是 $A$ 坐标系中的根角速度,$[\cdot]_\times$ 为叉乘矩阵。局部相对位移的变化既包含双方平移,也包含观察者自身转动。对 $r^{B\mid A}$ 直接作有限差分时,旋转贡献已经包含在差分中;若把这一结果误当作 $(R^A)^\top(\dot r^B-\dot r^A)$,才会遗漏坐标系转动项。因而局部相对位置的导数与世界相对线速度在 $A$ 系中的分量,不能混为同一物理量。
在数据表示上,InterHuman 提供共同空间中的双人运动与文本标注,InterGen 以全局关节位置、旋转和逐帧位移保留双方关系。Inter-X 进一步提供手部运动及多类交互分析标注。关节集合、坐标轴、单位、帧率和角色标记共同定义数据接口;这些约定决定特征转换及损失计算的几何含义。
比较这些数据集的规模时,多视角视频帧数与独立动作时间帧数对应不同统计单位。InterHuman 的多相机观测可以提高同一接触过程的覆盖率,但不同视角仍对应相同的运动事件。数据规模比较需要以统一计数口径区分观测数量与行为多样性。
除共同空间坐标外,配对的双人动作还必须使用一致的采集时间与事件时间。相同序列长度并不保证事件对齐:相机延迟、姿态拟合后的平滑和重采样都可能改变快速接触时刻。逐人的姿态与速度即使合理,时间偏移仍会破坏联合接触。因此,配对片段需要统一重采样并使用相同裁剪区间。
遮挡造成的观测缺失应与静止状态区分。零向量填充可能形成非物理的关节突变,仅屏蔽重建损失也无法阻止 attention 读取异常输入。时间有效性掩码、关节可见性掩码和测量置信度,可以分别标记补齐帧、被遮挡关节和低质量观测。预处理与 attention 应共同使用这些信息,避免把填充值当作真实动作传入伙伴分支。
3. 协同扩散的跨人信息交换
共同坐标与时间轴保留了关系信息,生成器还需显式建模跨主体依赖。若两个生成器仅共享文本条件而独立采样,其联合分布被近似为
这一分解假设给定文本后两人的动作条件独立。然而,接触位置、时间和角色响应通常仍强耦合;一人的手部路径改变后,另一人需要相应调整。因此,共享文本能够约束交互类别,却不足以确定精确的联合几何。
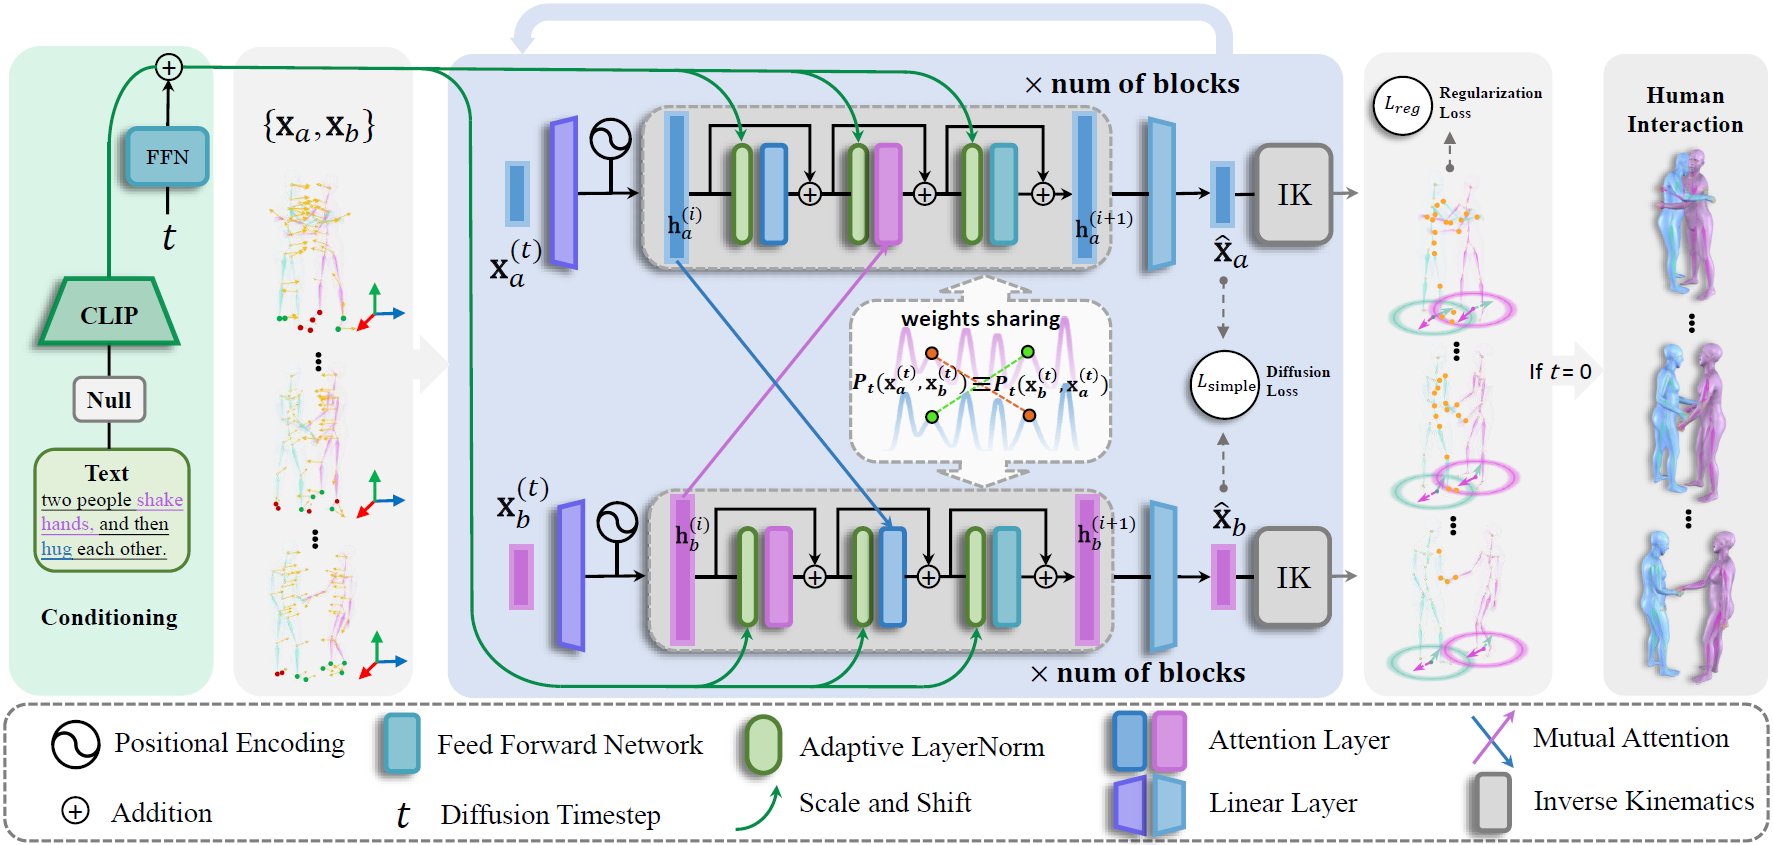
为建立这种依赖,InterGen 用两个共享参数的动作分支协同去噪。每个分支保留单人时序建模能力,同时读取伙伴特征。以 $k\in\{0,\ldots,N_d\}$ 表示离散扩散阶段,$X^{A,(k)},X^{B,(k)}$ 均包含全部 $T$ 个物理帧;网络层索引用 $r$ 表示,两人的时序特征分别为 $H_r^A,H_r^B$;$e_k$ 和 $e_c$ 分别编码扩散层级与文本条件。两个分支在同一层同步更新:
每个分支先进行自身的时间注意力,再查询另一人的特征。跨人注意力的一种基本形式是
其中 $Q_A$ 来自人物 $A$ 的特征,$K_B,V_B$ 来自人物 $B$ 的特征,$d$ 是单个 attention head 的键维度。权重矩阵 $A_{A\leftarrow B}$ 的行对应 $A$ 的时间查询,列对应 $B$ 的时间位置;聚合结果 $H_{A\leftarrow B}$ 将伙伴在不同时间的运动信息送入自身分支。配对动作、文本条件和训练损失共同决定哪些跨人关系参与预测。
扩散过程对双方拼接后的运动特征加噪,并以 clean motion(未加噪的动作序列) 为预测目标。关节距离与相对朝向可以直接在预测结果中计算,使交互几何参与去噪学习。文本与扩散时间条件共同调节两个分支,跨人状态则在每一步采样中持续交换。
人物索引只负责标记序列,交换索引后,输出应随之交换,物理交互本身应保持一致。这种性质称为 Permutation Equivariance(置换等变性)。人物轴上的交换矩阵满足
两个人物的重标号构成置换群 $S_2$。将角色、观测掩码和控制条件一起记为 $c$,所需等变关系为
若 $F_r$ 对两个分支使用相同参数,两次更新都读取上一层状态,且各层的位置编码、条件和掩码遵循同一置换规则,则该性质可逐层归纳成立。共享权重本身并非充分条件:固定的人物专属 Embedding、非对称掩码或先更新 $A$ 再让 $B$ 读取新状态,都会破坏上述交换关系。交换增强仅鼓励模型在样本上学习一致性,不能代替结构性的等变保证。
对于两个分支读取同一全局文本向量 $e_c$ 的结构,在位置编码与掩码满足上述对称条件时,共享同步更新首先保证 $f_\theta(PX,e_c,k)=P f_\theta(X,e_c,k)$。这里交换的是人物轴,条件向量保持不变;该结论并不自动处理文本内部的显式角色标记。
若条件写为“A 向 B 递交物体”,完整人物重标号还要求语义上变为“B 向 A 递交物体”。然而,通用文本编码器对两条描述通常产生不同向量,共享动作分支本身不能保证这两个向量满足所需变换规律。要把结构性保证扩展到 $f_\theta(PX,Pc,k)=P f_\theta(X,c,k)$,条件接口还需提供与人物轴一致的角色映射,例如随人物交换的结构化条件;仅改写角色文字或共享动作网络权重均不足以证明该性质。索引等变性也不要求递交者与接收者执行相同动作。
对于满足相应条件变换规则的随机采样器,交换初始噪声可检验逐样本等变;独立噪声下应检验分布层面的等变关系。
以人物 A 为锚的规范化还引入一个坐标处理层:交换 A、B 后重新规范化,会改变整段运动的表达坐标。此时需要连同相对根变换一起换算再比较输出,不能把锚坐标变化误判为去噪网络破坏了人物等变性。
3.1 配对动作预处理与双分支张量
InterGen 的每人表示为 262 维:22 个关节的位置、22 个关节的逐帧位移、21 个非根关节的 6D 旋转和四个足部接触值。预处理时,数据加载器对双方使用相同裁剪区间,分别求出初始根变换,再将第二人的特征刚体变换到第一人的规范空间,保留相对平移和朝向。
以 $B$ 表示 batch size,两人的逐帧特征沿最后的特征维拼接,得到 [B,T,524]。去噪器沿最后一维拆分成两个 [B,T,262] 输入,经共享线性层投影为 [B,T,1024],加入时间位置编码。文字条件是 768 维向量,投影到 1024 维后与 diffusion timestep Embedding 相加,作为每层的共同条件。
在这一隐藏表示上,基础配置堆叠八个、各含八头注意力的协同块。自身注意力与跨人注意力的权重均按时间轴组织,每头的权重为 [B,T,T];前馈层内部宽度为 2048。双方在同一层读取上一层特征,最后经共享输出层各恢复 262 维,再拼成 [B,T,524] 的 clean motion 预测。
训练按有效长度建立 [B,T,2] 时间掩码,两个分支使用同一个配对片段的有效区间。InterDenoiser 将有效位置取反作为注意力的 padding mask。这个掩码处理 padding 帧;它没有把时间注意力变为因果注意力,整段联合生成仍可读取完整的带噪片段。
3.2 Clean Motion Prediction 与联合采样
训练随机选择扩散步 $k$,对联合特征加噪,要求去噪器预测 clean motion $X^{(0)}$。上标零表示无噪声状态,序列内部仍包含 $t=0,\ldots,T-1$ 的全部物理帧。直接预测 clean motion 使关节关系损失能作用于同一份输出;文字条件的随机丢弃使网络同时学习有条件与无条件的去噪。
推理从 [B,T,524] 高斯噪声开始,每步同时更新两人的状态。余弦噪声日程确定各阶段的噪声比例,DDIM 逐步推进反向采样;classifier-free guidance 组合有条件与无条件的 clean motion 预测,强化文字约束。两人的接触关系贯穿这条联合采样链。
4. 交互几何与接触损失
跨人 attention 使双方特征相互可见,但信息交换本身并未规定哪些部位应当接近、何时形成接触。关系损失为这些要求提供几何监督。双方关节距离矩阵定义为
该矩阵同时编码手—手、手—肩和脚—脚等部位关系。根距离主要反映整体布局,局部关节距离反映部位接近程度;二者的空间分辨率不同。人体表面非穿透仍需网格或体积层面的几何度量。
用加权距离误差表达关系约束,可写成
权重 $w$ 可以强调接触候选部位,减少大量远距离关节对梯度的支配。距离矩阵描述整体关系;若已知哪些部位应该接触,还可以进一步约束接触期间的局部运动。对于标注的接触集合 $\mathcal C$,例如可使用接触距离和相对速度:
速度由物理时间差分 $v_{t,i}=(p_{t+1,i}-p_{t,i})/\Delta t$ 近似,不能与扩散阶段之间的数值变化混淆。相对速度约束仅适用于接触期间近似共同运动的局部点。击掌和拳击包含冲击,接触前存在非零法向接近速度;持续强制双方相对速度为零会消除这些动作的关键事件。
InterGen 将预测特征反标准化后计算三类关系。其中,距离矩阵目标 DM 选取预测中小于 1 米的关节对,使其距离接近真值;关节亲和目标 JA 选取真值中小于 0.1 米的关节对,鼓励预测中的对应部位接近。前者的筛选来自预测,后者来自真值,监督作用因此不同。相对朝向目标 RO 通过两人的髋部方向计算相对旋转。时间有效性掩码排除 padding 帧,扩散步掩码则限制关系损失在哪些噪声层级参与训练;两种掩码分别作用于物理时间轴和扩散采样轴。
关节级约束仍有分辨率限制。两个手腕中心接近,并不保证手掌法线正确;骨架没有相交,也不保证肩膀、胸部或衣服网格没有穿透。若应用使用人体网格,应进一步计算表面距离、穿透深度与接触面积,并检查不同体型下的结果。软损失可以改善几何统计,不能构成无碰撞的数学保证。
接触判定还依赖时间结构。以挥手与握手为例,挥手掠过肩部可能产生瞬时近距离,但不形成持续接触;握手则需要一段时间内稳定的部位关系。距离、相对速度、持续时长和部位类别共同构成判定依据。低帧率还可能遗漏瞬时碰撞,因此接触评价的时间窗口需与交互类型和采样率匹配。
接触损失的有效性依赖语义条件与接触集合的一致性。例如,“躲开对方伸出的手”要求分离,“握住对方的手”要求接近,对所有样本施加相同模板会形成矛盾监督。更深层的区别是:距离和滑动损失约束轨迹,却没有显式求解支撑这些轨迹的接触力。
以局部无黏着刚性表面接触为近似,令 $q$ 为双人的联合广义构型,定义非穿透间隙 $\phi(q)\geq0$、法向接触力 $\lambda_n$ 和切向力 $\boldsymbol\lambda_{\mathrm{tan}}$。Signorini 条件与 Coulomb 摩擦锥要求
其中 $\perp$ 表示互补关系,即 $\phi(q)\lambda_n=0$,$\mu$ 是摩擦系数。接触面可以分离,但分离时法向压紧力必须为零;摩擦锥则限制在给定法向力下能够提供多大的切向力。锥内的力约束本身尚未确定 stick 或 slip,还需要接触点相对速度与摩擦耗散定律;冲击则需在速度跃变层面使用接触冲量。人体软组织的可压缩性会进一步偏离理想刚性假设。
在握手、推扶或共同支撑中,同一接触点作用于两人的力在共同坐标系中大小相等、方向相反,但对各自质心产生的力矩不同。因此,关节距离较小的序列仍可能要求不可实现的接触力或平衡状态。InterGen 的几何正则提高轨迹层面的相容性,动力学可行性还需要接触求解或物理控制层;这一区别将延续到人—物交互与机器人控制。
5. 协同离散建模与动作补全
上述协同机制在连续动作特征上反复去噪;另一条路线先压缩运动,再在离散空间中完成双方协调。InterMask 把每个人的运动编码成具有时间与空间两条轴的 token 图,随后联合恢复被遮挡的 token。时间轴描述运动推进,空间轴保留压缩后的关节区域;这使模型能够分别组织身体区域内部的变化与人物之间的联系。
设两人的离散图为 $Z^A,Z^B$,观察集合为 $\mathcal O$,遮挡集合为 $\mathcal M$,复合索引 $\ell$ 指明人物、压缩时间与空间位置。它不是物理帧或扩散阶段。将已观测双人 token 与文本条件汇总为 $\mathcal I_{\mathcal O}$,掩码模型训练条件预测
采样时,模型并行预测被遮挡位置的 token 分布,再根据置信度更新观测集合。双方的 token 共同参与条件建模,使局部预测依赖伙伴状态。固定一人的完整 token、仅更新另一人,可形成条件反应;对双方保留前缀并恢复后续位置,则形成交互续写。
5.1 二维运动压缩与 token 排列
InterMask 在 InterHuman 上沿用每人 262 维文件格式,但送入压缩器前重新组织特征。22 个关节的位置与逐帧位移各占三维,非根关节的旋转占六维,根旋转位置补六个零,形成 [B,T,22,12],再转置为 [B,12,22,T]。文件末尾四个足接触值没有进入这个 VQ 输入。
图卷积先提取关节关联,再通过两次二维步长卷积同时压缩空间与时间。关节轴由 22 降为 11、再降为 5,时间轴缩短四倍,得到 [B,512,5,N],$N=T/4$。每个单元量化为 Codebook(用于量化的码向量集合)中的编号;在单层、1024 项 Codebook 配置中,一人的离散图为 [B,5,N]。五个空间位置是学习后的压缩区域,并不是五个有固定解剖命名的关节组。
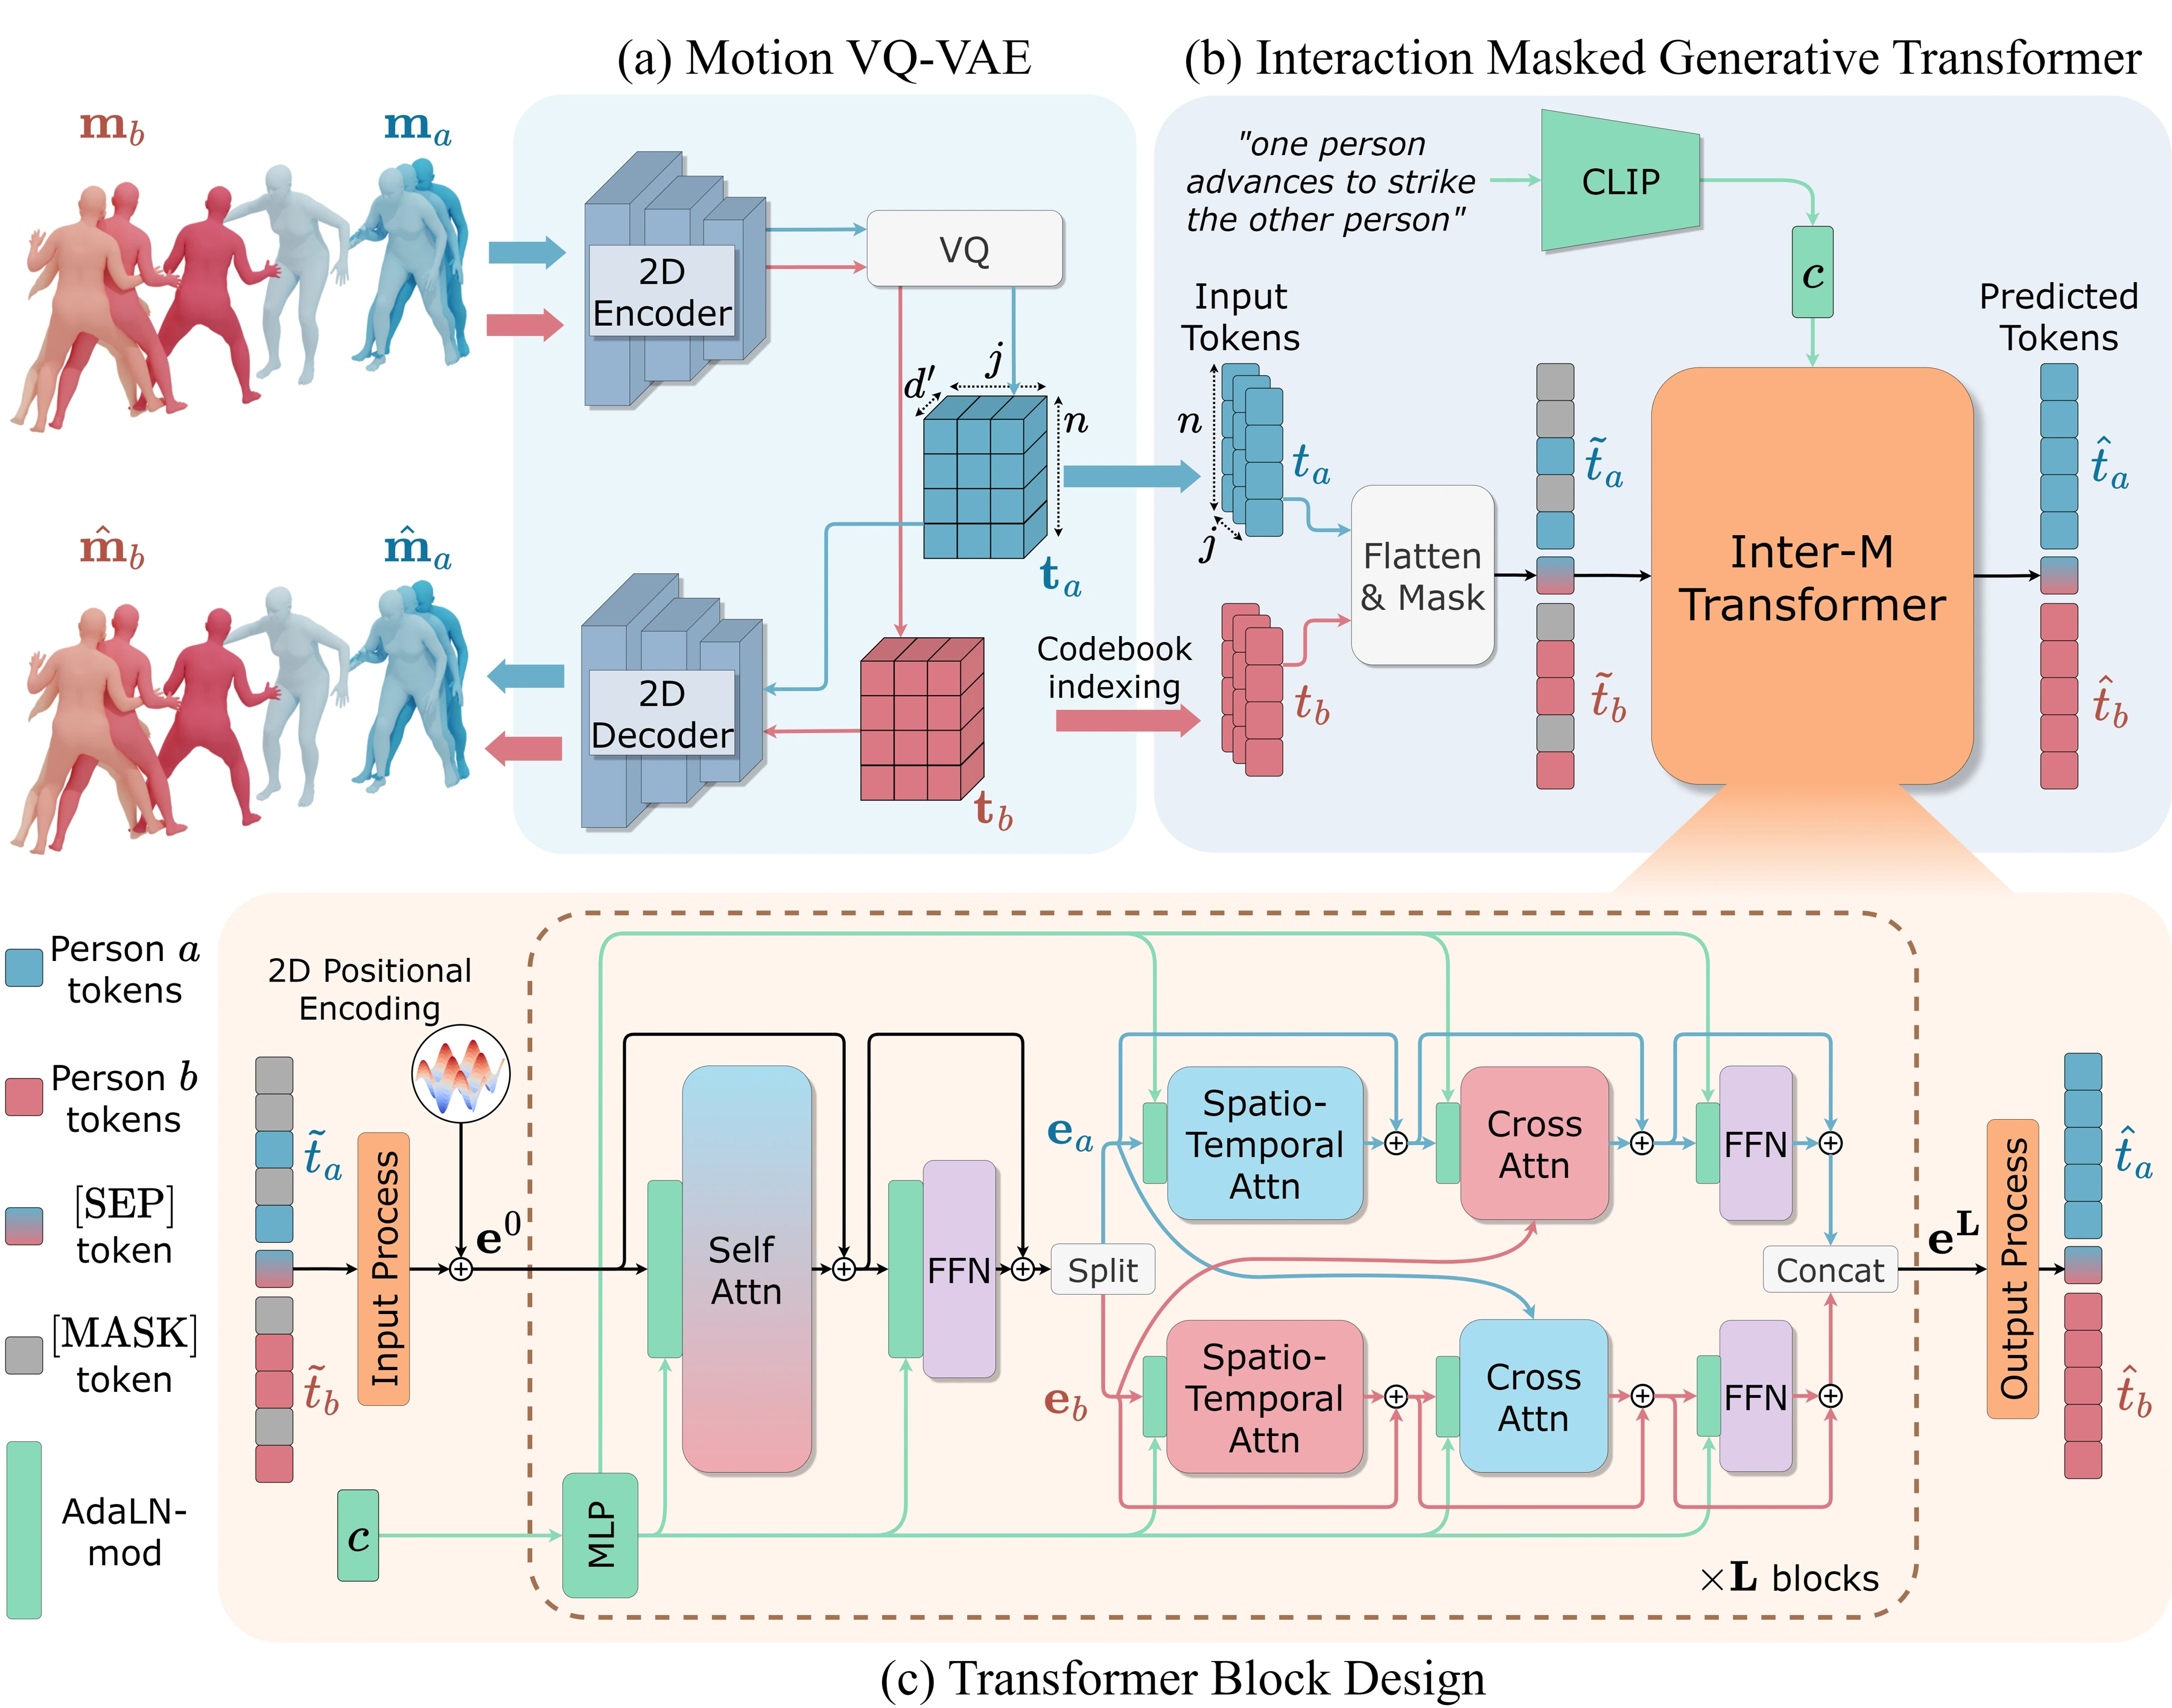
生成器将每人的二维编号图展平为 [B,5N],两人合并为 [B,10N]。通过 Embedding 后在人物之间插入一个分隔位置,形成 [B,10N+1,d],并为每人加入时间与空间位置编码。遮挡、补齐和分隔符号属于输入控制位置,输出头仍只预测 1024 个普通运动编号。有效长度转换为压缩后的时间长度,再在五个空间位置和两个人上展开为 padding mask。
压缩器先以运动重建与 commitment loss 训练,并加入位置、速度、骨长、旋转和接触相关约束;随后固定压缩器训练掩码生成器。解码时,码向量恢复为 [B,512,5,N],经过空间和时间上采样还原每关节特征。postprocess 拼回 262 维,其中末尾四个足接触位补零;生成轨迹的足接触应根据恢复后的几何重新判断。
5.2 协同注意力、遮挡训练与迭代推理
InterMask 的协同块先在合并序列上执行全局注意力,使双方的所有有效位置交换信息。随后拆出两人的 [B,5N,d] 状态:空间注意力将每个时间位置组织为五个区域,时间注意力将每个区域组织为 $N$ 个时间位置,两路结果相加;跨人注意力以自身更新后的状态为查询,以伙伴进入该局部模块时的状态为键和值。双方调用共享模块并同步更新。
CLIP 文字向量经过投影,生成 AdaLN 的平移、尺度和门控参数,调节注意力与前馈更新。这个条件描述整体交互,人物分隔及跨人状态则提供角色和伙伴的结构位置。实现中的跨人模块没有固定窗口掩码,伙伴的有效位置可完整读取;其中的“局部”指对人物分支分别组织更新。
输出移除分隔位置,再经分类头得到 [B,1024,10N] logits。训练随机抽取遮挡比例,主要监督被选中的有效编号;另有整人遮挡,使模型在完整伙伴条件下预测另一人。对部分选中位置保留真值或随机替换,可减少模型对单一 mask 符号的依赖。One-step unrolling(将一次模型预测展开为下一次训练上下文) 还把初次预测中的较高置信度编号作为新输入,继续监督剩余位置。模型由此接触部分由自身预测组成的上下文,减小仅在真实 token 条件下训练与迭代推理之间的差异。
推理从双方全部有效位置被遮挡的编号图开始。每轮在候选编号中采样,按置信度保留部分结果,余下位置继续预测,剩余数量由余弦日程控制。文字条件的随机丢弃支持 classifier-free guidance。反应生成则始终保留已知人物的编号,只更新另一人的遮挡位置,最后分别通过固定 VQ 解码器恢复连续轨迹。
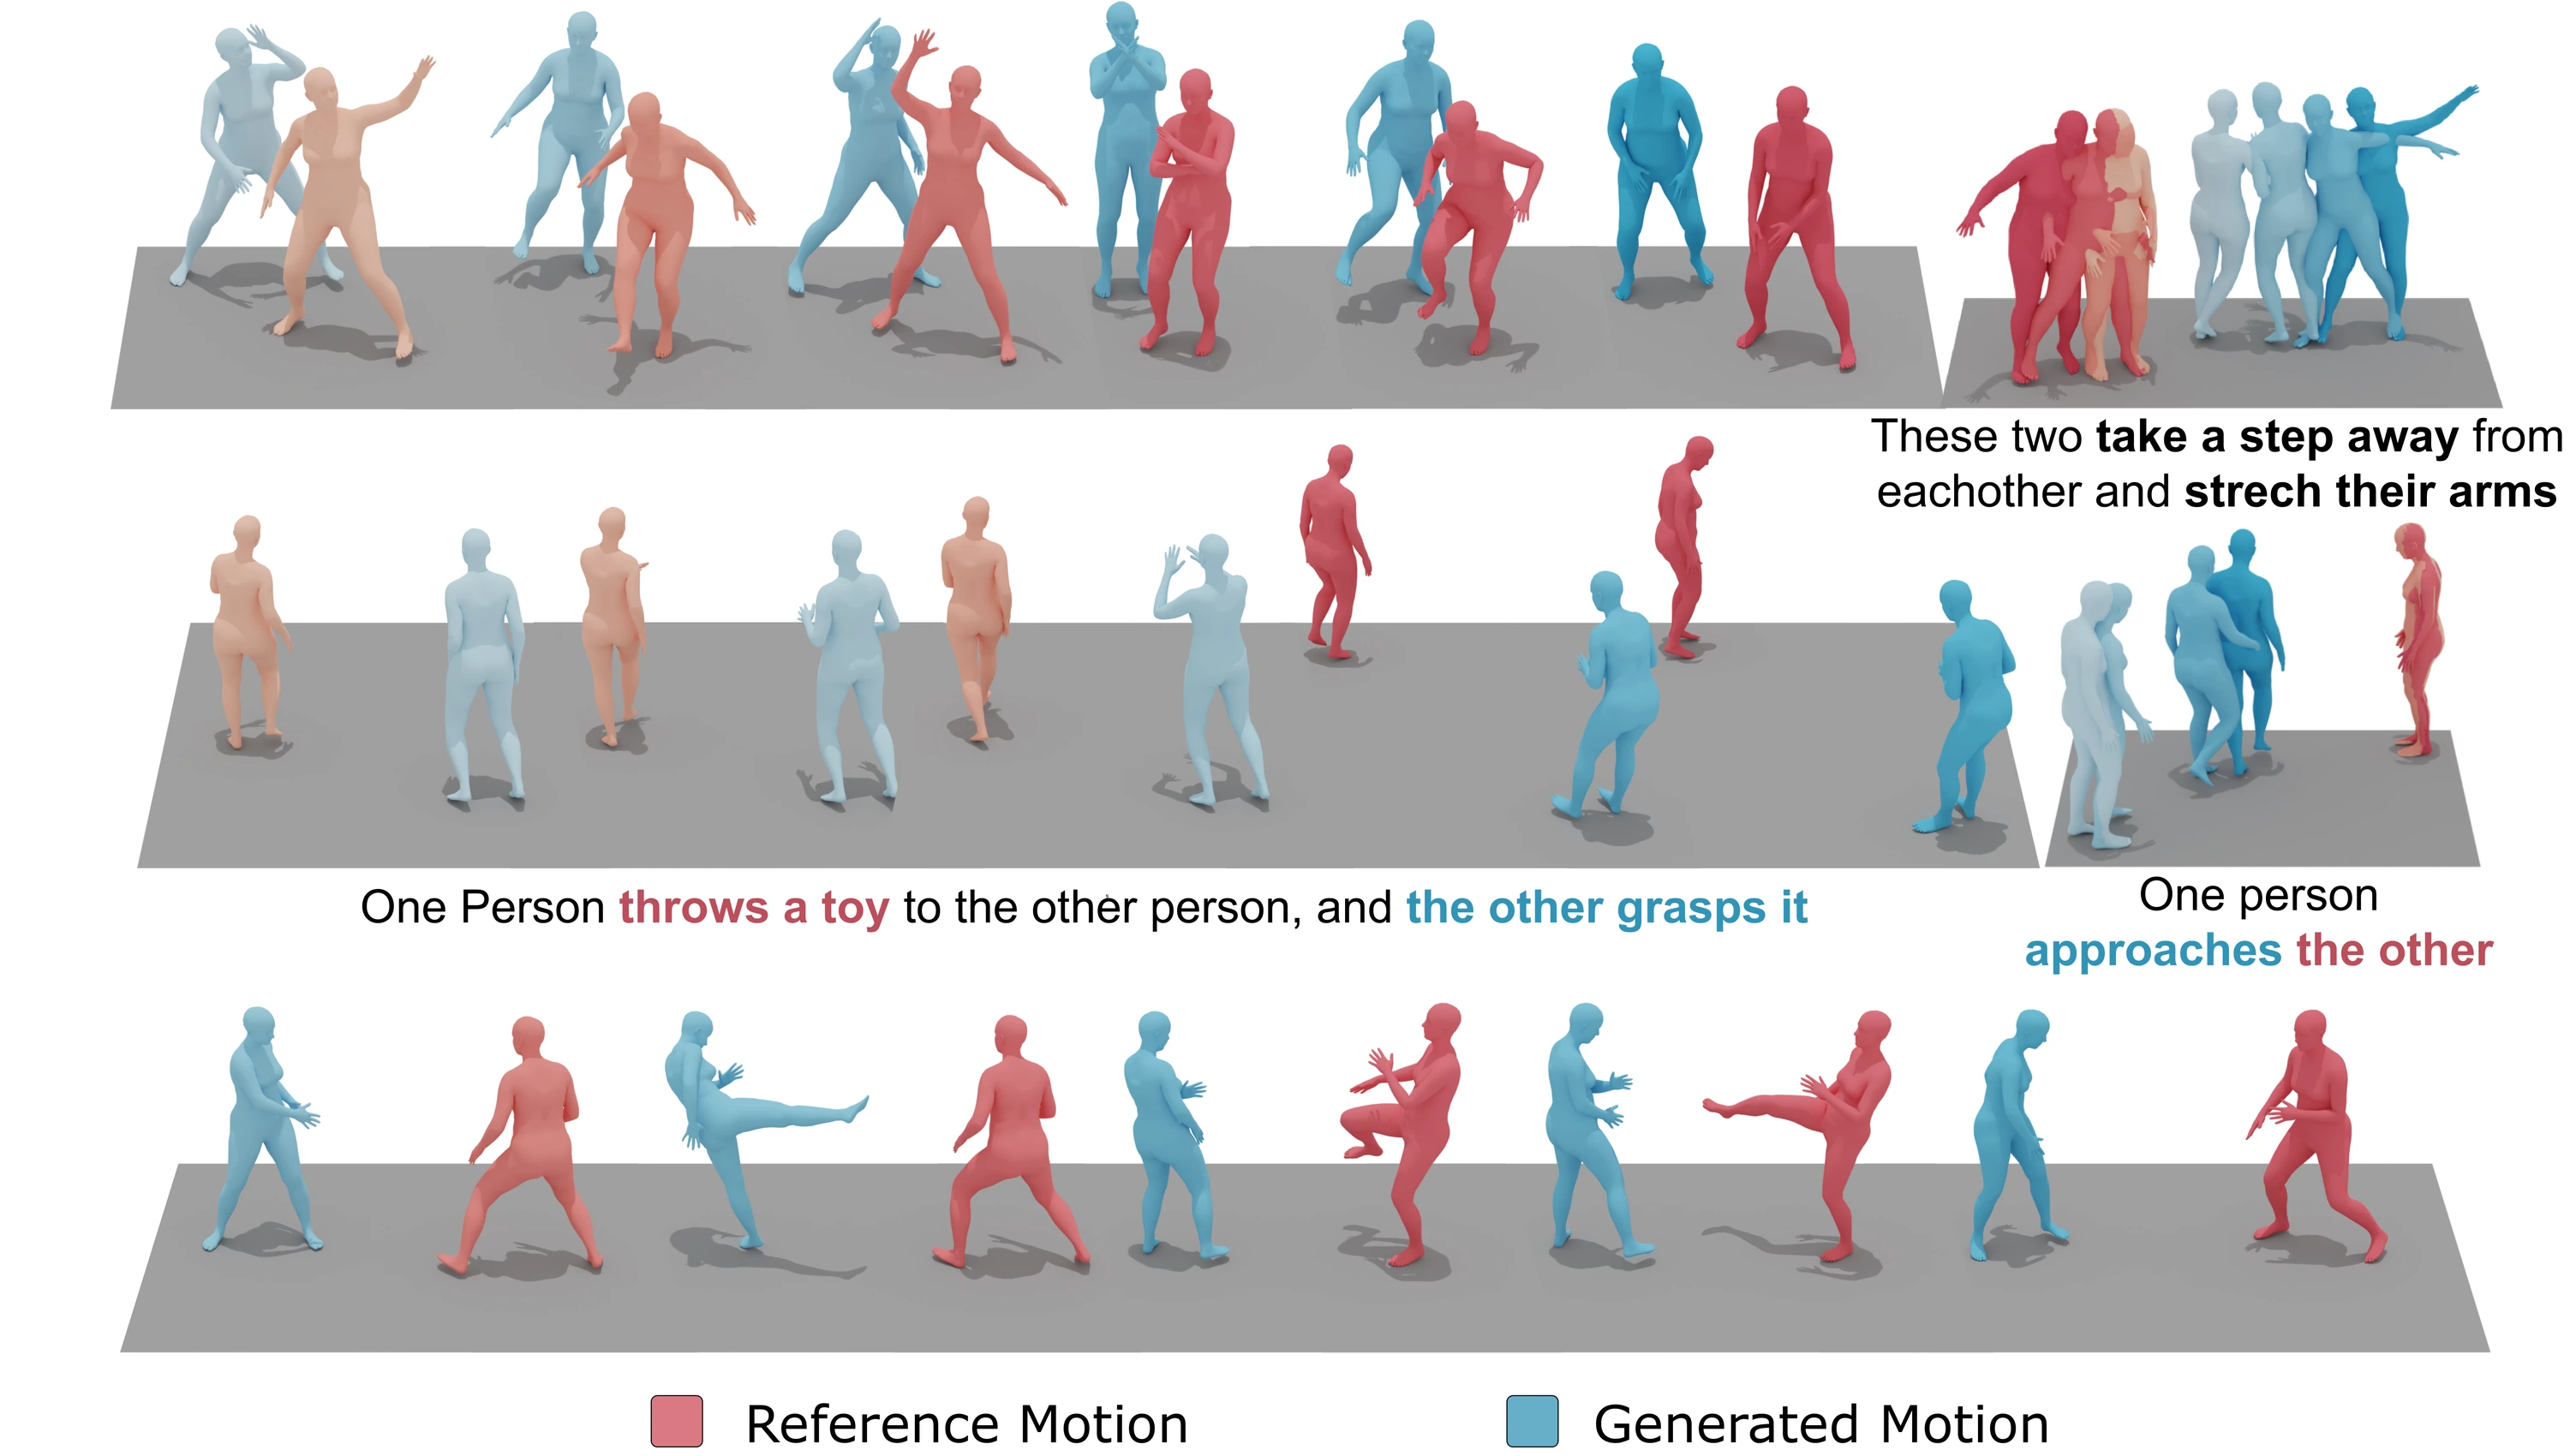
已知人物的 token 在迭代中保持可见,生成伙伴的 token 则逐步恢复。完整伙伴轨迹提供时空条件,文本进一步选择反应类别及角色关系,因此相同的补全接口可以同时表达无文本反应和文本控制反应。该设置以完整伙伴序列为条件,属于离线条件生成。
5.3 量化误差与接触精度
离散模型的误差有两个来源:一方面,量化器和解码器无法完全还原原始动作,限制了压缩后的接触精度;另一方面,生成器预测不合适的 token 或组合,又会增加条件采样误差。两者共同形成最终接触偏移,因此表示精度与生成机制都影响双方的接触质量。
从连续控制进入 token 空间时,厘米级接触目标也不一定有直接对应的符号。锁定某个 token 只是锁定一个编码单元,不能保证某只手在指定世界坐标保持静止。精确编辑通常还需要解码后的几何校正,或者把控制条件显式送入生成过程。
Motion In-betweening(给定前后动作片段并生成中间过渡)还要求观测片段与生成片段连续衔接。单帧位姿约束规定位置与朝向,却不能充分确定进入和离开该帧时的速度。保留时间邻域、使用重叠窗口或施加速度连续性约束,可减少衔接处突变。双人过渡需要在联合序列上处理片段起止条件,以保持双方已经对齐的接触时间。
6. 在线反应中的历史与反馈
掩码反应生成可以读取伙伴的完整动作,适合离线补全。若伙伴的下一步尚未发生,任务就变为持续观测与更新的在线反应。Ready-to-React 沿时间自回归推进,并使用扩散头产生具有多样性的未来动作。其 DuoBox 拳击数据提供连续攻防关系,策略的输入则限制为当前及此前的可观测历史。
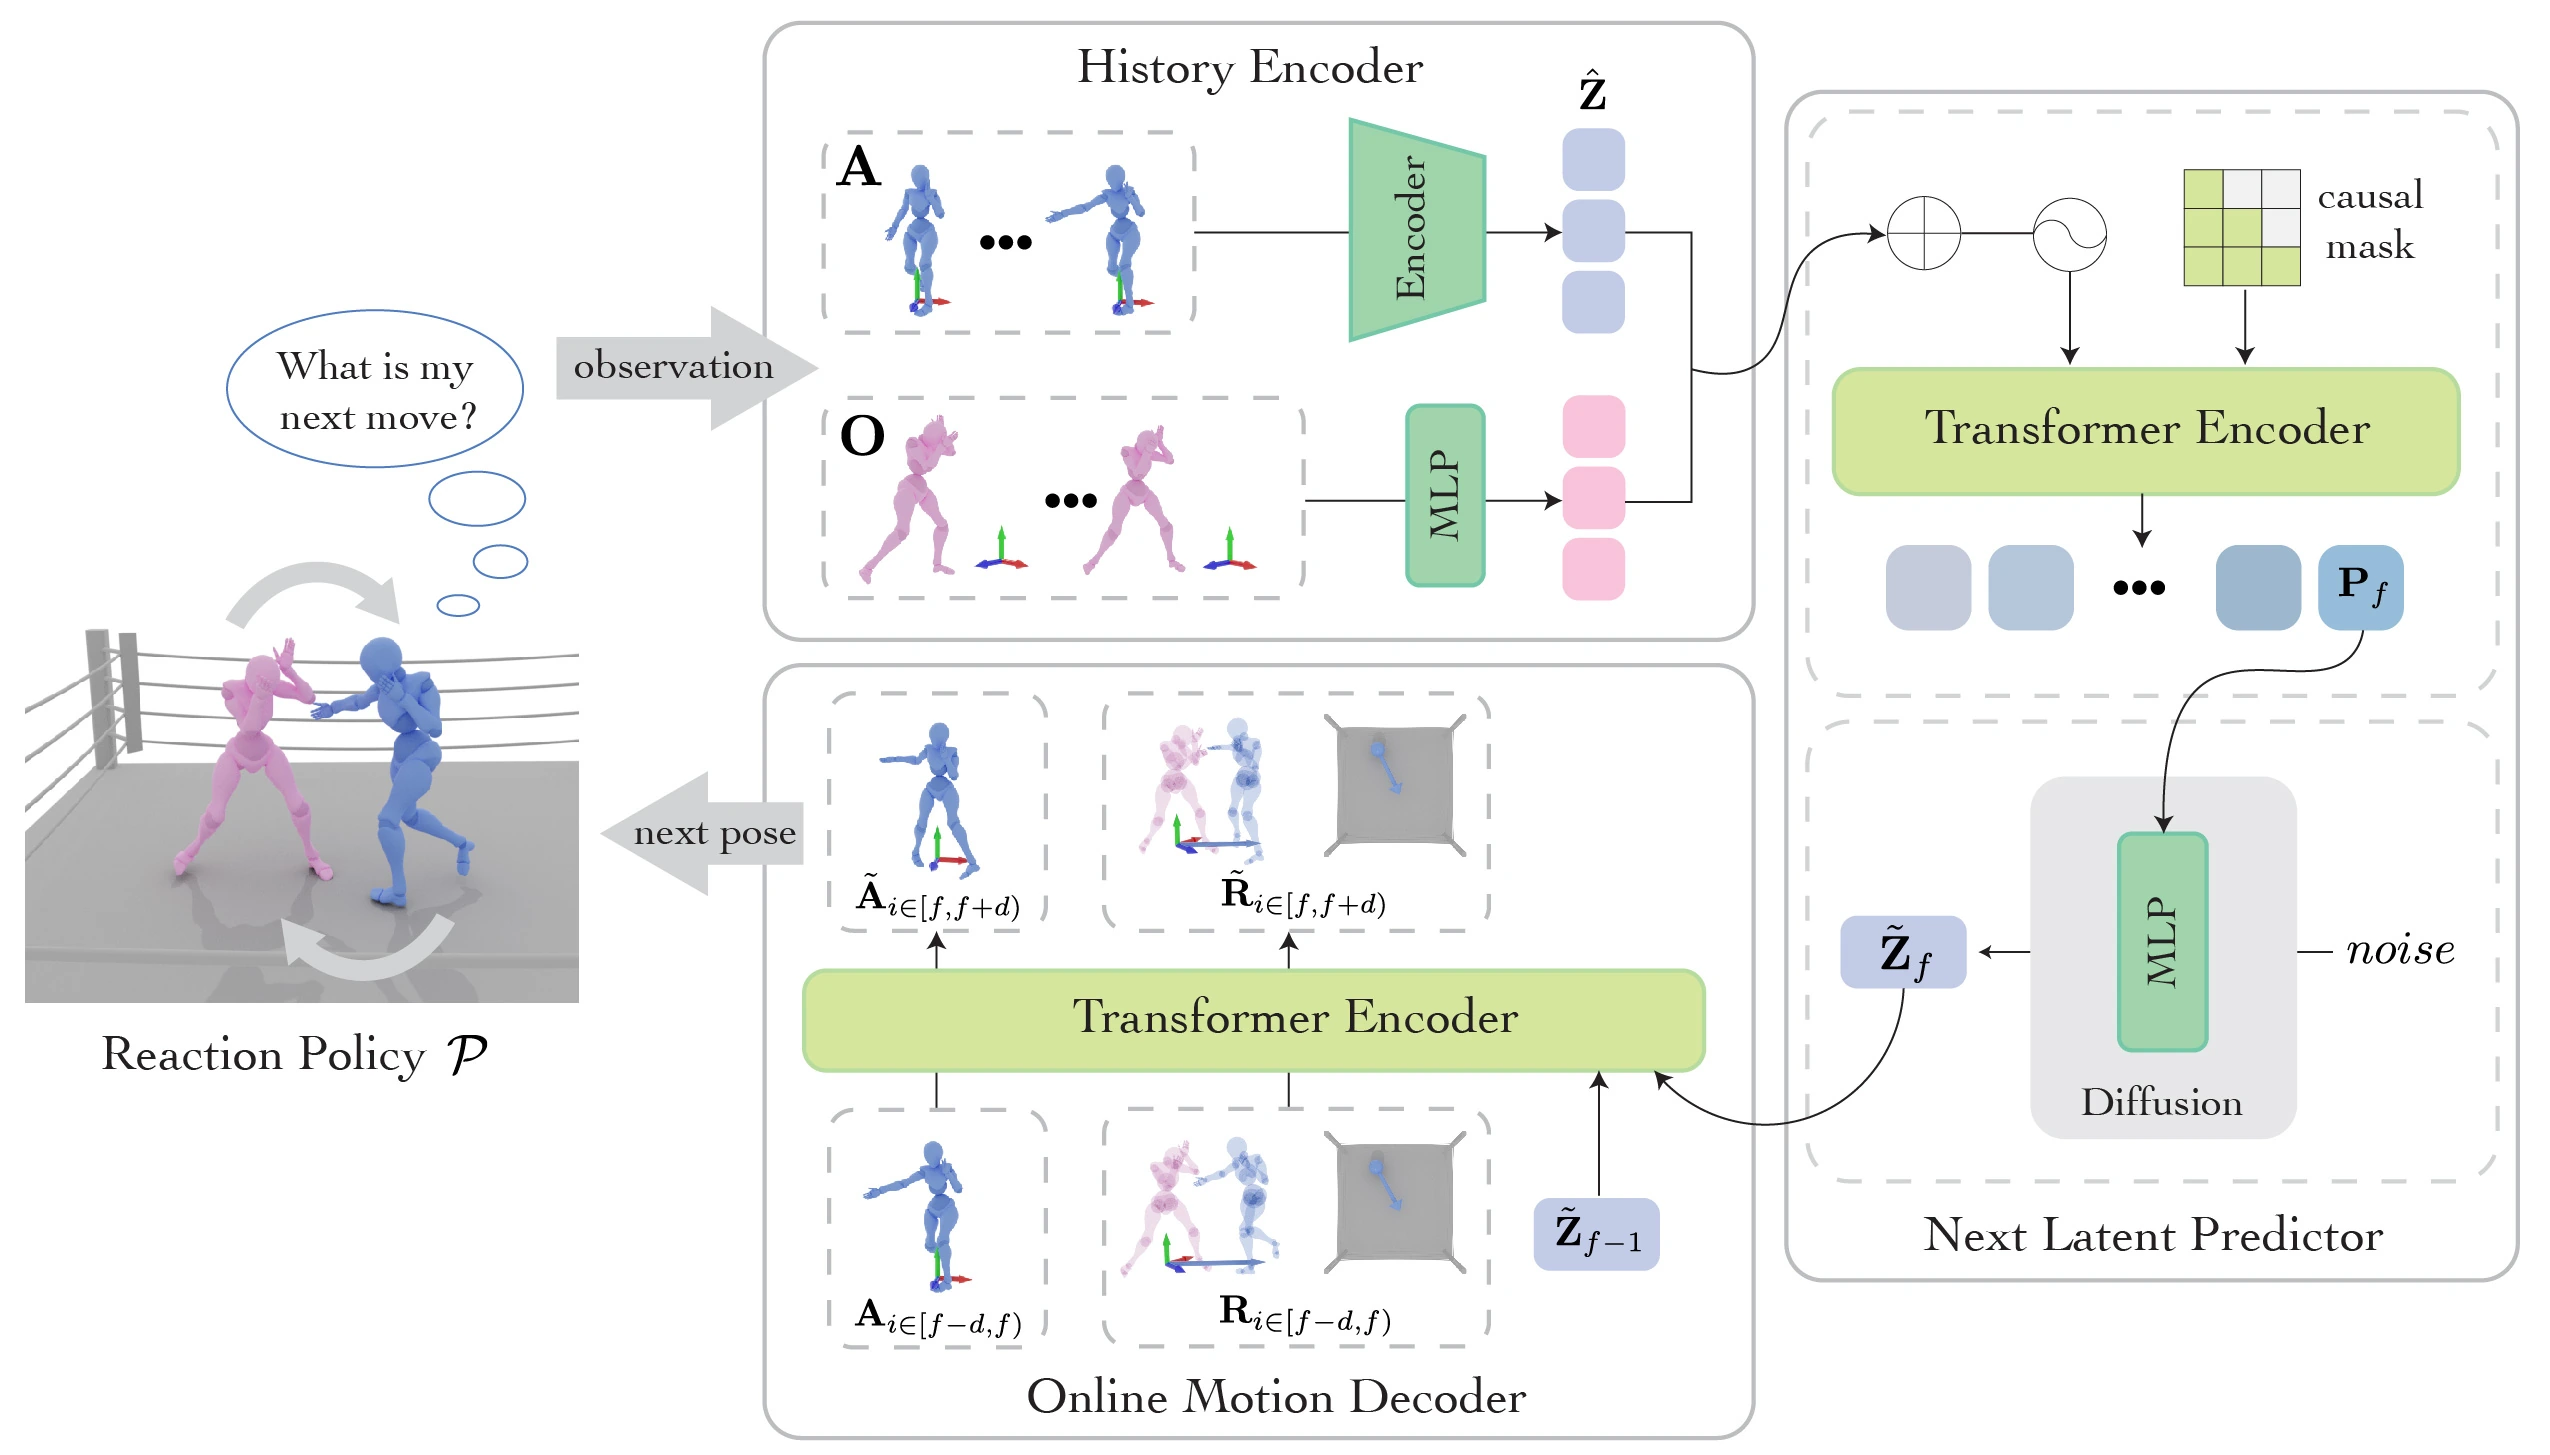
Ready-to-React 先训练 VQ-VAE,以四倍时间压缩率提取自身动作的 latent code(压缩后的局部运动特征);伙伴的历史运动经过相同下采样和 MLP,映射到与自身 code 相同的特征宽度。随后,Transformer 使用 causal mask 融合两路历史,其输出只作为下一 latent 的条件,diffusion head 在这个条件下采样连续 code。最后,Online motion decoder 读取相邻两个 latent、此前姿态和相对根状态,恢复接下来的四帧动作,因此无需等待完整序列生成。
训练随后固定 VQ encoder,联合优化 latent predictor 与 online decoder;动作重构和相对根信息重构与 diffusion loss 一起约束预测。DuoBox 原始动作捕捉数据被重采样到统一帧率,并通过交换自身与伙伴角色增加训练配对。这里的自回归次数决定运动向前推进多少,diffusion head 内的去噪步数只决定一次 latent 采样的计算量,两条时间轴分别对应运动过程与生成过程。
在线策略随新观测更新条件,而离线联合生成以固定条件产生完整片段。伙伴状态变化后,策略应利用更新后的历史调整未来预测。一般的滚动预测与执行可表示为:
每次仅执行预测窗口中的前 $m$ 帧,再重新观测并更新后续预测。若输入运动采样率为 $f$,这一理想化参考刷新周期为 $m\Delta t$,刷新频率为 $f/m$;内部扩散采样次数只影响计算延迟。动画帧输出也不等于机器人底层伺服循环,后者需要单独定义执行频率及动力学接口。
推理时,策略接收的自身历史包含已经生成的动作;训练时使用真实前缀,因此两阶段的条件分布并不完全一致,这种差异称为 Exposure Bias(由真实历史训练与预测历史推理之间的差异造成的偏移)。状态偏移进一步改变主体间距、朝向和后续条件。在局部线性近似下,误差传播由闭环更新的 Jacobian 决定:单步误差较小不能排除反复反馈中的放大。双方共同生成时,还需分析交叉响应的耦合,而非只评价两个独立单人序列。
一方使用录制轨迹时,伙伴状态不受生成结果影响,评价侧重条件反应能力;若双方均由策略驱动,动作相互构成未来输入,形成闭环反馈。与前一种设置相比,后者还涉及联合稳定性和误差传播。
端到端响应延迟由观测、特征转换、模型采样与执行缓存组成。较大的预测窗口有利于规划连续运动,却可能延长新观测进入输出的时间。因此,在线系统需要同时衡量延迟、持续生成速度和长期交互质量。
因果性可以用输入扰动检查。具体而言,在时刻 $t$ 保持所有历史完全相同,只修改伙伴在 $t$ 之后的录制动作;正确的在线策略不应因此改变时刻 $t$ 的输出分布。这个检查对预处理也有效:若特征采用全序列中心化、双向平滑或未来速度估计,即使网络使用因果注意力,未来信息仍可能在进入网络之前泄漏。在线实验需要从原始观测到动作输出的整个链路都满足因果条件。
7. 算例:共同坐标与交互距离
在二维俯视平面中,同时移动两个人不会改变手部距离。接触与远距离两种构型原本具有不同的手部间隙,但分别去除两人的根平移后,局部手部坐标可能完全相同。这个算例观察两种规范化对交互信息的影响:共同平移保留相对几何,逐人去除根平移则会删除它。
1 | import numpy as np |
运行结果:
1 | 接触场景手部距离: 0.000 m |
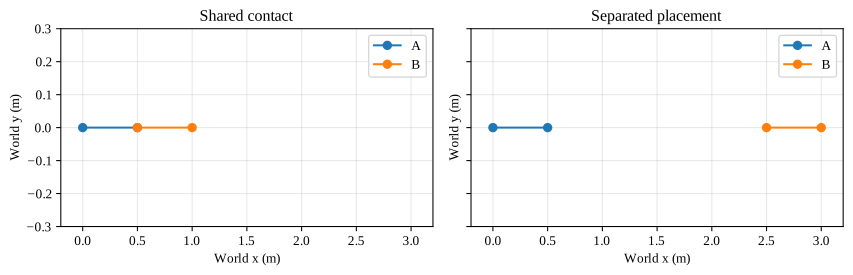
接触构型与分离构型在逐人规范化后完全重合,因而任何仅依赖局部手部坐标的函数都无法区分二者。共同平移则使两点位移同时改变,差向量及距离保持不变。补充 $g^{B\mid A}$ 后,局部姿势与相对位姿足以恢复双人相对几何;丢弃的仅是任务允许忽略的共同世界摆放。
8. 算例:共享跨人更新与置换等变性
跨人注意力的代数结构可直接检验。以下算例使用相同更新函数,两次查询均读取上一层状态,且没有人物专属条件,因此满足 $S_2$ 的交换关系。顺序更新则改变第二分支的输入依赖,即使权重完全共享,也一般不再等变。
1 | import math |
运行结果:
1 | 输出形状: (1, 4, 6) |
InterGen 将 [B,T,524] 拆为两个 [B,T,262] 人物分支,使用相同 Embedding、self-attention、cross-attention 和前馈参数。两次跨人更新均以 h_a_prev,h_b_prev 为输入,使当前层的输出对上层特征保持对称依赖。这一计算图对应同步消息传递,而非先后执行的条件修正。
同步更新得到零置换误差,与 $F(PH)=PF(H)$ 一致。顺序更新与同步更新的数值差异显示了计算图改变的直接影响,但单次输入检验不能替代结构证明。有效时间掩码还需随人物轴一同置换,并同时约束自身与跨人注意力;若某一人的已知未来被错误地送入在线分支,索引等变仍可能成立,时间因果性却已经失效。两种约束彼此独立。
9. 联合评价与误差来源
交互质量需要在联合动作上评价。一人的“伸手”无法区分握手、推人和接物,文字一致性评价因而应读取双方的信息。FID 与检索精度等指标还依赖评价器及训练分布,跨编码器比较时需要统一协议。
空间质量包括相对根位姿、接触部位误差和网格穿透;时间质量包括接触顺序、响应延迟、脚滑和速度突变。生成任务允许多种合理实现,因而未必要求与单一参考逐帧一致,但语义角色、接触关系及几何可行性仍构成共同约束。
相邻裁剪片段可能包含几乎相同的动作内容,按片段随机划分会让训练集与测试集共享运动模式,高估对新交互的泛化。按人物划分检验身体和动作风格变化,按交互类别划分检验新行为组合,按场景划分则检验空间布局的变化。它们改变的是测试分布,不能直接互换。
数据版本、文字预处理与评价器还会改变测量对象。增加手部关节会使接触评价更细,修正接触标签会改变监督位置;更换文字编码器则改变语义距离和检索排序。因此,几何误差或检索分数的变化,可能同时来自表示、数据与评价模型。
交互误差对应不同层次的信息缺失。共同坐标或相对根轨迹不完整时,双方距离容易失控;角色条件含混时,交付与接收行为可能交换;骨架分辨率不足时,手腕接近仍可能伴随手掌穿透。在线生成还会将自身误差送回历史状态,使自然的短片段逐渐偏离稳定交互。表示、语义条件、接触几何与反馈机制由此共同决定联合运动质量。
参考资料
Han Liang, Wenqian Zhang, Wenxuan Li, Jingyi Yu, and Lan Xu. InterGen: Diffusion-based Multi-human Motion Generation under Complex Interactions. International Journal of Computer Vision, 2024.
Muhammad Gohar Javed, Chuan Guo, Li Cheng, and Xingyu Li. InterMask: 3D Human Interaction Generation via Collaborative Masked Modeling. In International Conference on Learning Representations, 2025.
Zhi Cen, Huaijin Pi, Sida Peng, Qing Shuai, Yujun Shen, Hujun Bao, Xiaowei Zhou, and Ruizhen Hu. Ready-to-React: Online Reaction Policy for Two-Character Interaction Generation. In International Conference on Learning Representations, 2025.
Liang Xu, Xintao Lv, Yichao Yan, Xin Jin, Shuwen Wu, Congsheng Xu, Yifan Liu, Yizhou Zhou, Fengyun Rao, Xingdong Sheng, Yunhui Liu, Wenjun Zeng, and Xiaokang Yang. Inter-X: Towards Versatile Human-Human Interaction Analysis. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 22260–22271, 2024.
Kewei Sui, Anindita Ghosh, Inwoo Hwang, Bing Zhou, Jian Wang, and Chuan Guo. A Survey on Human Interaction Motion Generation. International Journal of Computer Vision, 2026.
Resources
- Numerical examples.
- InterGen: Project and InterHuman dataset, Repository, Paired preprocessing, Denoiser, Interaction losses, Model configuration.
- InterMask: Project, Repository, Motion VQ, Spatio-temporal encoder, Training and inference, Collaborative attention.
- Ready-to-React repository, Inter-X dataset and baseline.
Figure credits
- InterGen architecture: official project.
- InterMask teaser and architecture: official project. Conditional reaction samples: Figure 6 from the author manuscript.
- Ready-to-React architecture: official project.