CH-05 动作生成的奖励优化与偏好学习
符合文本描述或满足局部位置条件的运动,仍可能出现脚部滑动、速度突变或不自然的身体协调。例如,同一句“一个人缓慢坐下”对应的两个样本,可能分别在接触稳定性与下降速度上存在缺陷。常规去噪、重建与 token 预测目标主要拟合训练数据,并未直接规定这些质量差异的排序;训练数据中的误差与不充分的行为覆盖还会限制生成结果。改进此类问题,需要把对当前生成动作的评价转化为模型更新信号。
动作生成的后训练(post-training)利用质量评分或偏好监督,在预训练模型上进一步调整条件分布。文本检索提供语义反馈,人工比较提供感知排序,接触规则提供运动学评价。不同信号的可计算性与可微性决定它们如何参与训练,由此形成成对偏好优化、策略梯度和可微奖励等路径;参考策略约束则用于限制分布偏移。
1. 监督目标与动作质量目标
在动作 token 模型中,监督目标是降低标注序列的负对数似然;在扩散模型中,是降低噪声或 clean motion 的预测误差。两类目标均以训练样本为监督依据。例如,若数据中的坐下动作只占很小比例,监督目标会同时受到大量其他动作的影响;若某个标注样本包含重建误差,模型也可能学习这种误差。
reward(奖励)将特定质量属性映射为标量评价;policy(生成策略)则描述模型在给定条件下产生各动作的概率。二者职责不同:reward 判断样本质量,policy 决定哪些样本会被生成。记生成策略为 $\pi_\theta(X\mid c)$,奖励为 $r_\phi(X,c)$。物理帧索引采用 $t\in\{0,\ldots,T-1\}$,采样步长为 $\Delta t=1/f$;离散扩散噪声级采用 $k\in\{0,\ldots,N_d\}$,连续生成时间采用 $s\in[0,1]$。奖励优化的迭代次数属于参数更新轴,不对应人体运动时间。固定评分器时,理想目标是
生成结果由当前参数决定,评分对象的分布因此随策略更新而改变,形成与固定监督数据不同的优化过程。例如,优化“坐下时不要脚滑”时,训练可反复测量当前模型生成的接触位移,而无需等待新标注覆盖每一种错误。
单一奖励通常仅覆盖部分质量维度。例如,为提高“缓慢”的语义分数而降低所有速度,可能得到几乎静止的动作;为减少脚滑而固定双脚,可能破坏应有的迈步。奖励不能脱离动作类别、有效长度和接触阶段来解释。多奖励优化还需处理各目标的尺度差异与潜在冲突。
上述质量反馈可以沿三种主要路径用于后训练。成对偏好提供相同条件下的相对排序;策略梯度通过采样概率与奖励相关性更新参数;可微奖励直接利用评分对动作的导数。选择哪一条路径取决于生成概率是否可计算、动作是否连续,以及评分能否反向传播。
2. 语义、感知偏好与运动学规则
奖励的数学形式取决于希望观察的属性。对于文本与动作的语义一致性,可以将文本与动作编码到共同空间,以余弦相似度评分:
文本运动检索器通过匹配与非匹配配对学习这一空间。TMR 学习的跨模态表示可作为语义奖励。高相似度表示生成动作在该检索器中接近描述,并不说明每个时间区间、身体部位或动作次数都正确。全局 pooling 可能弱化局部短语的贡献,检索器也可能偏好数据中常见的运动外观。
感知偏好涉及自然度与流畅性等难以由语义相似度充分表征的属性,通常通过成对比较采集监督。例如,观察者在相同文本下选择更加自然的两段动作之一。这类数据可训练标量感知评分器,MotionCritic 利用 MotionPercept 中的人工比较学习相应的感知排序。比较时是否显示文本、是否只看骨架、是否允许平局,以及观察者判断语义、流畅性还是整体质量,都会改变监督含义。
对于脚滑等几何问题,还可以用运动学规则直接评分。若接触标记为 $f_{t,j}\in\{0,1\}$,关节世界位置为 $P_{t,j}$,一种脚滑惩罚可写成
两处求和的帧范围均为 $0\leq t\leq T-2$。这里 $f_{t,j}$ 标识区间 $[t\Delta t,(t+1)\Delta t]$ 内的持续接触,penalty 的单位为速度平方。若省略 $\Delta t$,得到的是逐帧位移 penalty,其数值随采样频率变化。若把所有脚部都标为接触,规则就会错误惩罚正常摆腿。骨架接触和表面接触具有不同几何粒度;接触力进一步取决于质量、惯量及运动加速度,无法仅由静态位置确定。
除语义、感知与运动学评分外,真实性分类奖励还训练模型区分采集与生成分布。其最优分类判据由真实与生成训练分布的密度比决定,既可能利用自然运动结构,也可能依赖预处理尺度、平滑程度或生成器特有伪影。判别分数不直接观测接触反力或执行器能力,因此与动力学可行性属于不同的判据。
3. 参考策略约束与奖励最大化
评分函数确定优化方向,参考分布约束则限制策略更新的范围。只最大化某一奖励,生成器可能迅速离开已经学到的动作分布。参考策略是保留原有生成能力的冻结模型,常用其与当前策略之间的 KL 散度限制变化:
式中的两种 policy 均以同一文本 $c$ 为条件。固定文本,先在有限候选集合上推导,并施加 $\sum_X\pi(X\mid c)=1$。对每个概率求驻点,可得到
因此最优分布具有指数加权形式:
奖励提高某个动作的相对概率,参考策略决定它原本有多少概率质量。$\beta$越大,改变分布的成本越高。在连续运动空间中,求和换成积分,并要求 $Z(c)<\infty$,且候选策略相对参考分布绝对连续。只有这些条件成立,KL 正则化问题才具有上述指数倾斜解。
指数重加权保持参考分布的支持集:参考策略概率为零的候选,无法仅通过指数加权获得正概率。实际神经网络的支持集往往更复杂,低概率的优质模式仍难以通过有限采样充分覆盖。优选数据与当前生成样本的来源安排,会影响这种模式能否参与训练。
将参考约束落实到不同生成器时,动作 token 模型可直接累加条件 log-probability,扩散模型则更容易约束反向路径分布。设两策略共享初始噪声分布,反向转移核为 $p_\theta^{(k)}$ 与 $p_{\mathrm{ref}}^{(k)}$,记最终 clean motion 的边缘分布为 $\pi_\theta^{(0)}$ 与 $\pi_{\mathrm{ref}}^{(0)}$。KL 的链式分解与边缘化的数据处理不等式给出
在 $\mathcal K_k$ 中,两种转移核均以当前状态 $X^{(k)}$ 为条件,并隐含共同文本条件 $c$。右侧约束完整采样路径,左侧仅约束最终动作;两者通常不相等。对于具有相同正定协方差 $\Sigma_k$ 的高斯核,单步 KL 为 $\tfrac12\|\mu_\theta-\mu_{\mathrm{ref}}\|_{\Sigma_k^{-1}}^2$。普通去噪 MSE 只有在相应方差、噪声权重和状态分布条件下才能对应这种路径约束;确定性采样核不适用该高斯密度公式。
4. 成对偏好与直接偏好优化
绝对质量分数往往难以标定,相同条件下的成对选择更容易获得。Direct Preference Optimization(直接偏好优化,DPO)利用这种比较调整生成概率。给定同一文本下的优选动作 $X^w$ 和劣选动作 $X^l$,Bradley–Terry 模型先把选择概率写为
由上一节可反解奖励为
同一文本的成对差值会消去 $Z(c)$,因此可以直接用生成策略拟合偏好:
这里优化的是相对参考策略的概率比差值。参考项扣除了预训练策略已有的相对倾向,使更新针对新增偏好信号。DPO 不需要在每轮更新中显式训练价值网络,它利用成对关系改变相对生成倾向。
对 $\Delta_\theta$ 的导数为 $-\beta\sigma(-\beta\Delta_\theta)$。已经满足的偏好对产生较小梯度,与当前排序相反的偏好对产生较大梯度;该机制同样放大错误偏好标签的影响。DPO 中的参考概率比来自 KL 正则化最优策略的重参数化,但有限偏好数据上的经验 DPO 损失不等于显式执行一个固定 KL 半径约束。尤其当偏好关系完全可分时,仅重复同一比较仍可持续增大 log-odds。
三类别偏好优化算例把三个抽象候选表示为三个 logit,反复提供“候选0优于候选1”的偏好。概率曲线展示偏好优势与参考分布差异的变化;未被比较的第三候选也会受到归一化影响。
1 | import numpy as np |
运行结果:
1 | initial probabilities: [0.4 0.35 0.25] |
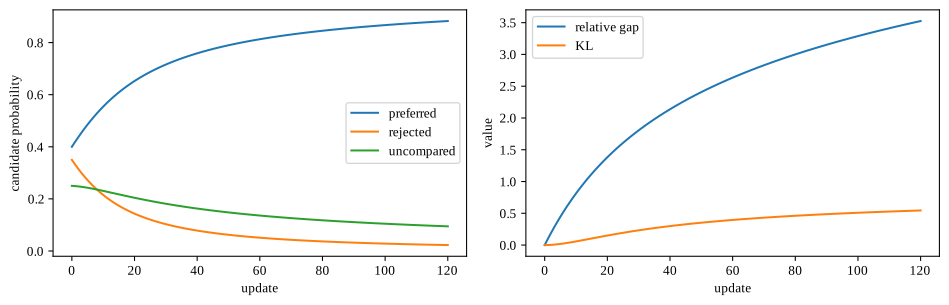
该算例的偏好图仅含边 $0\succ1$,候选2与其余候选之间没有可识别的排序关系。softmax 归一化把全部候选耦合起来,因此候选2即使没有直接监督,其概率仍从0.25降至约0.095。参考分布参与 log-odds 比较并不保证未比较模式的概率保持不变;哪些候选参与比较、何时停止优化以及是否显式约束分布,都会影响未比较候选的概率变化。
5. 扩散生成中的概率代理
上述 DPO 目标需要动作的对数概率。autoregressive token 模型可以按序列分解计算,扩散生成的最终动作概率却需要对许多中间噪声状态积分,通常难以精确计算。扩散偏好学习因此需要额外的概率代理,常通过变分界或去噪误差构造。
设优选与劣选 clean motion 在同一噪声级 $k$ 下加噪,以 $a\in\{w,l\}$ 区分偏好标签:
对噪声预测模型定义 $e_\theta^a=\|\epsilon-\epsilon_\theta(X_a^{(k)},k,c)\|^2$,并与冻结参考误差比较。以负去噪误差近似相对优势,可写为
模型相对参考更准确地解释优选动作时,$A_\theta^w$ 增大;劣选动作的相对优势降低时,成对差值也增大。由扩散变分界推导的目标还包含扩散噪声级权重,权重取决于噪声日程与预测参数化。
对于预测 clean motion 的模型,可以先把 $\hat X^{(0)}$ 转为等价噪声估计:
该恒等式适用于 $0<\bar\alpha_k<1$,其系数正是信噪比。相同 clean-motion 误差在低噪声端对应更大的噪声预测误差,因此预测参数化的转换同时改变各噪声级的优化权重。“降低优选误差、提高劣选误差”规定反馈方向,具体优化强度仍由有效帧归一化、扩散噪声级权重与参考误差共同确定。
成对使用相同噪声级和同一基础噪声,相当于使用 common random numbers;当两侧误差对共享扰动具有正相关响应时,可以降低误差差值的方差。不同长度动作必须在有效帧上聚合误差,避免长动作仅因维度更多就具有更大的总误差。采用 $X^{(0)}$-prediction、$\epsilon$-prediction 或 diffusion $v$-prediction 时,损失具有不同的噪声级权重;这里的 $v$ 是扩散参数化变量,与关节速度无关。
扩散 DPO 的一次更新包含两个分开的阶段:首先构造并排序候选,再以这些候选计算去噪偏好损失。冻结参考模型提供不随更新改变的比较基准,当前生成模型则保留梯度。在线生成偏好候选一般先在无梯度模式下完成,随后把得到的 clean motion 候选重新加噪计算成对训练损失。DPO 将这些候选视为偏好训练数据,参数梯度通过重新加噪后的去噪误差计算,而非通过候选采样历史传播。
6. Offline、Online 与 Semi-online 偏好采样
在给定偏好目标后,优选与劣选样本的采样分布决定了优化覆盖的动作模式与误差类型。Offline(离线)偏好集在训练开始前固定;Online(在线)采样随当前生成模型重新产生候选。MoDiPO 使用生成动作与 AI 反馈构造排序监督,为文本动作对齐提供成对或多候选偏好信息;它降低逐对人工比较的成本,同时也带入反馈模型的语义偏差。固定劣选样本还可能只覆盖一部分失败模式。
与固定的离线偏好集相比,在线偏好采样每轮从当前策略生成若干候选,再由奖励模型排序。它能够跟随模型当前错误更新训练集,但受当前生成分布限制:低概率的正确模式难以进入候选集合,排序模型无法为未采到的模式提供正向监督。相对排名也不对应绝对质量阈值,因此需要区分集合内的低排名与质量不足。
SoPo 的 Semi-online(半在线)结构将两种来源组合起来:配对训练集提供优选运动,当前 policy 动态提供待筛选的劣选运动。优选集合补充生成器暂时难以采到的正确模式,在线劣选则反映生成器当前的错误。给定文本,先生成 $N_c$ 个候选,再寻找低奖励结果:
离线优选来自已有配对运动,为当前模型很少生成的正确模式提供训练目标。在线候选经冻结的文字运动检索器评分,只将低于质量阈值的结果用于劣选项;如果本批候选都较好,训练仍加强优选,不对高于阈值的候选施加负向更新。半在线采样规定偏好对的来源,DPO 则规定利用偏好对更新策略的目标函数。
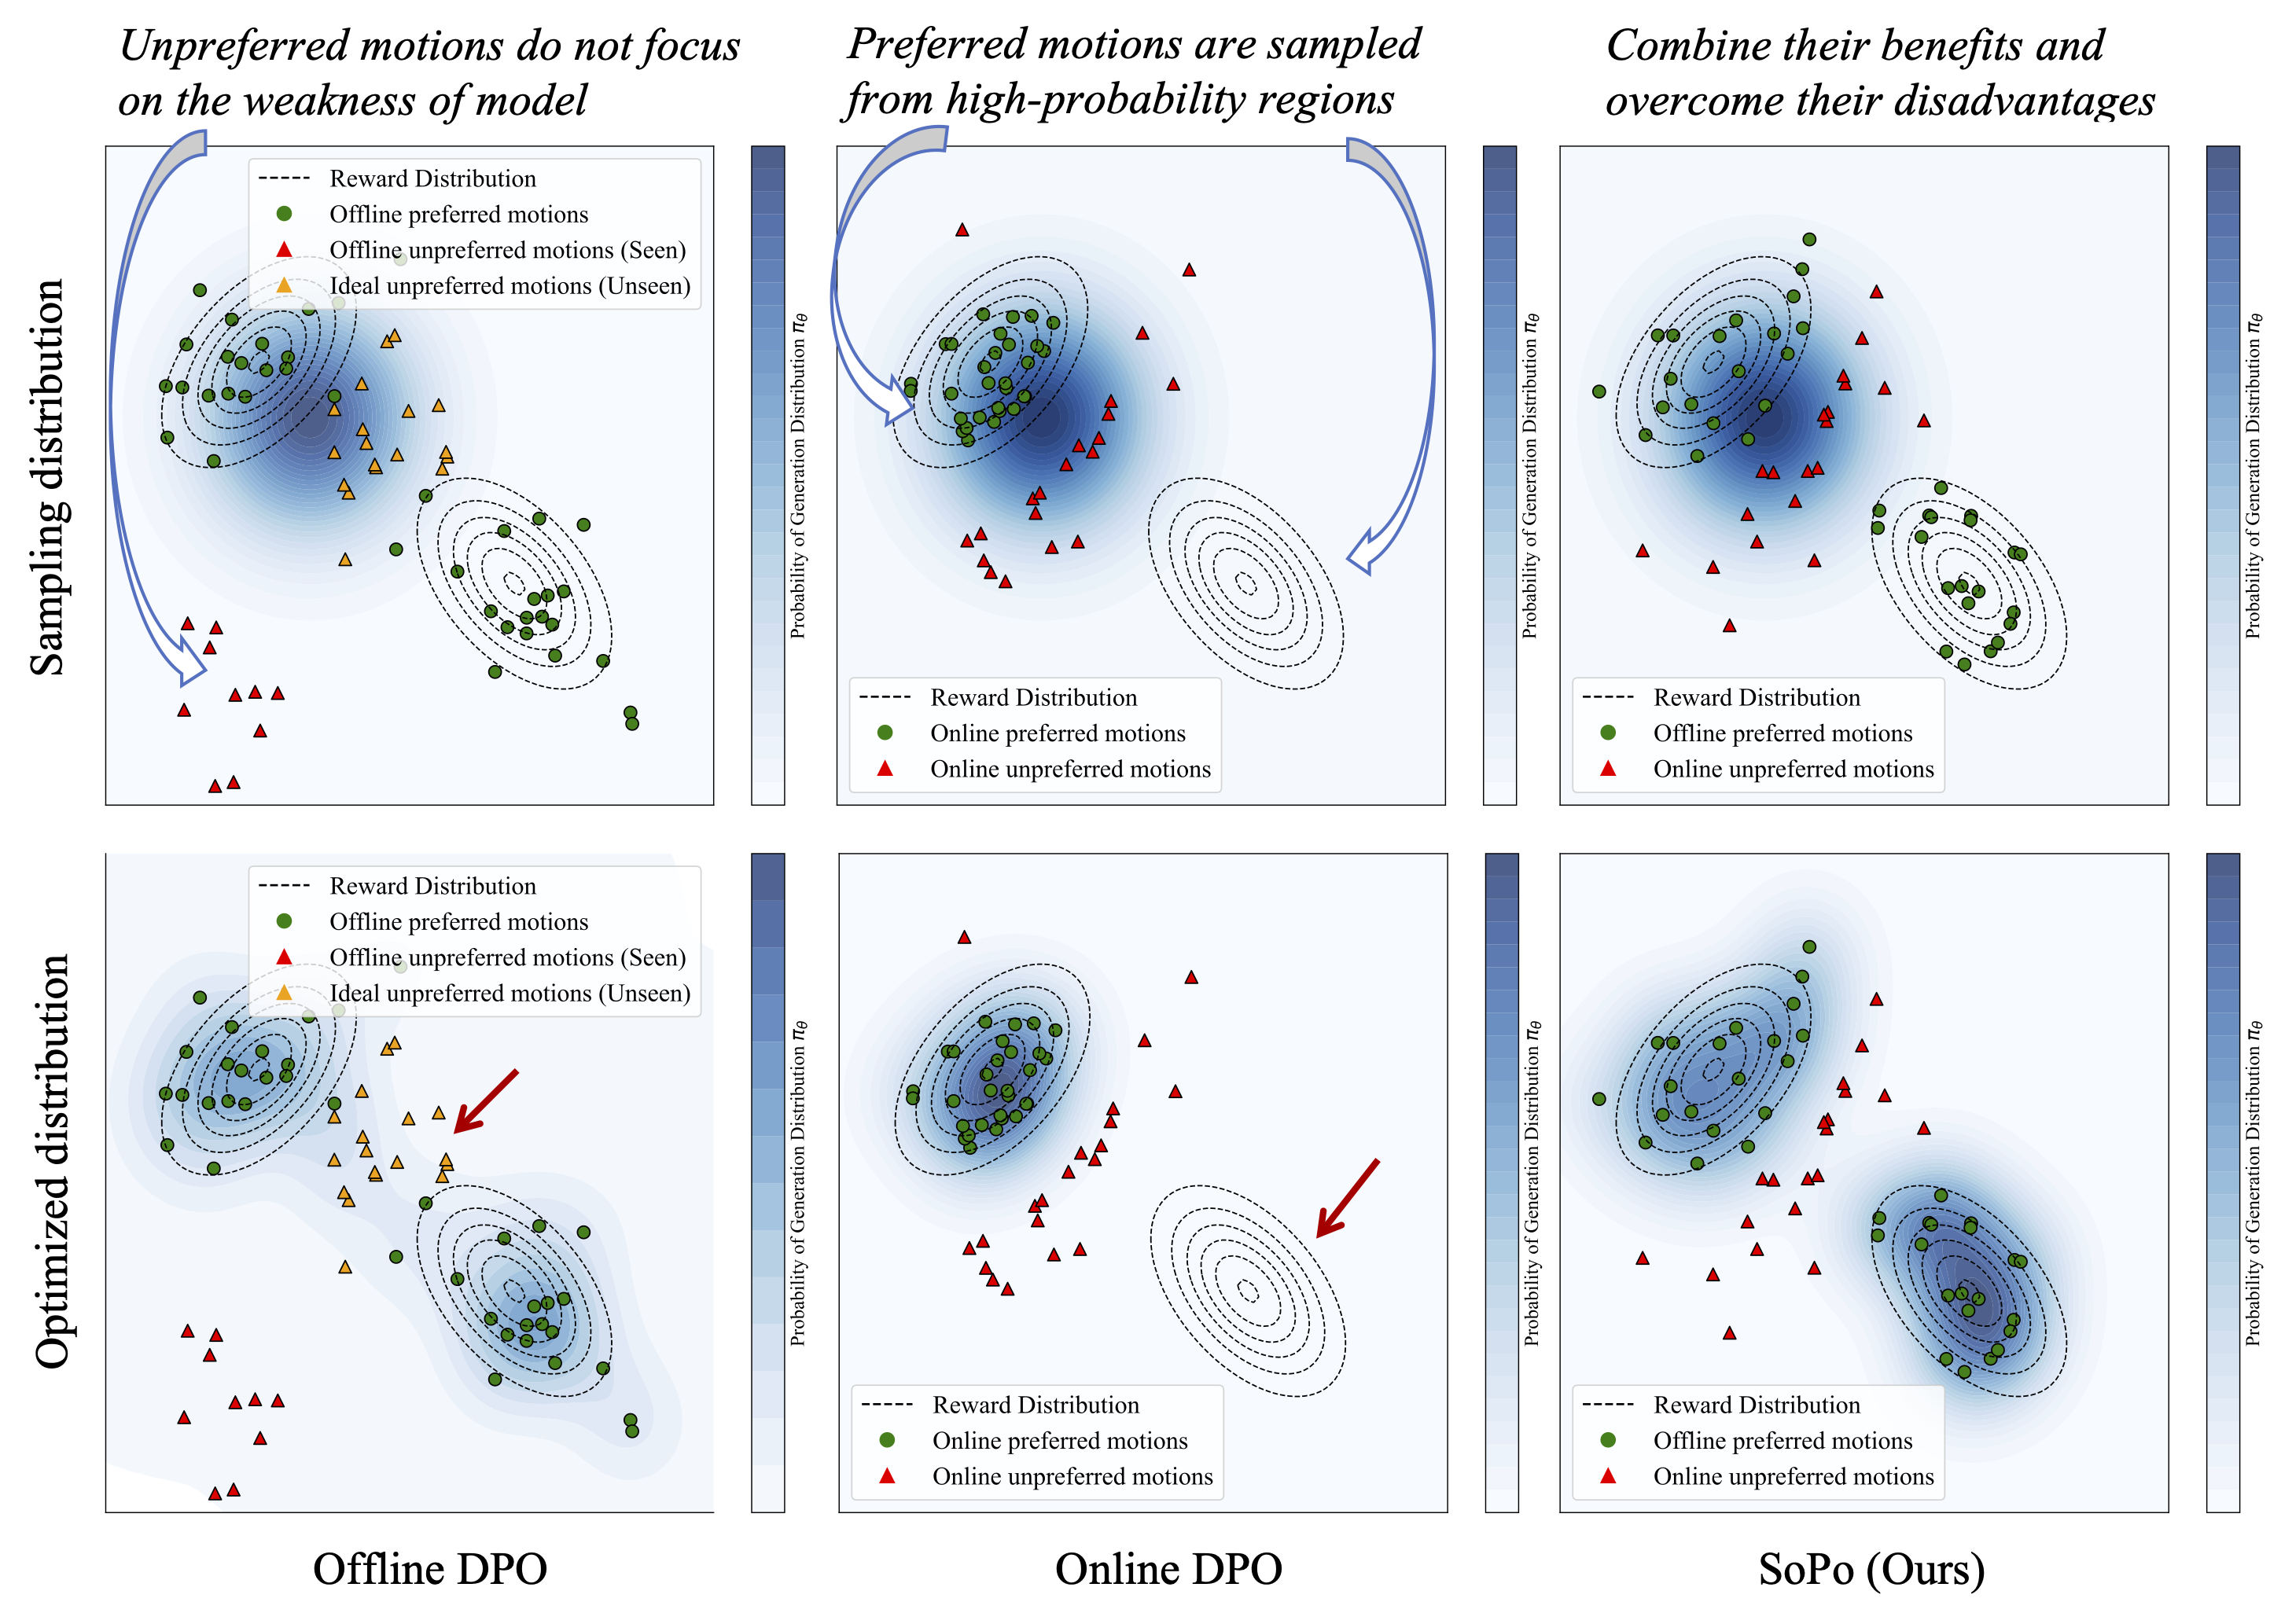
候选对象是动作序列,反馈来自语义检索,SoPo 通过去噪误差的偏好目标更新参数;它不需要 PPO 的概率比裁剪与价值网络。优化后的变化首先体现在检索器能识别的语义属性上,例如左右方向、动作顺序或被遗漏的动作阶段。
若单个候选低于阈值的概率为 $p_{\mathrm{bad}}$,在独立采样假设下,$N_c$ 个候选中至少有一个低质量样本的概率为 $1-(1-p_{\mathrm{bad}})^{N_c}$。增大 $N_c$ 提高发现尾部失败模式的概率,也将负例分布进一步偏向低奖励尾部;它改变的是样本选择分布,并非无偏估计当前策略的平均质量。阈值过高可能排斥正确模式,过低则使劣选项很少参与;离线动作与文字配对不准确,也会反复强化错误目标。Semi-online 采样扩大了监督来源,但仍无法恢复运动压缩时丢失的细节,也无法纠正 reward model 始终无法区分的错误。
以 MDM 的 HumanML3D 配置为例,偏好训练包含候选评分与去噪损失两条计算链。首先构造评分对象:离线优选为 [B,263,1,T],两个在线候选具有相同形状。转置为 [B,T,263] 后,动作与文字分别经过 TMR 编码、归一化与余弦评分,得到两个 [B] 分数;逐样本选择分数较低的候选,并建立 [B] 的阈值掩码。
随后为优选、劣选抽取扩散步,重新加噪,各自通过当前与冻结参考去噪器,得到四组有效帧均方差。令 $\delta_w=e_\theta^w-e_{\mathrm{ref}}^w$,$\delta_l=e_\theta^l-e_{\mathrm{ref}}^l$,$m_l=\mathbf{1}[r(X^l,c)<\tau]$。实现中的优选权重还依赖在线运动与优选运动的相似度 $a$,损失为
实现将余弦相似度映射到 $[0,1]$ 后用于优选权重。在线运动越偏离配对优选,$2-a$ 越大,优选监督越强;劣选项则仅在评分低于阈值时参与。阈值需要对应评分器尺度,改变检索表示便需要重新标定。当前网络接受这个重新计算的损失梯度,参考网络固定;在线采样只负责构造候选,候选采样历史不进入该损失的计算图。
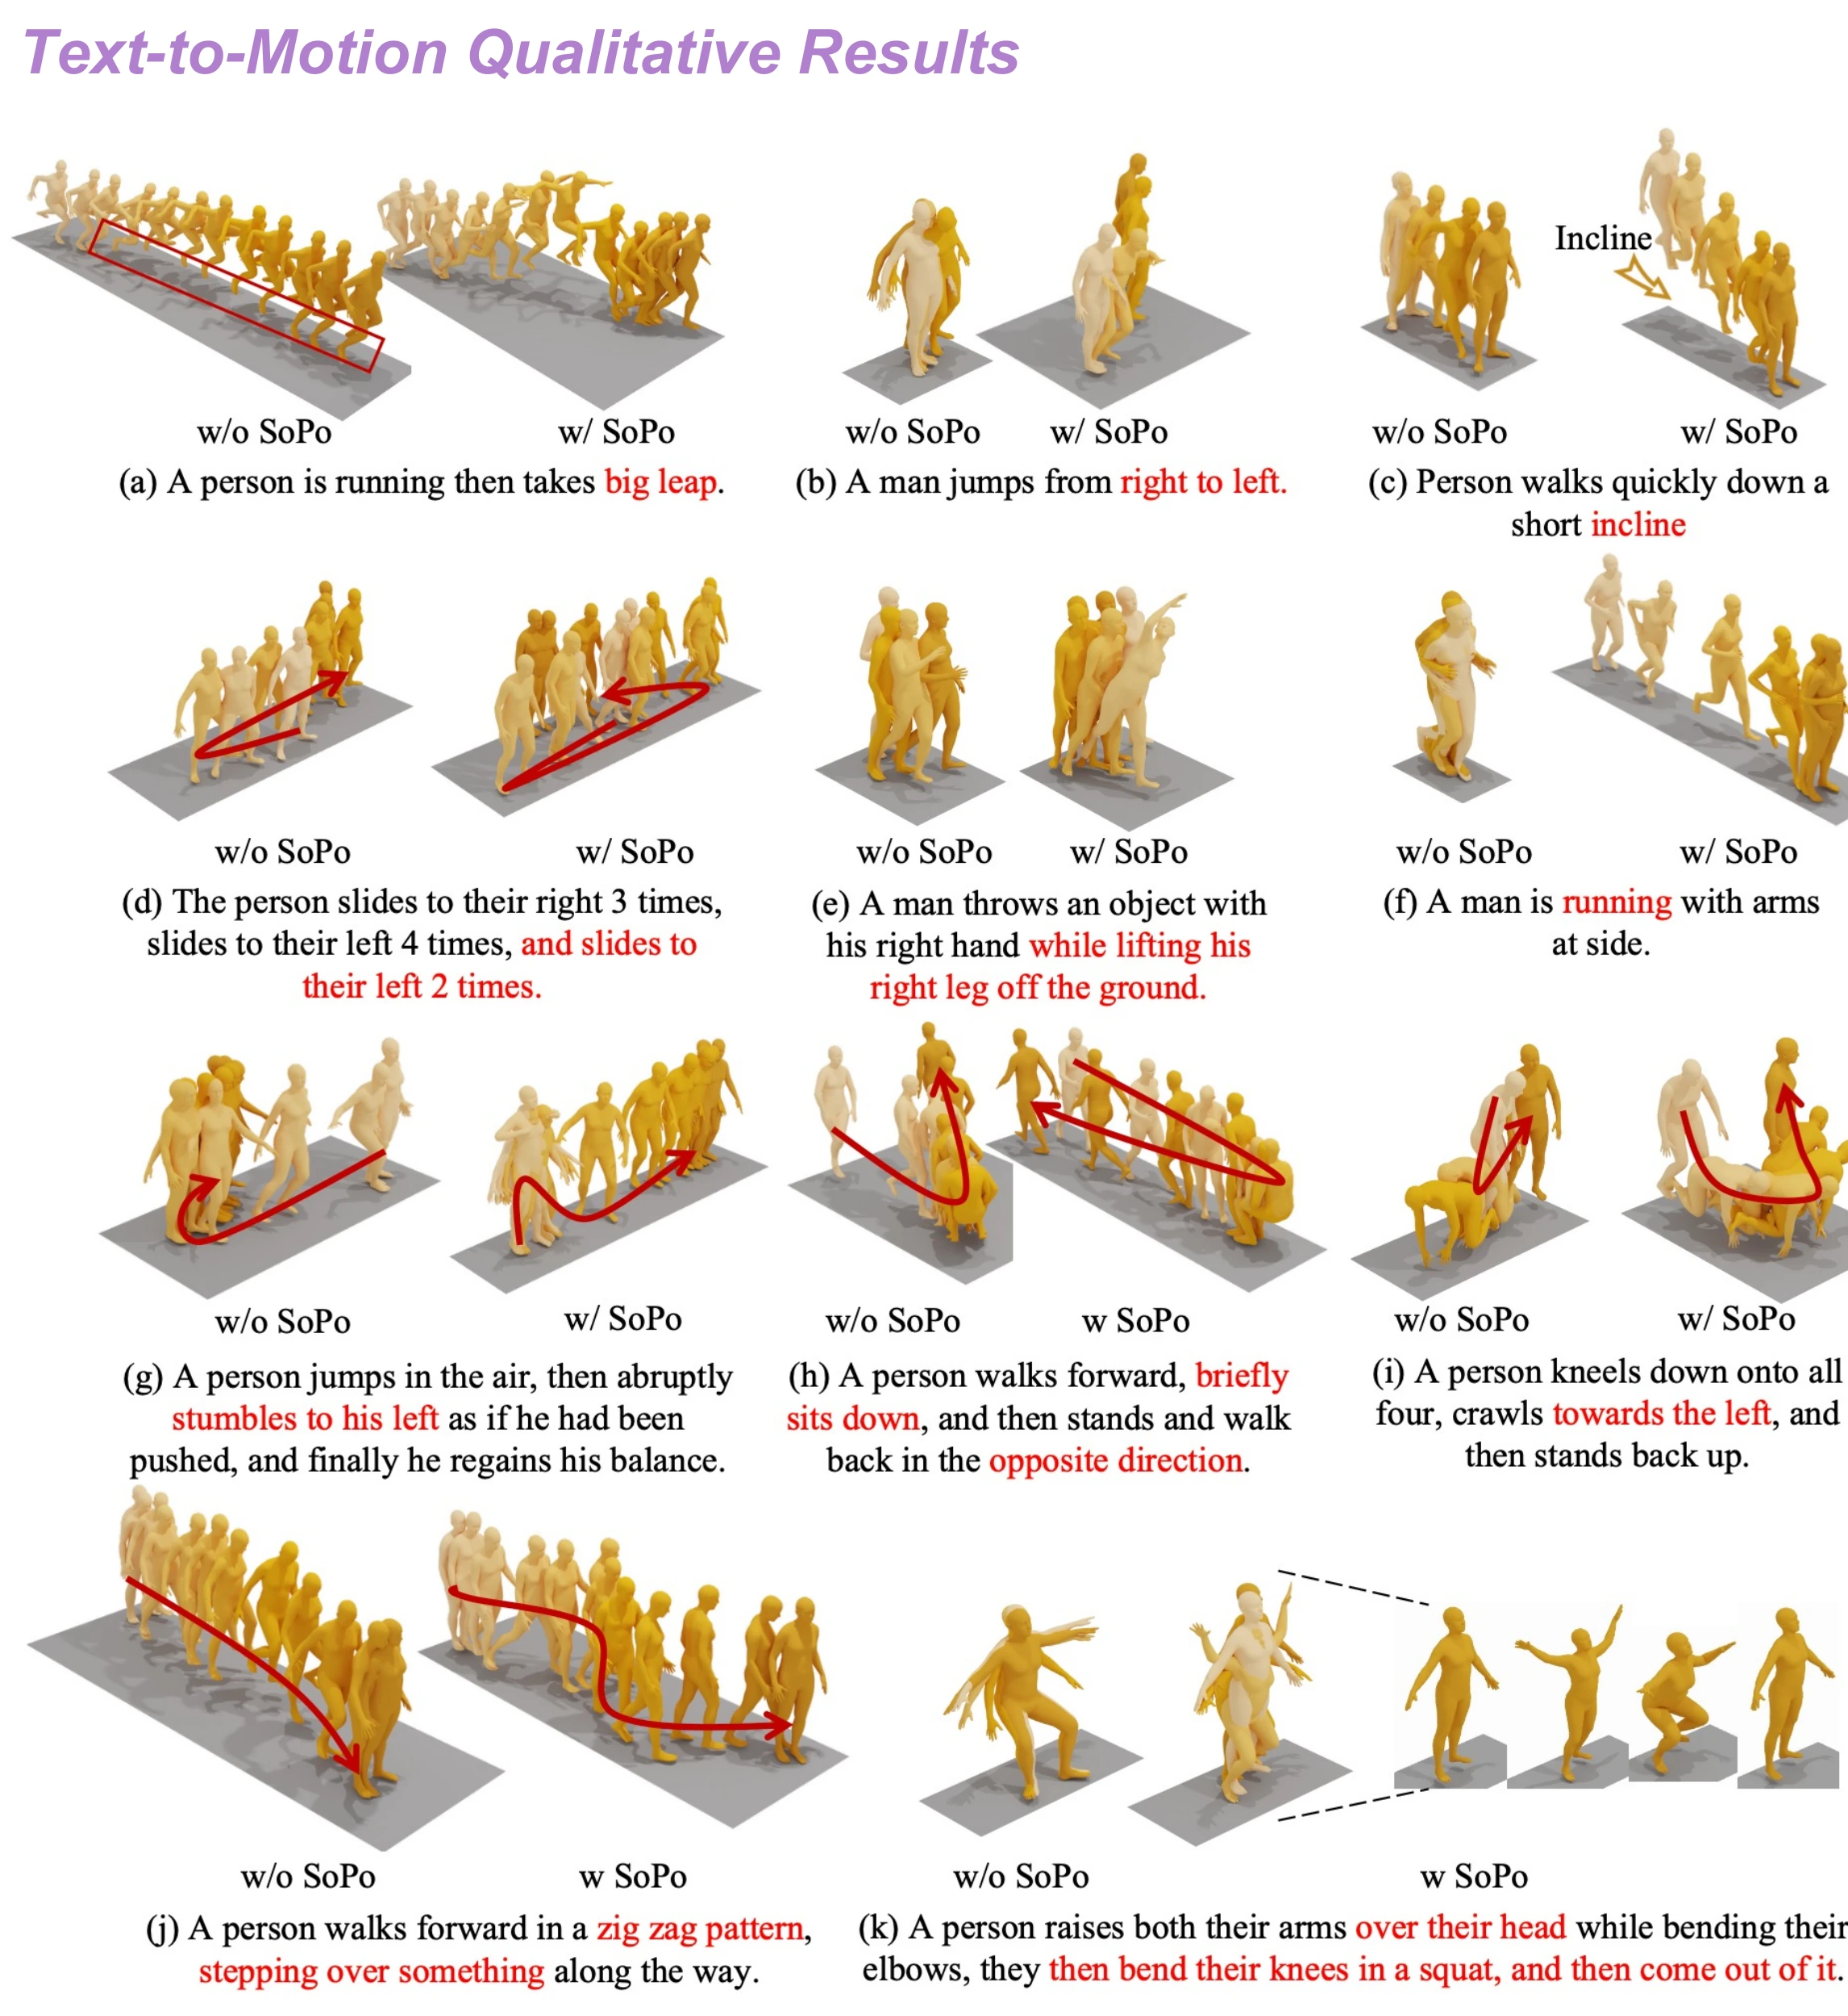
图中第一组包含跑动后的大幅跳跃,末组包含上举双臂、下蹲与恢复;它们都要求模型在同一条件中组织多个阶段。左右跳跃和爬行方向还需要结合根路径判断,单帧姿态无法提供完整依据。
7. 策略梯度与可微奖励的计算条件
成对偏好提供相对顺序,标量奖励还可以直接参与参数更新。Policy Gradient(策略梯度)利用高 reward 样本与生成概率之间的关系:如果能够计算生成样本的对数概率,可使用评分函数估计
在固定条件下,基线 $b(c)$ 不依赖本次采样动作,且在策略导数中视为常数,可保证 $\mathbb E[b(c)\nabla_\theta\log\pi_\theta(X\mid c)]=0$。未经校正的动作相关 baseline 一般会引入偏差。奖励不必对动作可微;人工偏好评分、离散碰撞判定和仿真器统计均可作为反馈。PPO 通过裁剪代理目标抑制过大的概率比更新,并常配合价值估计;裁剪目标本身不保证每个样本的实际概率比始终位于区间内。MotionCritic 采用感知偏好反馈与 PPO,体现了这条动作后训练路径。
与利用采样概率的策略梯度不同,另一条路径直接利用连续动作的导数。对于可微生成器,动作可写成 $X=G_\theta(\epsilon,c)$;若奖励也对动作可微,则可以沿生成计算链直接求导:
这种 Pathwise Gradient(路径导数)直接沿连续生成过程求导。它要求基础随机变量的分布不依赖 $\theta$,并满足交换求导与期望所需的正则性。冻结奖励参数 $\phi$ 只消除对评分器参数的更新,不消除 $\partial r_\phi/\partial X$;计算图必须保留从分数到动作再到生成参数的链路。与 score-function estimator 相比,这种梯度利用了局部动作几何,通常减少由整段标量反馈带来的信用分配方差,但无法穿过真正的离散选择。
离散动作 token 的采样、argmax 及硬量化通常不可直接求这条路径导数,需要概率梯度、连续松弛或其他估计器。连续扩散和流模型更适合可微奖励,但完整采样链的内存与递归梯度成为新的问题。生成变量的连续性、采样过程的可微性与奖励接口共同决定可用的梯度估计方式。
8. Pathwise Gradient、逐步微调与 Noise-aware Reward
可微奖励连接到了生成器输出,但扩散采样包含多次调用同一个网络。终端奖励在各次网络调用之间的梯度分配决定了计算成本与优化目标。记反向生成的一步为 $X^{(k-1)}=F_{\theta,k}(X^{(k)},c)$;随机采样时可将该步基础噪声作为固定的重参数化输入。参数对输出的影响有直接和间接两种路径,分别来自当前网络调用与输入状态传递:
若初始噪声与参数独立,则 $D_{N_d}=0$。展开递推式可得
其中空矩阵乘积为恒等映射。每项对应一次共享网络调用对终端动作的贡献,后续转移的雅可比负责传递这部分影响。奇异值连乘可能造成梯度衰减或放大;完整反传的内存需求则来自跨步保存的生成激活。
为减少历史计算图,可以采用逐步优化:将当前输入状态 stop-gradient,仅保留本次网络调用到步骤奖励的链路。
MotionRFT 将多表征评分器 MotionReward 与逐步微调 EasyTune 连接。EasyTune 在选定反向步骤中,先将输入状态 stop-gradient,再计算当前去噪输出及步骤奖励;一次参数更新完成后,下一步使用分离的状态继续采样。当前网络调用与奖励之间仍然可微,却不追溯此前整条历史。若只在最后一步保留梯度,并继续使用终端奖励,估计为 $g_{\mathrm{local}}=B_1^\top\nabla_Xr$;相对完整 pathwise gradient 省略的部分为
对固定参数与相同前向轨迹,这是明确的截断差值。EasyTune 还把终端评价换成多个噪声级的局部奖励,并在步骤之间更新参数,优化目标因而进一步改变,不能解释为同一终端目标的无偏低内存实现。步骤奖励若提供有效的局部质量梯度,则可以通过有偏但成本更低的更新改进生成分布。
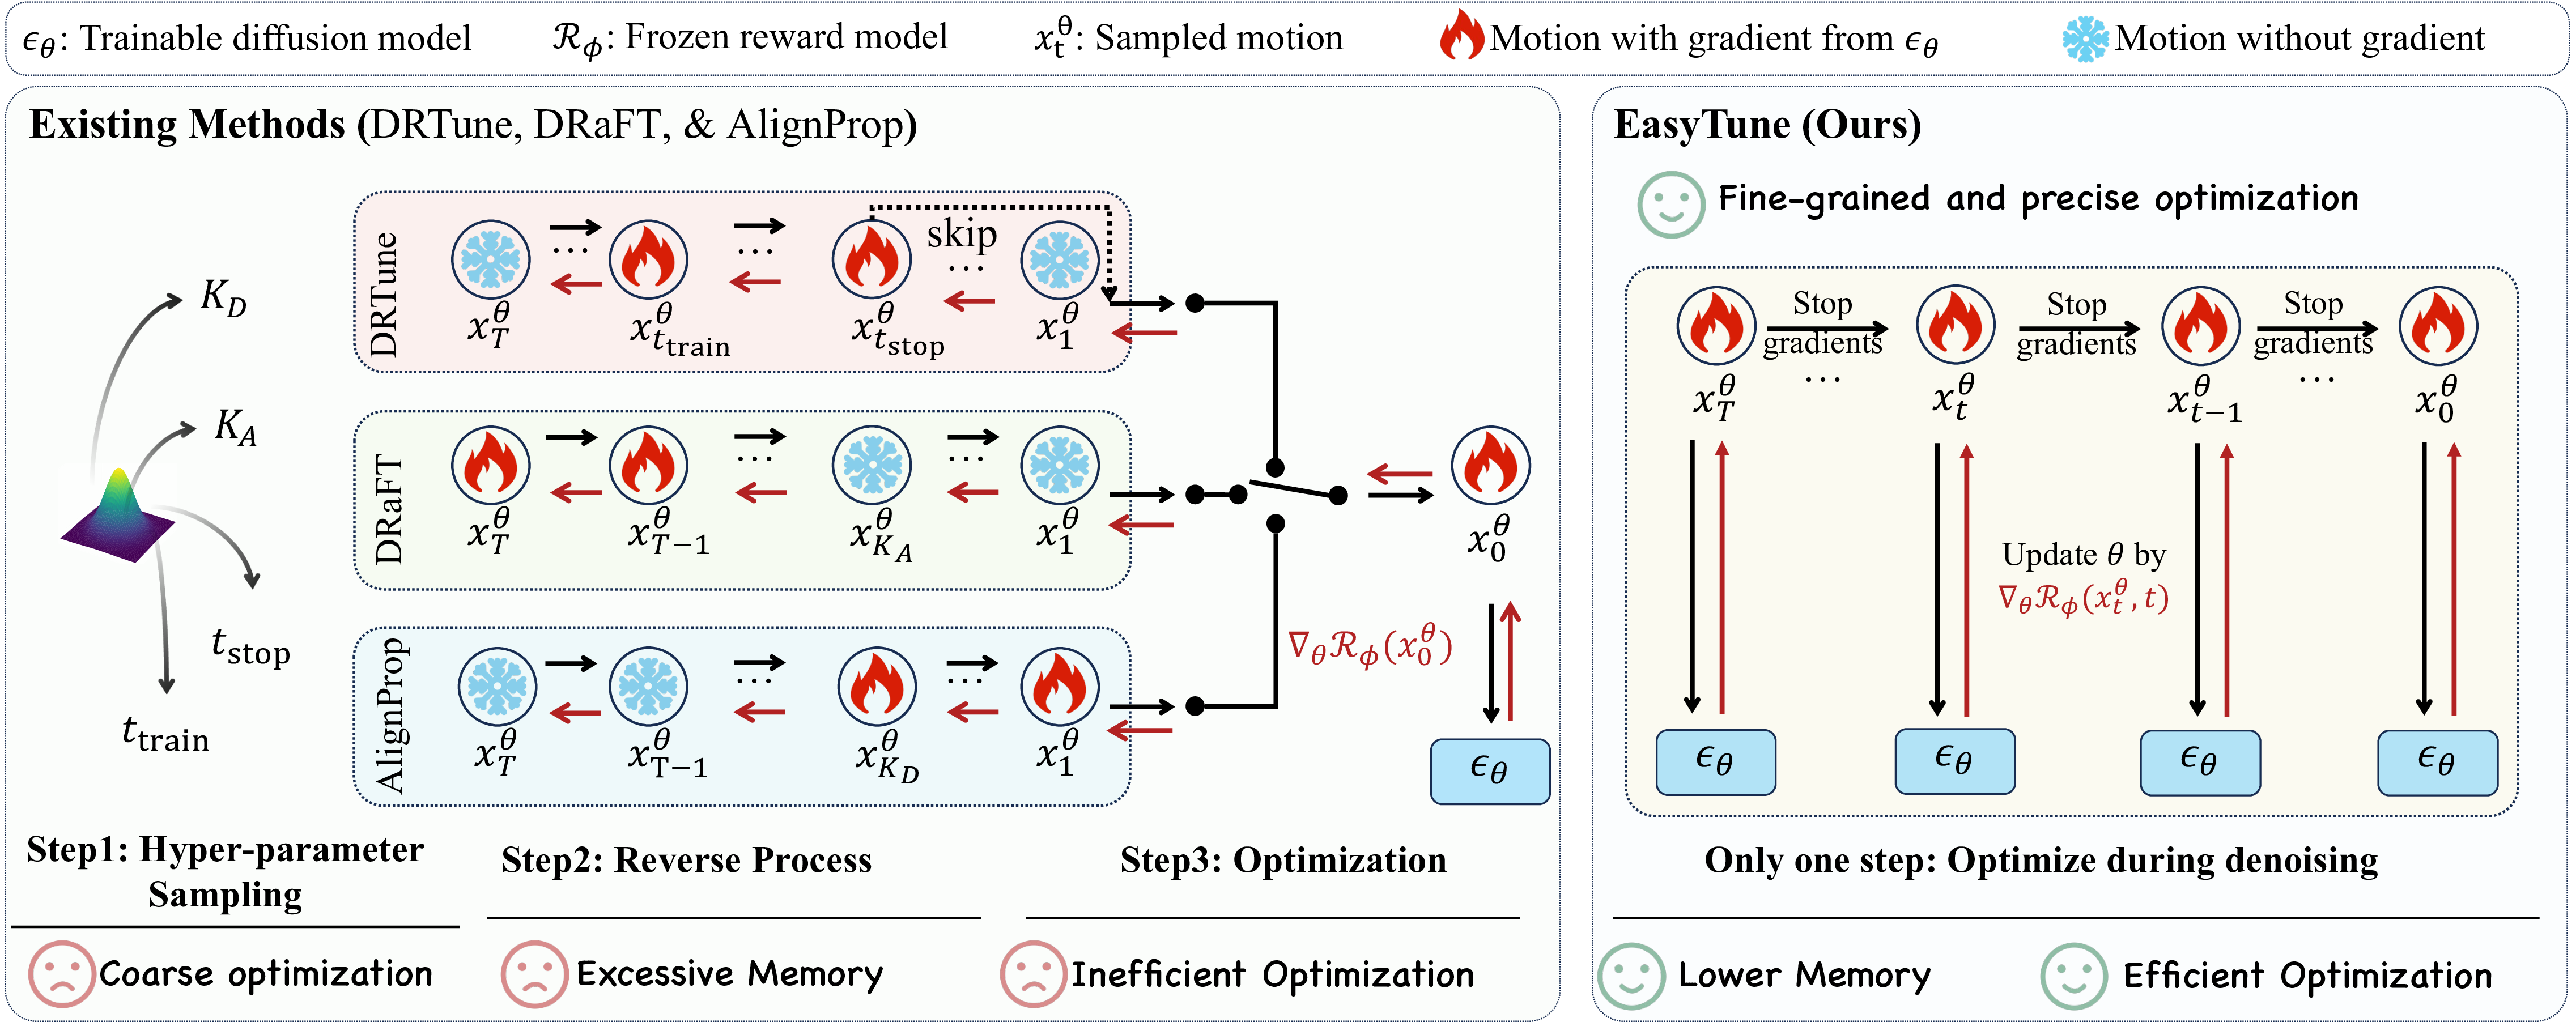
步骤奖励还需要适应输入噪声。直接把很强的噪声运动送入只见过 clean motion 的评分器,会产生明显的分布偏移,使评分及其梯度偏离训练时的质量含义。Noise-aware Reward(噪声感知评分)在训练时读取不同噪声级的动作,并将扩散步编码加入运动特征,使相同评分模型能够区分当前状态的噪声程度。另一种接口先从当前状态估计 clean motion,再用面向 clean motion 的评分器计算代理奖励;前者学习含噪状态的评价,后者借助生成器的预测建立评价对象。
若生成器在 Latent Space 中工作,步骤奖励还需经过运动解码链。去噪状态 [B,K_z,d_z] 经当前网络与采样器得到下一潜变量,运动 VAE 解码为 [B,T,D];表示专用投影、运动编码器与奖励头进一步产生 [B] 分数。微调固定 VAE 和评分器参数,却保留它们对输入的梯度,才能把奖励传回潜变量去噪器。若动作由 $X=\mathcal D(z)$ 解码,则潜变量收到的反馈为 $\nabla_zr=J_{\mathcal D}^{\top}\nabla_Xr$。奖励要求的变化若落在解码雅可比像空间之外,局部潜变量更新便无法实现;如果固定解码器的表示能力不足,后训练也无法仅靠 latent 更新产生缺失的运动细节。帧空间模型省去 VAE,旋转或关节生成器则使用相应投影入口。
逐步优化可进一步使用噪声区间上的课程调度。课程调度先在高噪声窗口优化整体结构,再随训练进展将窗口移到低噪声区间,最后集中修正局部细节。窗口内步骤保留当前调用的梯度,窗口外继续完成采样而不保存训练图。该调度将参数更新集中到当前课程对应的噪声区间,并通过噪声感知评分提供局部监督。
六步标量生成链算例用迭代索引 $j$ 定义 $y_j=\theta^j y_0$;代码中的 x0 表示该链的初值,与 clean motion 或物理第0帧无关。六次共享参数调用的完整导数为 $6\theta^5y_0$,分离前五次状态后仅余 $\theta^5y_0$。两条路径前向值相同而导数相差六倍,展示了计算图截断与前向数值误差的本质区别。
1 | import numpy as np |
运行结果:
1 | same forward value: True |
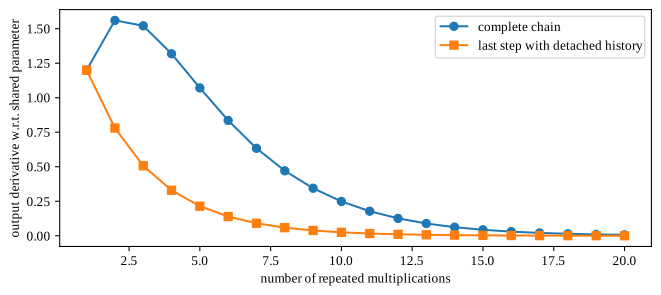
算例的完整导数为 $j\theta^{j-1}y_0$,局部导数为 $\theta^{j-1}y_0$。当 $|\theta|<1$ 时,两者均在足够长的链上趋近于零,但其比值仍为 $j$;长链梯度衰减与截断偏差是两种不同现象。若一般矩阵链中各项方向互相抵消,截断还可能改变梯度方向,而不只是缩小幅度。逐步 reward 与课程窗口改变了哪些网络调用接受监督;能够改善多少最终运动质量,还取决于中间状态的评分是否提供了有效的修正方向。
9. 多表征与多维奖励空间
步骤奖励需要适应噪声水平,共享评分器还需要适应不同运动表示。263维复合特征、135维旋转与22个三维关节具有不同的输入结构;世界位置、根朝向、骨架定义及统计量需要先建立对应。MotionReward 使用表示专用的投影入口,将不同运动格式映射到共享编码空间。
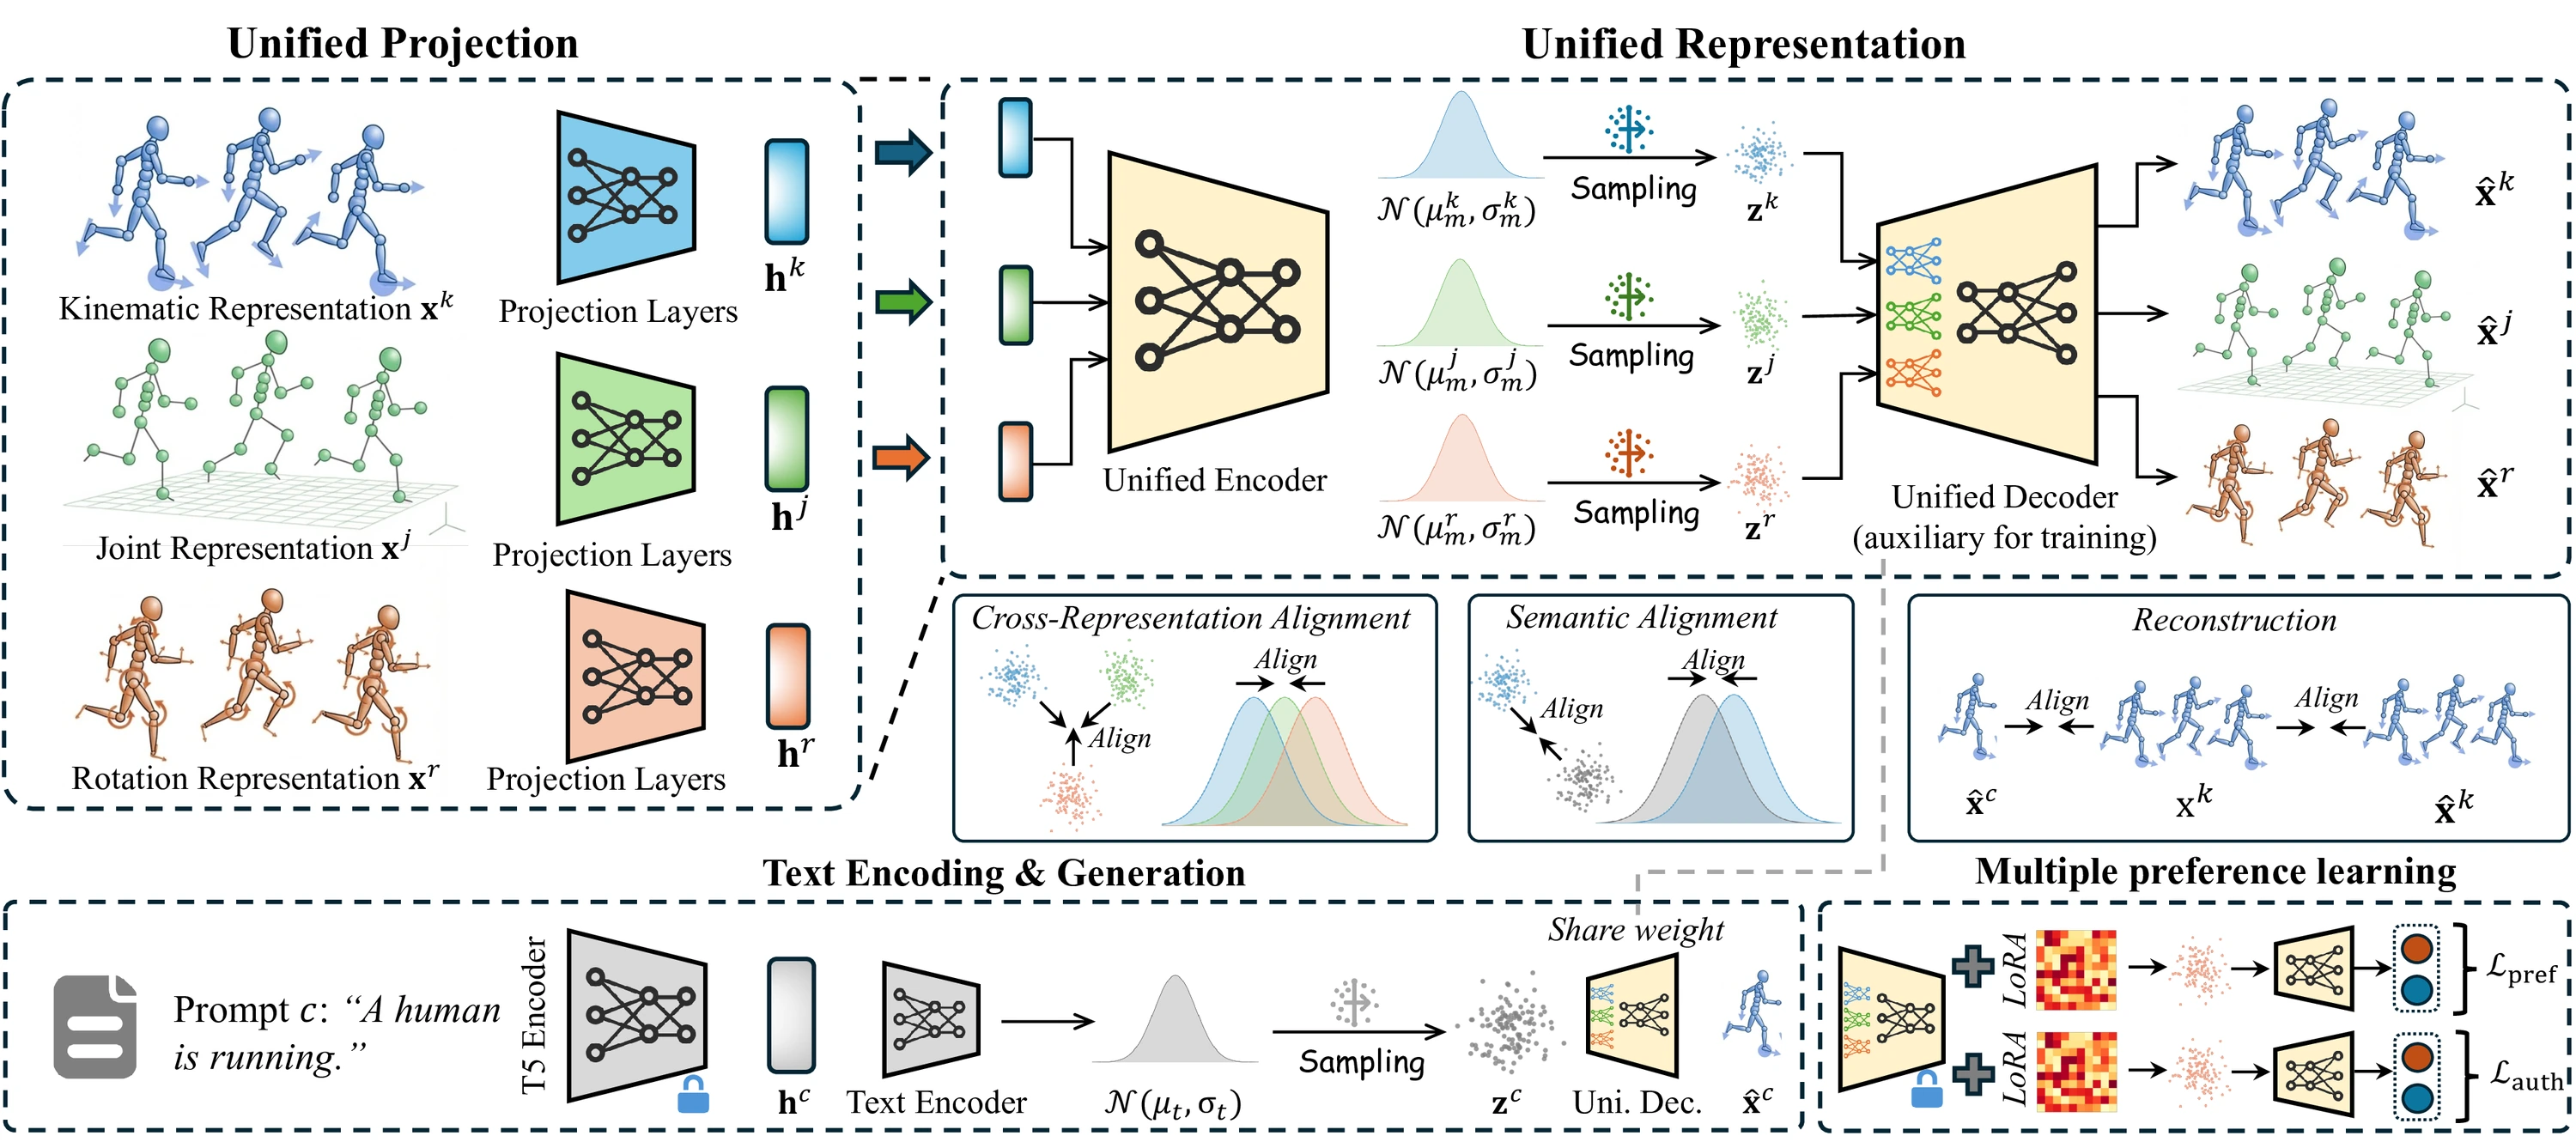
结构图区分了共享表示与任务适配两个层次。表示专用投影处理输入维度差异,统一运动编码器建立共享 Latent Space;解码分支约束运动信息保留,文本分支约束语义对应。右下角的 LoRA 与输出头分别引入感知排序和真实性监督。
记表示类型 $o$,输入 $X^o$,投影为 $h^o=\phi^o(X^o)$。263维复合特征输入为 [B,T,263],关节位置为 [B,T,22,3],旋转配置为 [B,T,135];各入口保留各自预处理与统计,将它们映射到 [B,T,H] 的共享特征。序列长度生成有效掩码,扩散噪声级 Embedding 为噪声感知编码提供条件。共享运动编码器聚合整段有效特征,得到动作潜变量;文本编码器得到相同空间中的文字潜变量。这里的运动位置编码区分物理帧 $t$,噪声 Embedding 区分扩散级 $k$,两者分别描述序列拓扑与数据退化程度,不能互相替代。
第一阶段联合学习文字动作对齐与重建。动作潜变量和文字潜变量都可以由解码器重建运动;KL 约束潜分布,潜变量距离与对比损失建立配对语义,不同表示的对应动作再接受跨表示对齐。文本对齐仍可能保留表示格式特有的统计偏差;同一运动在多个表示中的对应关系提供了额外约束。
第二阶段固定共享主干,加入感知偏好 LoRA 与标量评分头。两段同条件运动得到分数 $s_w,s_l$,以 $-\log\sigma(s_w-s_l)$ 学习优选排序。第三阶段训练真实性 LoRA 与分类头,区分真实采集和生成运动。两个适配器分别学习不同任务,评分时启用对应的适配器—输出头组合;参数量较小可以降低适配成本,监督含义仍由偏好标签与真假样本来源决定。
语义分支进一步使用 Self-refinement Preference Learning(自细化偏好学习)处理 hard negative(难负例):它从已有配对数据中挖掘模型容易误匹配的运动,再用配对关系纠正排序。对一条文字检索训练集运动,若正确配对不在前若干名,当前分数最高的错误运动成为负例,正确配对成为正例;若正确配对已经进入检索集合,则构造相同动作的平局。评分的二分类分布与优选或平局目标比较,继续强化细粒度区分。该阶段的监督来自已有配对关系与检索误差,因此学习的是细粒度语义区分;其可靠性受配对标注质量影响。
生成器微调可同时使用语义、感知偏好、真实性与相对参考动作的相似度:
相似度项限制优化结果偏离参考运动过远,约束的是编码空间中的接近程度,与完整生成分布的 KL 不同。不同奖励的数值范围决定权重含义;余弦分数变化0.01与评分头输出变化1不在同一尺度。当某一项的数值尺度或输入梯度显著更大时,它会支配参数更新,即使其他项也被赋予非零权重。更一般地,令 $g_i=\nabla_\theta r_i$,采用 $\delta\theta=\eta\sum_jw_jg_j$ 时,第 $i$ 项奖励的一阶变化为 $\Delta r_i\approx\eta\sum_jw_jg_i^\top g_j$。负梯度内积表示两个目标在当前参数邻域中冲突;统一分数尺度只能改善数值平衡,不能消除接触稳定性、语义执行与多样性之间真实存在的目标冲突。
各评分入口接收运动特征、有效长度和可选扩散步,输出 [B] 分数。语义检索使用共享对齐空间,感知评分使用偏好适配器和标量头,真实性使用分类适配器,动作相似度比较两段运动的共享 Embedding。感知适配器改变编码结果,因此计算语义余弦时需要切换回检索参数,保持相似度计算两端的编码参数一致。参考相似度的目标也需明确定义:冻结基座的输出约束生成结果的偏移,配对真实动作则提供重建式目标;两者产生的优化方向不同。
10. 奖励与生成质量的关系
优化器沿奖励梯度改变动作,对奖励梯度贡献较大的属性接受更强的更新。例如,若语义编码主要识别腿部姿态,模型可能通过夸张腿部运动提高“跑步”分数,却忽略摆臂;若接触惩罚只覆盖位移,固定双脚又可能比自然迈步获得更高分。这种 reward hacking 源于代理目标与实际质量目标的不一致:优化器可以利用评分函数未约束的自由度提高奖励。
因此,评价优化结果还需要独立信号,以观察训练奖励没有充分反映的误差。另一套语义编码器可暴露训练评分器的特定归纳偏置,按身体部位和时间阶段识别的属性可暴露整体 Embedding 遗漏的细节,足部速度与表面高度则描述接触滑动和地面穿透。若训练奖励持续提高而这些量恶化,说明优化收益没有同步覆盖相应质量维度,可能涉及目标冲突或对评分器缺陷的利用。独立指标与感知评价的共同改善,提供了优化收益向其他质量维度迁移的证据。
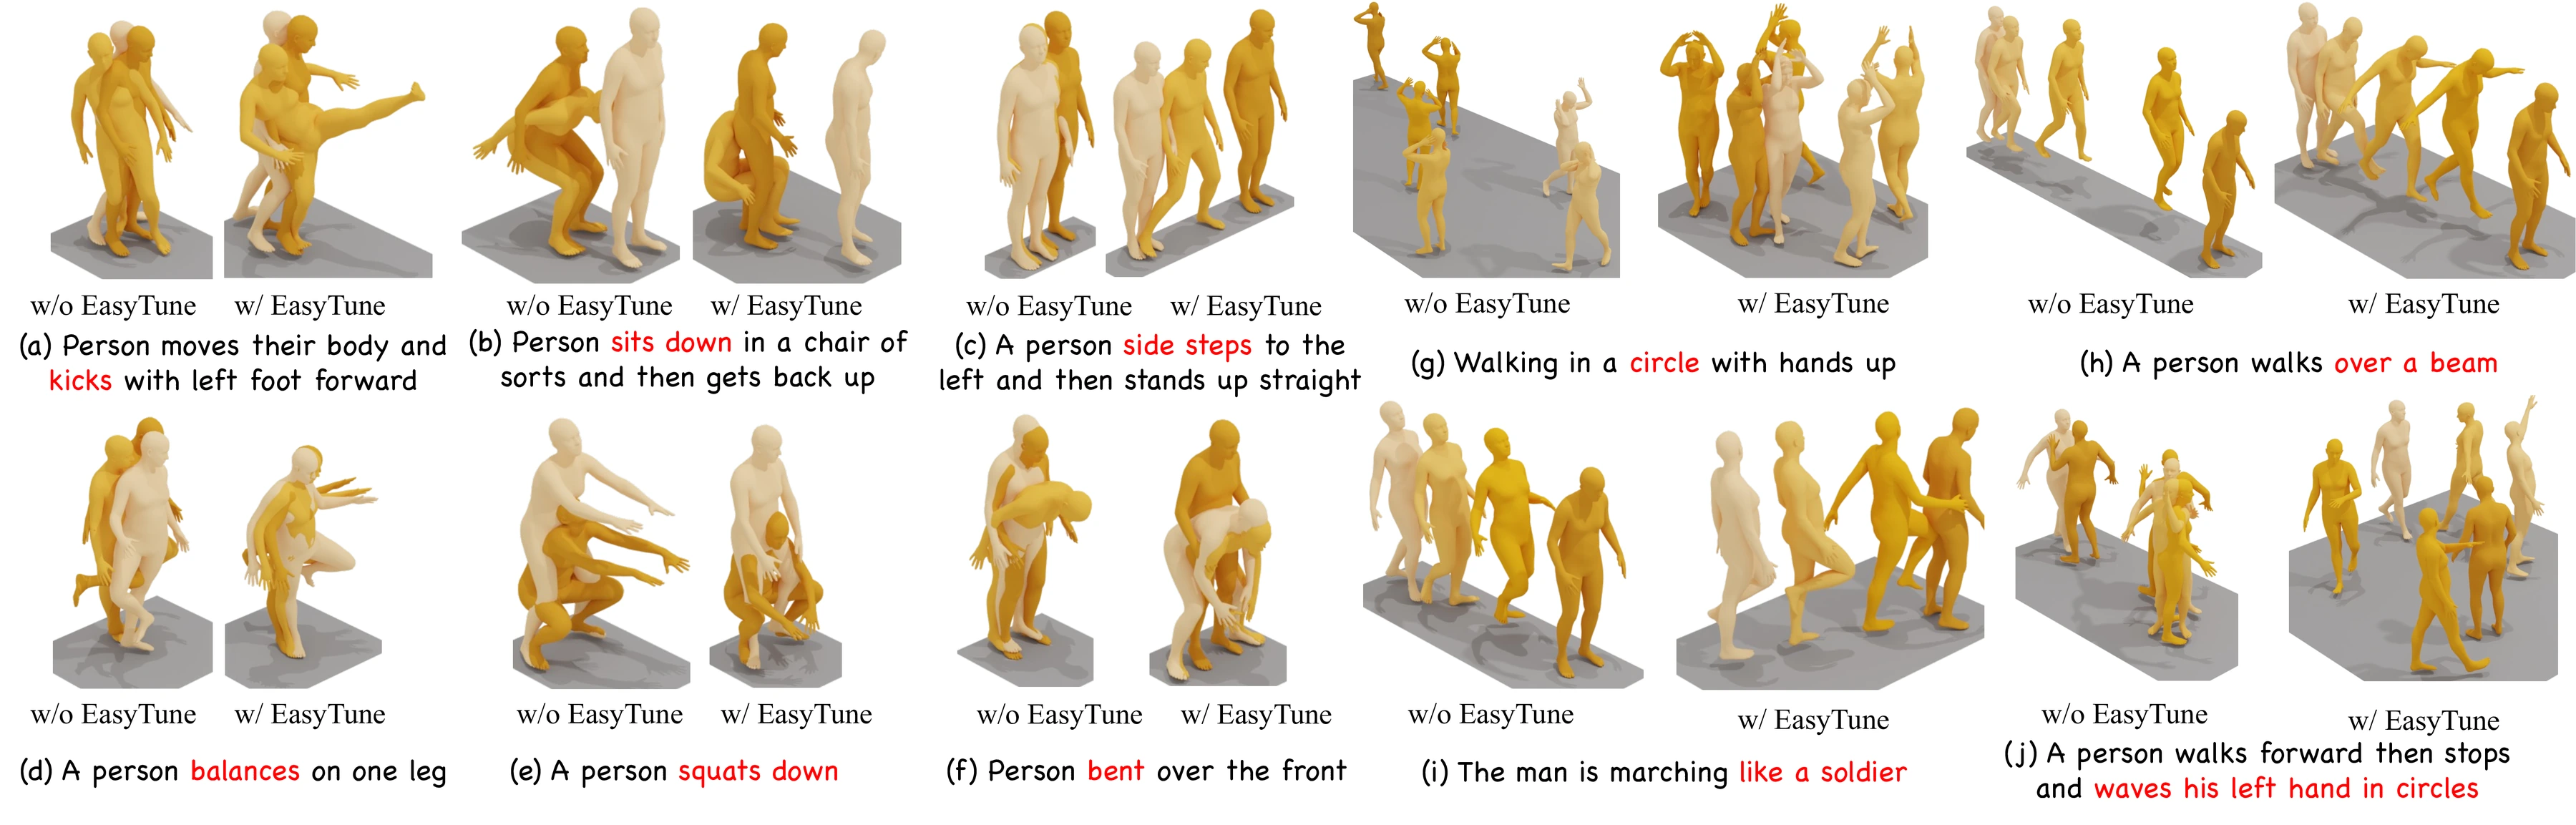
对照中的局部差异集中在文本指定的运动属性,例如踢腿幅度、坐下阶段和单脚支撑。多阶段示例还涉及动作先后关系;人体序列使这些差异具备几何依据,语义评分则提供相应的优化信号。
奖励最大化还会改变同一文本下各运动模式的概率质量。若某一速度或姿态模式持续获得更高奖励,优化可能使输出分布向该模式集中,减少路径、节奏和风格的变化。从指数倾斜解可见,对两个离散候选,奖励差 $\Delta r$ 会使相对参考概率比乘以 $\exp(\Delta r/\beta)$;当温度 $\beta$ 过小或评分差被高估时,原本合理的低分模式也可能失去大部分概率质量。质量与条件熵因此不能由一个平均分同时刻画。参考策略约束限制分布偏移,覆盖多个合理模式的优选数据则补充优化中缺失的条件支撑。
用于人体动画的感知评分与机器人执行目标也有不同观察范围。人体表面可以呈现自然姿态,硬件仍可能缺少相应关节范围或力矩;接触几何一致时,执行器带宽和支撑力仍会影响动作能否完成。将这些执行变量接入奖励,需要动力学状态、控制输入与环境反馈,并将生成目标扩展到动力学可执行性。
参考资料
Rafael Rafailov, Archit Sharma, Eric Mitchell, Stefano Ermon, Christopher D. Manning, and Chelsea Finn. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. In Advances in Neural Information Processing Systems, 2023.
Bram Wallace, Meihua Dang, Rafael Rafailov, Linqi Zhou, Aaron Lou, Senthil Purushwalkam, Stefano Ermon, Caiming Xiong, Shafiq Joty, and Nikhil Naik. Diffusion Model Alignment Using Direct Preference Optimization. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2024.
Massimiliano Pappa, Luca Collorone, Giovanni Ficarra, Indro Spinelli, and Fabio Galasso. MoDiPO: Text-to-Motion Alignment via AI-Feedback-Driven Direct Preference Optimization. Frontiers in Computer Science, 8:1707808, 2026.
Xiaofeng Tan, Hongsong Wang, Xin Geng, and Pan Zhou. SoPo: Text-to-Motion Generation Using Semi-Online Preference Optimization. In Advances in Neural Information Processing Systems, 2025.
Haoru Wang, Wentao Zhu, Luyi Miao, Yishu Xu, Feng Gao, Qi Tian, and Yizhou Wang. Aligning Human Motion Generation with Human Perceptions. In International Conference on Learning Representations, 2025.
Xiaofeng Tan, Wanjiang Weng, Haodong Lei, and Hongsong Wang. EasyTune: Efficient Step-Aware Fine-Tuning for Diffusion-Based Motion Generation. In International Conference on Learning Representations, 2026.
Xiaofeng Tan, Wanjiang Weng, Hongsong Wang, Fang Zhao, Xin Geng, and Liang Wang. MotionRFT: Unified Reinforcement Fine-Tuning for Text-to-Motion Generation. arXiv preprint arXiv:2603.27185, 2026.
Mathis Petrovich, Michael J. Black, and Gül Varol. TMR: Text-to-Motion Retrieval Using Contrastive 3D Human Motion Synthesis. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 9488–9497, 2023.
Resources
- Diffusion-DPO implementation.
- SoPo implementation:
train/training_loop.pyanddiffusion/gaussian_diffusion.py. - MotionCritic implementation, TMR implementation, and EasyTune implementation.
- MotionRFT implementation and numerical examples.
Figure credits
- SoPo synthetic distributions: Figure 3 of arXiv v3, author project, CC BY 4.0. Motion comparisons: Text-to-Motion Qualitative Results panel from the author poster.
- EasyTune gradient paths, MotionReward architecture, and EasyTune motion comparisons: MotionRFT author project. Original method labels and comparison pairs are retained.