CH-04 动作生成的细粒度控制与编辑
文本驱动的生成器能够产生符合整体描述的运动,具体制作任务却常要求更精确的空间与时间安排。例如,“边走边挥手”并未规定人物经过的位置、挥手开始的时刻或下肢姿态;若要求人物在第2秒抬起右手,同时保留已有动画的行走节奏,仅检验整体动作类别是否匹配,便无法判断这些局部要求是否得到满足。这里的困难源于条件的粒度:句子级语义约束一类动作,局部制作要求则作用于特定关节、时间区间或已有轨迹。
为表达这些要求,可控动作生成在整体语义之外引入位置、时间和身体部位等局部条件;动作编辑进一步给定原运动,并要求未编辑区域尽量保持。三维轨迹提供可测量的位置目标,局部语言指定部位与时序属性,pose code 将身体关系组织为可解释类别。相应方法通过采样时的几何指导、学习型控制分支或表示空间中的局部修改,将这些条件接入运动生成过程。控制条件需要明确包含位置、部位和时间中的哪些信息;未指定自由度如何变化,还取决于人体关节之间的耦合与生成器学习的运动分布。
1. 控制条件与编辑目标
设动作 $X\in\mathbb{R}^{T\times D}$,全局文本为 $c$,额外控制为 $C$。物理帧索引为 $t\in\{0,\ldots,T-1\}$,采样步长为 $\Delta t=1/f$;离散扩散噪声级采用 $k\in\{0,\ldots,N_d\}$,同一噪声级仍包含全部 $T$ 帧。条件分布扩展为
要让控制条件可计算,需要同时规定目标值和它的作用范围。几何控制可写成目标 $Y_{t,j}\in\mathbb{R}^3$及有效掩码 $M_{t,j}\in\{0,1\}$。观测掩码区分“无约束”与“坐标为零”,帧率确定帧索引与物理时间的对应。控制条件只有在关节编号、坐标系和时间基准一致时,才能形成明确的几何目标。
语言控制可写成一组 $(b_i,[a_i,e_i),u_i)$,分别表示身体部位、时间区间和局部描述。例如,一项局部控制可以限定右臂在1.0–1.5秒内“肘部伸直并抬到肩高”。区间采用左闭右开约定,避免相邻片段边界重复分配;无法确定精确边界的自然语言还需要额外的时间解析或人工输入。
与仅给定控制条件的生成任务相比,编辑还要给定原动作 $X^{\mathrm{src}}$和编辑区域 $E$。优化目标包括满足新条件,以及在 $\overline{E}$上保持原运动:
特征轴 $d$与真实身体部位之间必须正确对应。根平移影响所有全局关节位置,因此“仅改右手”未必能通过一组独立特征切片实现;若目标超过手臂可达范围,身体可能必须移动。保留条件与可达性由此发生冲突,需要明确允许改变哪些自由度。若用几何恢复映射 $\mathcal G$、等式约束 $h$ 与不等式约束 $g$ 定义可行集合
严格满足控制条件时,生成分布的 support(支撑集,即可能生成样本的集合)必须位于 $\mathcal F_C$ 内。soft conditioning(软条件注入)让网络读取 $C$,penalty(惩罚项)提高违反约束的损失;仅采用这两种设计,仍不能保证每个样本都满足控制要求。接触、关节限位和保持约束之间若存在矛盾,$\mathcal F_C$ 还可能为空。
2. 世界坐标与动作特征的耦合
目标通常由操作者在世界空间中指定,生成器通常输出经过坐标规范化和统计标准化的动作特征。评价世界空间约束前,需先恢复相应的几何量。许多单人动作表示采用根相对位置、根速度和相对朝向,全局关节位置由根轨迹与局部姿态组合:
具体而言,根位置 $r_t$可能由速度累计恢复,朝向 $R_t$可能由转角增量累计恢复。于是第 $t$帧手腕的全局位置不仅依赖该帧的手腕特征,还依赖此前根运动。直接替换当前帧局部坐标,不保证满足指定的世界坐标。
若采用旋转表示,局部关节位置还依赖前向运动学。记统计标准化特征为 $\xi$,物理运动变量为 $q$,恢复映射为 $q=\mathcal R(\xi)$,则世界位置残差 $e=P(q)-Y$ 的梯度满足
$J_P$ 将肩、肘、躯干与根变量耦合到同一末端位置;$J_{\mathcal R}$ 进一步包含反标准化与根速度积分。以世界坐标线速度积分 $r_t=r_0+\Delta t\sum_{i=0}^{t-1}v_i$ 为例,$\partial r_t/\partial v_i=\Delta t I$ 对所有 $i<t$ 非零。因此某一帧的位置约束会沿积分链影响其前缀,空间局部性并不等于特征时间轴上的局部性。
几何误差可定义为
目标单位必须与恢复后的关节位置一致。仅考察反标准化一步,令未归一化特征 $y=\mu+\operatorname{diag}(\sigma)\xi$,则 $\nabla_\xi L=\operatorname{diag}(\sigma)\nabla_y L$;标准化不仅改变数值范围,也改变梯度下降在物理变量中的度量。米、弧度与单位化特征的 penalty 若未经尺度标定便相加,会形成由数值尺度而非控制重要性决定的更新。
在二维运动链优化算例中,根只沿横向移动,末端通过固定长度 $l$ 的杆连接,位置为 $p=(r+l\cos\theta,l\sin\theta)$。目标误差同时产生根平移与角度梯度,因而展示位置误差经雅可比分配到不同自由度的过程。
1 | import numpy as np |
运行结果:
1 | initial_error=0.632456 |
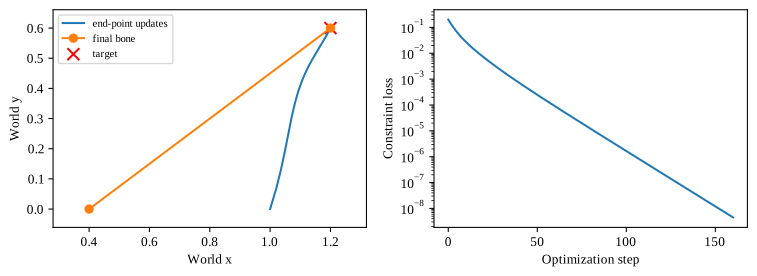
该低维系统的可达集合可以显式求出。根只沿横轴移动,因此末端高度满足 $|p_y|\leq l$;若目标高度为1.2而杆长为1,目标超出了可达集合,位置残差具有正下界。给根加入竖直平移会扩大可达范围,但也改变了原来的自由度约定。人体任务中的“允许根移动”“允许踮脚”和“必须保持足部接触”,具有同样的约束意义。
以运动变量 $q$ 的局部坐标表示微小变化,末端雅可比为 $J=\partial P/\partial q$。旋转自由度的增量属于相应切空间,不能把旋转矩阵的各元素视为彼此独立的物理自由度。对于平方位置误差,其梯度为
一阶近似将可达增量限制在 $\operatorname{Im}J$ 中。对误差 $e=P-Y$,局部最小二乘更新为 $\delta q=-J^\dagger e$,无法被一阶消除的分量为 $(I-JJ^\dagger)e$。这一残差刻画当前姿态的局部不可达方向,不等同于整个非线性系统的全局不可达性。奇异值接近零时,伪逆可能产生很大的关节变化,阻尼更新
以残差增加为代价限制更新幅度。关节限位、固定支撑脚和非编辑区域还会进一步缩小允许的切空间。增加控制权重只能改变现有方向的步长,不能增加机构自由度。
3. Analytical Spatial Guidance 与反向采样
已有恢复链可微时,位置误差便能反向作用于生成变量。Analytical Spatial Guidance(解析空间引导)利用几何损失的梯度,在每个选定采样步骤中修正动作特征,使恢复后的关节位置接近控制目标。OmniControl 将世界坐标约束加入文本条件去噪,用 $\mu_k$ 表示从噪声级 $k$ 向 $k-1$ 转移的反向均值,其修正可概括为
其中 $\Sigma_k$ 表示该步方差相关缩放,$\eta_k$ 为控制强度。该形式可由条件密度 $p(X\mid c,C)\propto p(X\mid c)\exp[-\rho\mathcal L_C(X)]$ 的局部 score 修正理解:其中 $\rho>0$,条件项额外贡献 $-\rho\nabla_X\mathcal L_C$。实际采样使用有限步长、近似去噪器和噪声级相关系数,因此对应引导近似,而非精确投影。
一个噪声级内部还可重复梯度更新;该优化迭代既不同于扩散索引 $k$,也不同于物理帧索引 $t$。梯度的求值状态、stop-gradient 位置与更新次数决定实际采用的近似。
具体计算从噪声动作 [B,263,1,T] 开始,去噪器预测 clean motion,再得到当前反向均值。空间指导先对均值反标准化,恢复根轨迹与 [B,T,22,3] 的全局关节位置,最后只比较指定时刻、指定关节的目标。实现将受控关节的欧氏距离求和作为指导损失,并固定初始根位置对应的梯度。梯度穿过恢复链回到均值,修正后的均值再与该步噪声合成下一状态。
控制输入由真实运动构造。训练时从恢复出的全局关节中抽取不同关节与时间密度,形成稀疏 hint;在 HumanML3D 配置中,每帧22个关节的坐标展开为66维,批量形状是 [B,T,66]。空间条件与运动特征使用各自的标准化统计,未受控位置用占位值表示。动画有效帧掩码与控制观测掩码仍承担不同作用:前者排除序列补齐,后者选出需要满足的位置。
位置指导在每个选定的扩散步中可以重复多次。较早的状态仍有大量噪声,较晚的状态接近可见姿态,控制强度与重复次数可以随扩散步调整。每次指导都包含坐标恢复和反向求导,控制更新因而同时影响与目标位置耦合的多组运动变量。
指导强度过低时,生成分布可能忽略稀疏条件;过高时,满足一个末端目标可能破坏其他部位。密集约束的总梯度也可能比稀疏约束更大,需统一归一化。对于不可达目标,增大指导系数只会强化相互冲突的更新,可能使运动偏离训练分布并破坏数值稳定性。
hint 中的“无观测”需要明确约定。零占位编码可能与真实坐标的零分量混淆,尤其在标准化之后;公开实现通过非零占位约定建立 hint 掩码,空间标准化与占位规则因而相互关联。采用独立观测标记,则可把真实零坐标与无目标明确区分。
空间指导的条件接口允许选择不同关节、时刻与观测密度。可行集合仍由骨架自由度、目标轨迹和条件之间的关系决定:超出臂展的目标、同一关节的冲突位置或突变轨迹,都会留下控制残差。
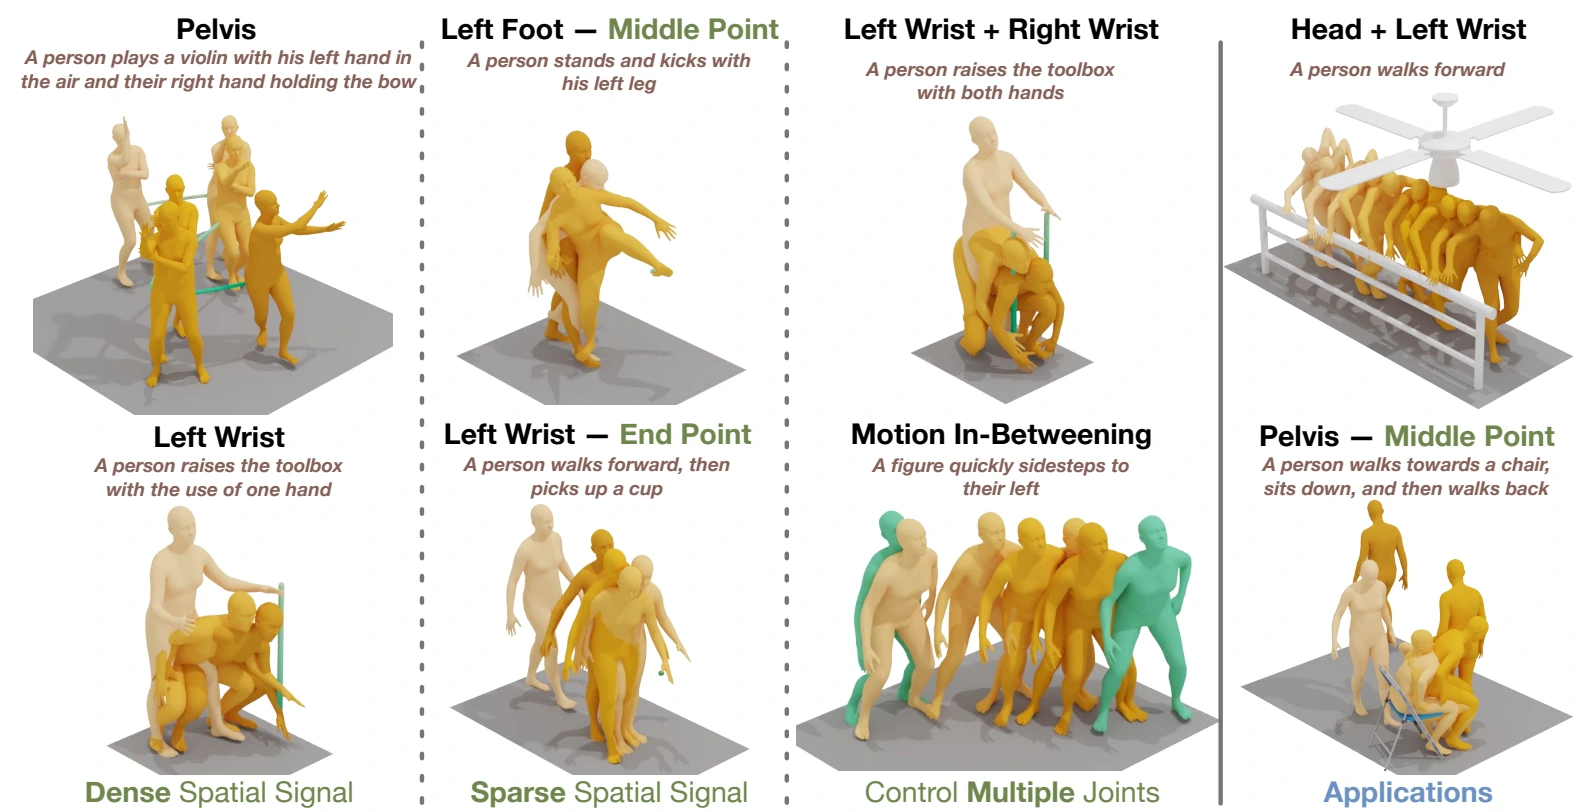
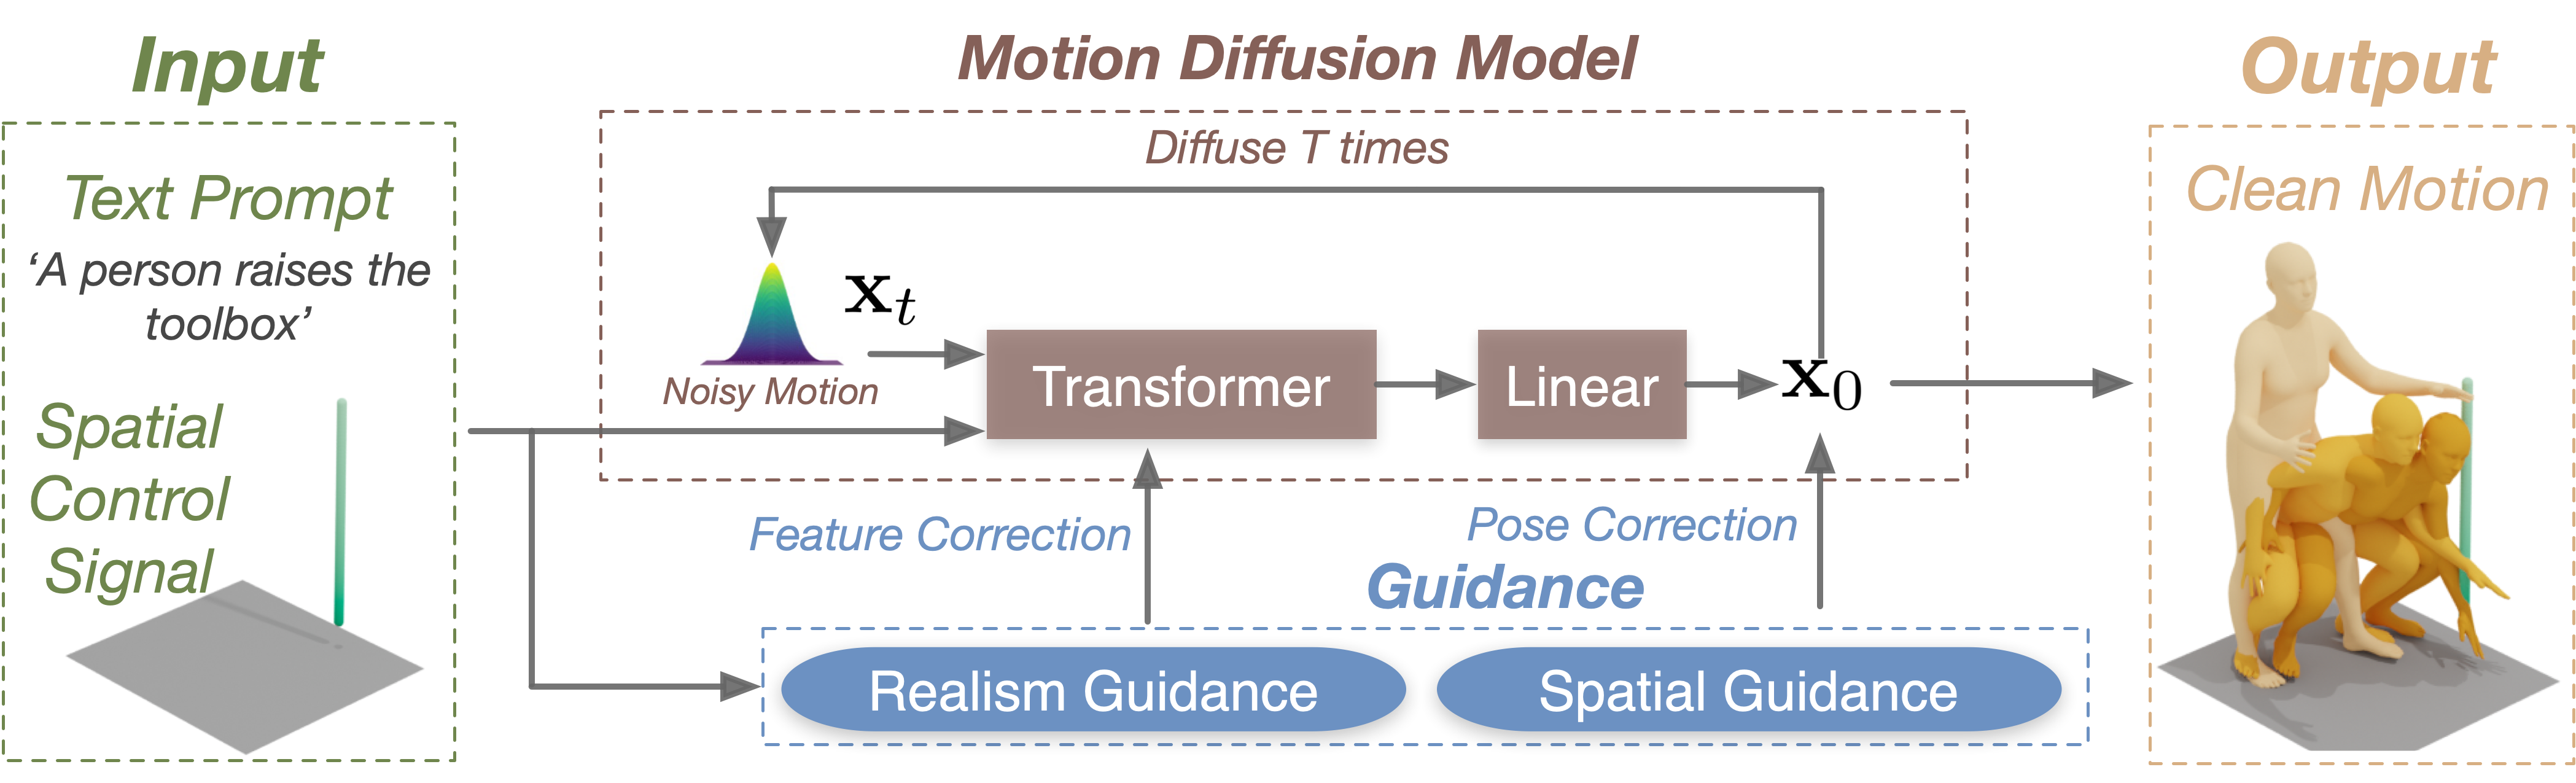
密集轨迹连续限定受控关节的运动,稀疏点仅限制特定时刻的位置。多关节条件进一步耦合全身姿态;场景示例中,扶手、头部高度和座椅位置被转换为空间控制信号,由人体生成器完成相应动作。
4. 学习型全身协调与控制残差
空间误差的梯度给出降低目标残差的方向,但单个末端约束不足以唯一确定全身姿态。例如手腕向目标移动时,肩、躯干和支撑脚也可能需要调整。OmniControl 的 Realism Guidance(运动协调引导)为此使用可学习控制分支,把空间提示编码成隐藏特征修正,并注入动作去噪骨干。解析指导直接减少位置误差,学习分支利用数据中的身体协同关系;二者承担不同作用。
ControlNet 式连接把骨干特征 $h_\ell$ 与控制分支特征 $g_\ell$ 通过投影相加,其中 $\ell$ 在本节表示网络深度,与物理帧索引 $t$ 和扩散噪声级 $k$ 独立:
控制分支按输入编码、时序建模与层间注入组织计算。在 OmniControl 中,稀疏 hint 首先经四层线性映射进入隐藏空间,末层零初始化,得到 [T,B,H]。随后,它与控制分支的噪声运动投影相加,再在前方加入“文本+扩散步”条件,形成 [T+1,B,H]。最后,控制 Transformer 保存每一层的中间输出,对每层分别使用零初始化投影,得到 [N,T+1,B,H] 的控制残差;$N$ 是 Transformer 层数。
动作骨干在对应层加入这些残差,去掉前置条件 token,再投影回 [B,263,1,T]。因此,即使只有右手某几个位置被指定,控制分支仍能通过时序注意力传播信息,建立肩、躯干及其他肢体之间的协同关系。稀疏观测由此可影响整段全身运动。
控制分支从预训练动作去噪器初始化,以真实动作和稀疏 hint 学习 clean motion 重建;控制分支将“稀疏目标需要怎样的全身配合”学习为一次网络前向计算,减少每次都从头搜索协调姿态的开销。公开训练实现同时更新动作骨干和控制分支,CLIP 文本编码器固定;新增分支与投影把空间条件接入原有运动先验。推理时,学习残差先提供协调姿态,解析空间指导再减小世界坐标误差。零投影使训练开始时的控制修正为零,随着投影更新,控制信息逐步进入原网络。
线性残差算例展示零初始化投影的梯度传播。若 $P(g)=Wg$且初始 $W=0$,第一步 $\partial\mathcal L/\partial g=W^\top\partial\mathcal L/\partial P=0$,控制分支上游暂时没有梯度;投影的梯度却可以非零。更新投影后,上游控制分支才能收到梯度。因此,零初始化实现了逐步激活的控制通路。
1 | import torch |
运行结果:
1 | initial_equals_base: True |
零投影算例表明,在残差通路的初始点,投影参数和上游控制参数具有不同的一阶参数敏感性:前者立即影响输出的一阶变化,后者的影响暂时被零矩阵消除。随着投影离开零点,上游特征才进入有效优化路径;若控制分支还有其他监督或旁路,这一结论须局限于所分析的残差通路。
学习分支与解析优化的代价不同。学习分支在一次前向计算中给出条件相关的特征修正,其准确性受训练条件覆盖影响;解析优化根据当前样本的约束 Jacobian(雅可比矩阵)计算更新,但需要额外求导,也可能收敛到非凸目标的局部解。控制条件的关节组合、观测密度和时长决定了输入分布;这些因素与训练分布之间的差异共同影响泛化误差。
5. 可解释姿态码与语言编辑
坐标轨迹适合精确控制,但操作者也可能只希望改变可描述的身体关系。pose code(姿态属性码)把连续姿态转成具有明确几何含义的离散属性。CoMo 使用肘部弯曲程度、手腕高度、两部位相对位置等属性,通过骨架解析形成代码。与学习到的 VQ 编号相比,这些代码对应可读的身体关系,语言模型因而可以根据“保持膝盖更弯曲”修改相关属性。
具体而言,姿态解析器直接计算关节夹角、距离、高低与相对方向,通过预设阈值判断属性;属性语义由几何规则定义。设共有 $N$ 个属性码,分为 $K_p$ 个类别,每个类别包含同一种关系的不同状态,例如肘部角度类别中的“完全弯曲”“部分弯曲”“伸直”。每个采样时刻只激活类别中的一个状态,得到 $K_p$-hot 向量 $z_i\in\{0,1\}^N$。
如果每隔 $u$ 帧解析一次,码序列形状为 [B,T/u,N]。码的语义由规则固定,code Embedding $e_n$ 则可以学习;同一时刻所有激活码的 Embedding 相加,形成解码特征:
一维卷积解码器对这些特征进行时间上采样,恢复连续运动。属性解析器由固定几何规则确定,训练更新的是属性 Embedding 与运动解码器,而非重新学习属性的定义。将逐帧差分记为 $\Delta X_t=X_{t+1}-X_t$,重建目标为
位置项保存姿态,差分项保存相邻帧变化,避免只匹配静态构型而忽略运动过程。完成这一阶段后,code Embedding 和运动解码器固定,用于后续生成和编辑。
生成器读取整体描述以及各身体部位的细粒度关键词。CLIP 分别编码整体文字、十个身体部位关键词与情绪关键词,构成条件前缀;$K_p$-hot 向量经线性投影,进入因果 Transformer。每个时间位置同时包含多个属性,输出头为 $N$ 个属性及一个结束状态分别预测 Bernoulli 概率,训练采用多标签二元交叉熵:
逐属性 BCE 提供可分的训练目标,但独立 Bernoulli 输出本身不保证类别内互斥,也不保证跨属性的几何相容性;这些条件还依赖属性选择规则与运动解码先验。训练读取真实码前缀,推理逐步预测下一组属性,结束状态触发后将整段码送入固定解码器。局部关键词补充整体描述中省略的身体属性;其监督效果取决于这些属性与运动序列的对应关系。
在这套属性表示上,编辑不必重新采样整段。原运动先解析为具有文字含义的姿态码,语言模型读取编辑指令、码的类别说明与时间序列,修改指定区间的属性。比如“蹲得更低”可以改变膝角、胯部高度与躯干关系,再由同一解码器恢复动作。
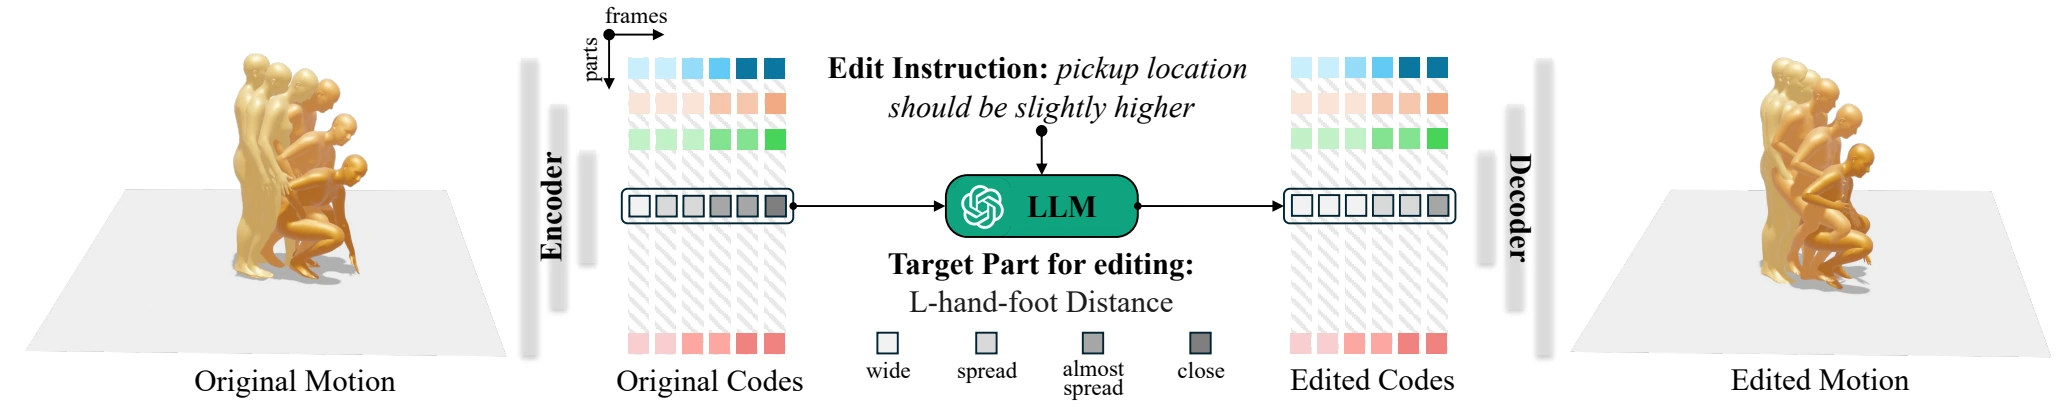
图中的编辑提高拾取位置,目标属性是左手与足部的距离。语言指令先确定相关时间范围与属性类别,再将距离类别替换为对应状态;运动解码器根据修改后的整段 pose code 恢复协调姿态。
几何属性的离散化会损失类别内部的连续变化。“膝盖微弯”覆盖一个角度区间,同一代码可能对应许多连续姿态。若两个动作只在区间内部相差几度,代码可能完全相同;若角度恰好越过阈值,代码则突然改变。动作解码器根据训练分布补充未编码自由度,但有限属性无法唯一确定原始姿态。若属性解析算子为 $\mathcal Q$,同一 pose code 所允许的姿态集合为
这一集合通常包含多种连续构型。编辑 code 只规定其中部分几何关系,运动解码器再根据训练所得的先验补充具体轨迹。
可以把第 $n$ 个属性解析写成 $q_n=\mathcal Q_n(P)$。编辑要求满足部分属性 $q_n'$,其余属性尽量保留;不同属性也可能互相矛盾。例如“手腕高于头部”“肘完全伸直”“肩膀不动”在某些身体朝向下无法同时满足。属性约束之间的几何关系决定连续姿态是否存在,即使每个编号本身都是合法取值。
速度或风格变化还涉及时间轴。把“缓慢弯腰”简单解释为复制帧,会改变时长却未必形成符合表演的速度轮廓;时间重采样还会改变接触持续区间与足部速度。pose code 提供语义操作接口,不替代完整的运动时间建模。
6. FineXtrol 的局部语言与时间结构
姿态属性表达某个身体构型,连续运动还需要说明属性何时改变。细粒度文本控制把局部描述与身体部位、时间区间绑定,使不同区域可以同时执行不同要求。例如,同一右臂先自然摆动,再抬高,随后保持位置。FineXtrol 将身体分为头部、躯干、左右臂和左右腿六部分,对各部分按时间排列描述,用 <SEP> 分隔区间。<Mask> 表示该区间未指定控制;<Motionless> 明确要求该部位没有显著运动。未指定与静止由此成为不同条件。
FineXtrol 把粗粒度文本与细粒度控制分开。MDM 骨干根据整体文本与含噪运动建模全局语义,可训练控制副本额外编码带时间结构的局部文本。独立控制分支保留原有语义通路,并为部位级与区间级条件提供专用特征。
设原动作投影与整体条件组成 $e\in\mathbb{R}^{(T+1)\times B\times H}$,控制文本经专用 T5 编码与平均池化得到 $e_c\in\mathbb{R}^{B\times d_c}$。线性映射将它送到 $H$ 维,并沿时间轴广播;记控制分支的运动与整体条件输入为 $e'$,则:
式中 $\ell$ 为 Transformer 层索引。时间顺序保存在控制字符串及其编码中,随后由控制分支将语义映射到各帧;该向量表达时序语义,不指定逐帧三维坐标。层间零投影的输出形状与骨干特征相同,末端仍预测 [B,263,1,T] 的 clean motion,用有效帧重建损失训练新增参数。训练随机把部分区间替换为 <Mask>,让模型学会同时处理密集控制与只指定局部区间的条件。
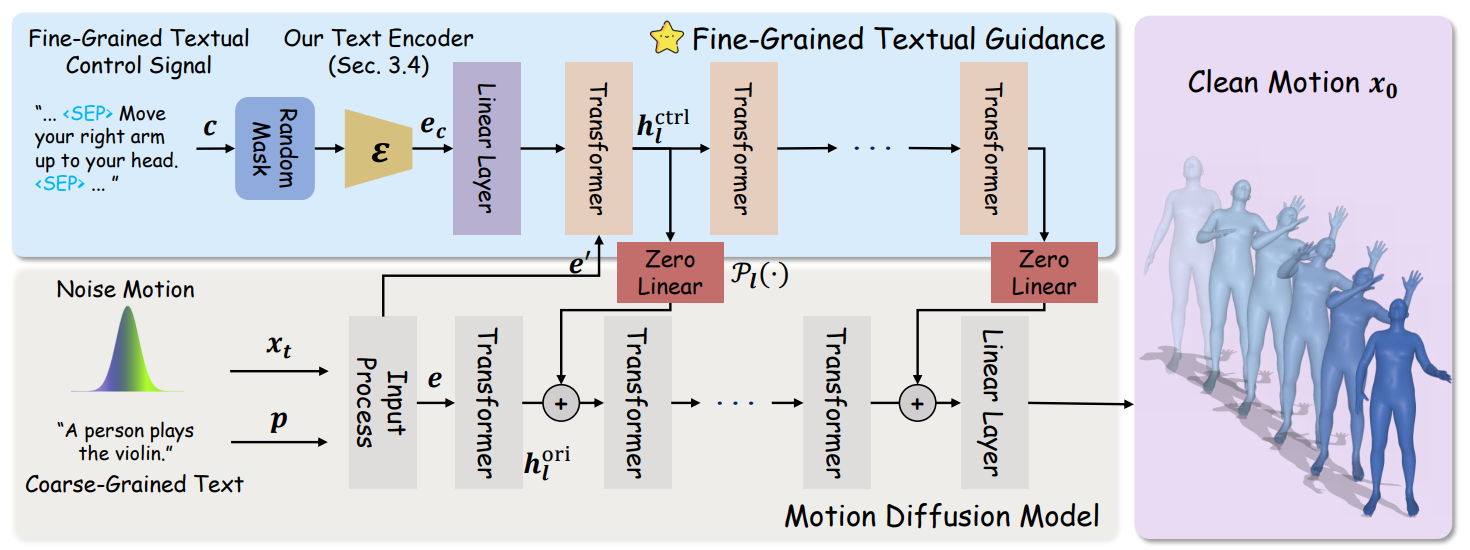
FineXtrol 的控制监督来自 FineMotion 的部位—区间标注,并与 HumanML3D 的整体文字和运动相对应。构造训练样本时,整体描述、局部描述和动作裁剪必须指向同一时间范围;局部描述按六个身体部位及连续时间区间序列化,动作端仍使用相同的标准化特征。专用文本编码器先接受分层对比训练,固定后为控制网络提供 Embedding;控制副本再从 MDM 权重初始化并学习动作重建。推理时,将区间描述序列化并编码控制文本,然后在每个反向扩散步重复注入控制残差。
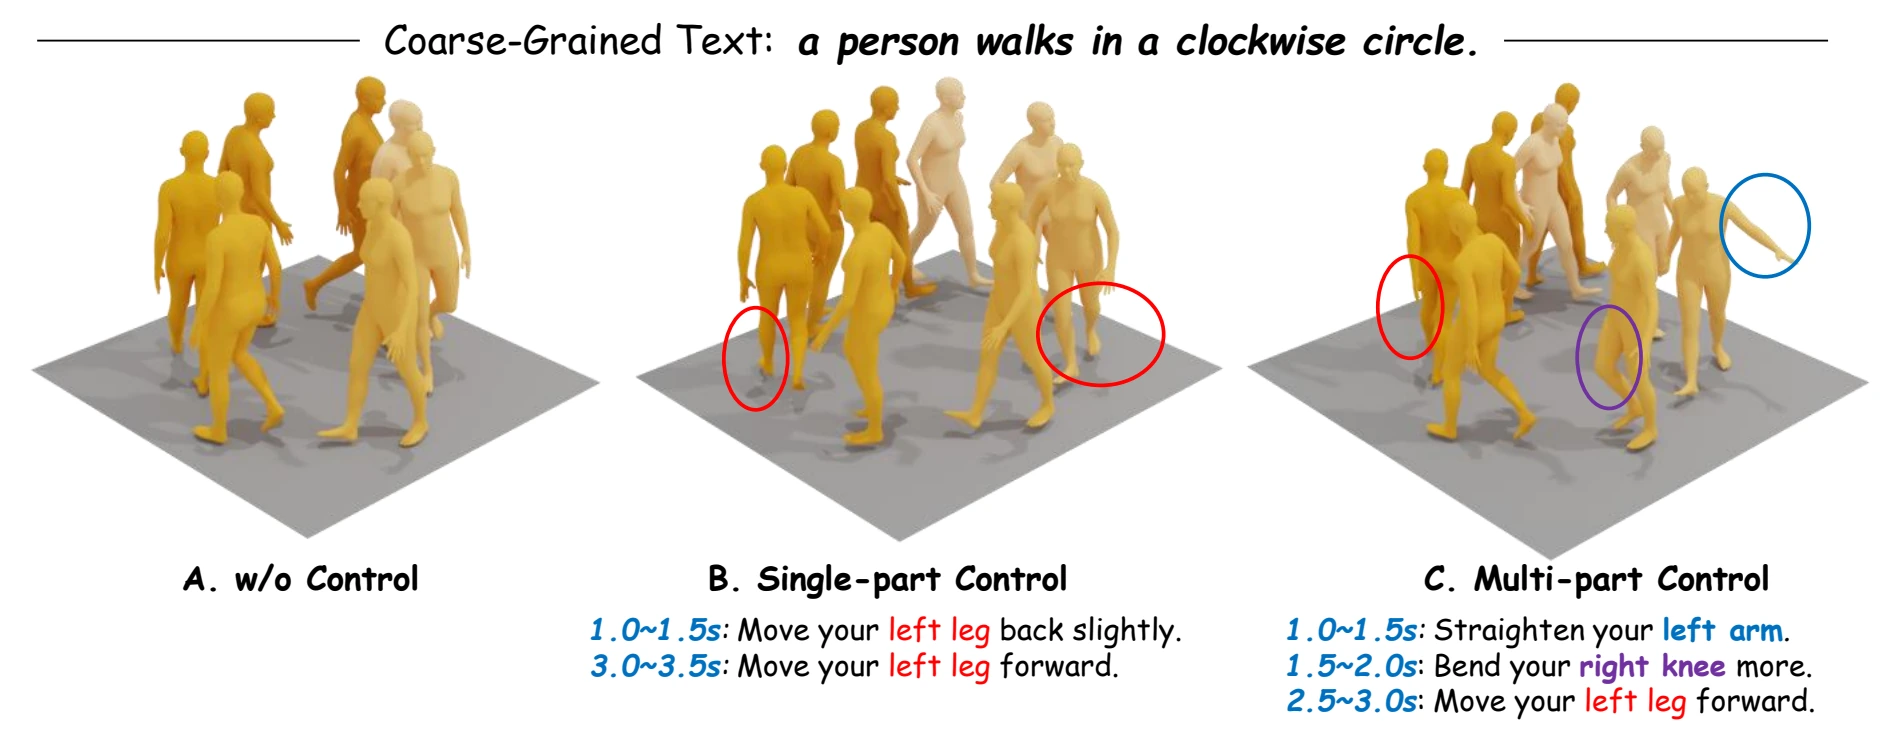
单部位条件限定左腿在两个区间中的方向变化,多部位条件分别约束左臂、右膝和左腿。整体行走语义保持为共同条件,区间与部位标注则限定局部差异,使全局描述和细粒度控制的作用可以分别观察。
局部标注必须对应真实运动。整体文本的语言扩写依赖语义先验,无法独立确定真实运动中的肢体方向和发生时刻。部位—区间标注则将属性直接绑定到观测运动,为精细控制提供时间对齐的监督。
在部位与时间掩码算例中,两项控制映射到20 fps 的合成角度序列,分别指定右臂与左膝的区间。直接覆盖区间内角度可以检查保持范围,也能显示边界连续性的问题。
1 | import numpy as np |
运行结果:
1 | controlled_frames_per_part: [10, 10] |
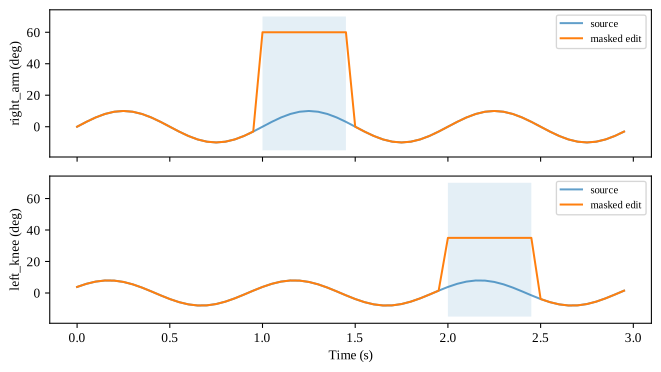
硬覆盖保留了掩码外数值,却没有约束边界导数。若相邻帧产生角度跳变 $\Delta q$,差分速度为 $\Delta q/\Delta t$,相应加速度尺度可达 $\Delta q/\Delta t^2$;提高播放帧率不会修复已存在的离散跳变,反而会提高其物理导数尺度。要在固定区间内保持位置、速度与加速度连续,需要同时匹配端点的位置、一阶导数与二阶导数,而非仅在角度值之间插值。过渡窗口、允许修改范围和关节速度界共同决定是否存在可行的编辑轨迹。
7. 三层语义结构与对比学习
部位与区间确定了控制信号的结构,文本编码器还需保持其中的关键语义差异。“抬高左手”和“抬高右手”只相差一个词,却要求不同身体部位;“先弯曲再伸直”与“先伸直再弯曲”词汇相近,时间语义相反。仅使用粗粒度动作语义的文本 Embedding,可能把这些差异压缩得过小。
FineXtrol 的文本编码训练区分句子、片段和序列三个层次。句子层学习身体部位和运动属性,同义改写构成正例;片段层处理同一时间区间中的多项描述,允许改变并发描述的书写顺序;序列层保留不同时间区间的先后关系,不能随意交换片段。
数据增强需遵循相应的不变性。例如,同一瞬间“右臂抬起,左膝弯曲”与“左膝弯曲,右臂抬起”可视为等价;两个相邻区间“先抬臂,后弯膝”与“先弯膝,后抬臂”不能视为同义。若数据增强破坏了这一区别,对比训练可能主动让错误时序的表示靠近。
对比学习提高等价描述的表示相似度,同时降低关键属性不同的描述之间的相似度。设一对增强文本的 Embedding 为 $z_i,z_j$,以余弦相似度构造 InfoNCE:
每批 $N$ 条文字各构造两个增强版本,得到 $2N$ 个 Embedding。T5 输出 [2N,L,d_c],平均池化形成 [2N,d_c],MLP 投影为对比向量;同一原文的两种增强互为正例,其他文本的增强为负例,分母包含正例。句子层训练完成后,其 T5 参数初始化片段层;片段层再初始化序列层,每层重新建立投影头。最终固定文本编码器,为动作控制分支提取序列 Embedding。温度 $\tau$ 控制相似度分布的尖锐程度;过低温度也可能放大错误负例的影响。
分层增强定义了不同层次的等价关系,对比学习据此保存左右部位和时间顺序的可分性,控制分支再学习这些距离对应的姿态变化。语义区分与动作执行分别位于编码和生成环节;同样清晰的文本区别,可能因为控制训练不足或运动解码误差而产生不同程度的动作变化。
细粒度标注还需要区分动作过程与保持状态。一个片段写“右手持续抬起”,可能表示正在上抬,也可能表示保持抬起姿态;二者分别对应速度条件与位置条件。标注需明确动作过程、保持状态与身体部位,时间区间则应区分动作启动和完成。若错误把这种差异作为同义增强,编码器会主动抹去控制所需信息。仅改变左右、方向或顺序中的一个属性,可构造语义接近的 hard negative,使监督集中于控制所依赖的细节。
8. 多粒度理解与编辑接口
精确区间可以由操作者提供,也可以先根据语言在原动作中定位。后一种编辑流程需要把理解与生成连接起来。MG-MotionLLM 在共享语言模型中统一两类任务,并扩展到细粒度描述、时间定位和局部编辑:运动 VQ-VAE 将连续动作转换为离散 token,T5 式模型读取任务指令、文本或动作 token,产生相应输出。运动编码器处理连续轨迹,T5 编码器处理已知条件,T5 解码器产生任务目标,最后由运动解码器恢复输出动作。三类编码与解码分别作用于不同的表示空间。
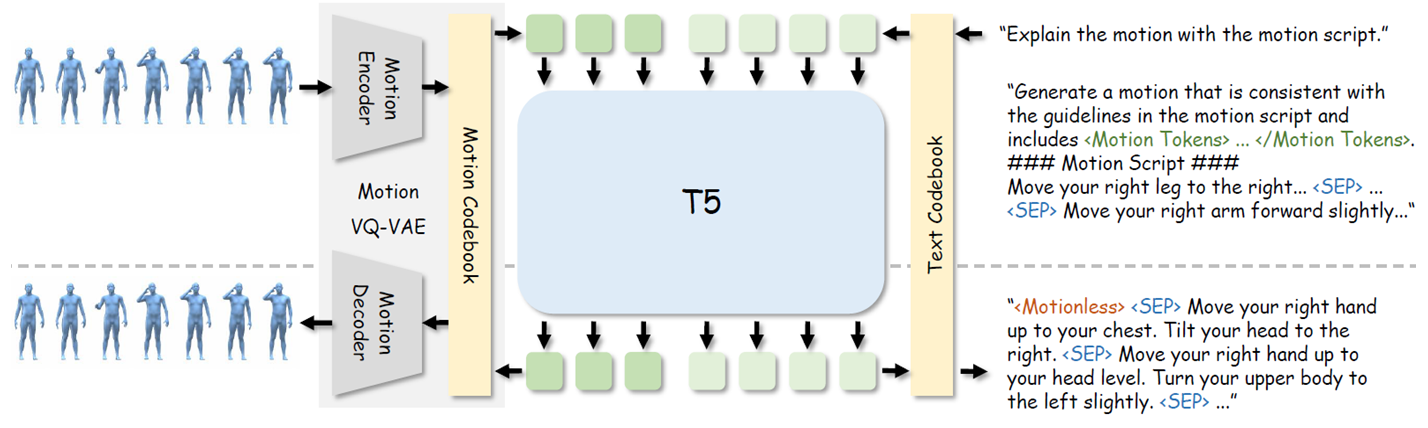
图中运动 tokenizer 与语言模型构成两个训练阶段。VQ-VAE 将 [B,T,263] 编码为 [B,T/u,d_z],最近邻 Codebook 映射给出 [B,T/u] 的整数编号。训练用重建、Codebook 与 commitment loss 建立可解码表示,随后固定运动编码器、Codebook 与解码器。右侧文字包括整体指令与按区间排列的 motion script;语言模型使用文字词表、运动词表和特殊标记的并集,其中运动开始与结束标记规定 token 范围,<SEP> 分隔描述区间。
在 T5 编码器—解码器中,输入任务序列 [B,L_{in}] 经 Embedding 成为 [B,L_{in},H],编码器对有效输入双向建模。解码器读取右移后的目标 [B,L_{out}],使用因果自注意力与对输入编码的交叉注意力,输出联合词表上的 [B,L_{out},V] logits。只有有效目标位置计算交叉熵,补齐不参与监督;理解任务的目标是文字,生成任务的目标包含运动编号,定位任务则输出区间信息。各任务共享参数与词表,任务指令和特殊标记则定义具体输入输出结构。扩展词表并不是把运动编号解释成自然语言单词:以连续编号的简化约定表示,若原词表及其特殊标记占据前 $V_c$ 个 ID,则运动编号 $q$ 可映射为独立 ID $V_c+q$,再通过联合 Embedding 矩阵取出 $H$ 维向量。联合 Embedding 只解决模型输入格式的兼容性;运动向量与文字含义之间的对应,需要通过动作描述、文字生成动作和片段定位等配对任务的监督逐步学习。
多粒度训练把完整动作摘要、局部描述和片段边界联系起来。模型要根据细粒度描述定位运动片段,也要根据局部运动生成详细文本;这些辅助任务提供了更细的动作—语言监督。第一阶段通过28种任务协同预训练,其中12种粗粒度、16种细粒度任务,让短动作、局部描述与时间范围先建立对应,再连接整段语义。第二阶段针对需要执行的任务进行指令微调。推理读取任务输入,在解码端逐 token 生成,直到结束标记,再将输出中的运动编号取回码向量并解码成连续动作。
对编辑而言,“先找到描述对应的片段,再执行修改”与“给定精确世界坐标并投影满足”是不同的控制方式。前者适合通过语言进行语义定位和修改,后者提供可直接测量的几何目标。语义定位不准确时,编辑可能作用于错误区间;运动码解码误差则可能影响未修改部分。
局部编辑误差可按处理环节分解:时间范围错误属于定位问题,局部文字误读属于理解问题,目标区间的姿态不符合描述属于生成问题,未修改区间变化过大则涉及保持与解码。理解与生成若共享同一语义偏差,循环调用也可能保留错误对应关系;因此编辑评价需直接比较目标区间的运动属性与非编辑区域的保持程度。
9. 多条件冲突、可达性与保持范围
多个控制接口组合后,需要先判断它们能否同时成立。例如,同一手腕在相同时间被要求处于两个不同位置,是显式冲突;身体保持原地却要求手腕追随超出臂展的轨迹,是几何冲突;“慢慢抬手”与0.1秒内完成大幅摆动,则涉及速度和时间冲突。新增条件通过集合交集限制可行解;相互矛盾的条件将产生空的可行集合。
面对这些相互竞争的要求,软约束优化可以用权重分配折中:
其中先验项限制动作偏离训练分布,速度项约束边界变化;权重决定各残差的相对代价,有限权重下的最优解通常仍允许非零误差。硬约束需要投影到约束集合或结构上保证观测值不被改动,即使如此,其余约束也可能没有可行解。若保持区域的一阶约束为 $A\delta q=0$,以 $N_A$ 表示其零空间基,允许更新写成 $\delta q=N_Av$,受控末端的有效雅可比便变为 $JN_A$。要求严格保持会删除部分原本可用的控制方向,这解释了保持误差下降与控制残差上升可能同时发生的原因。
在满足约束资格条件的局部最优点,带等式约束的优化满足 $\nabla_q L+A^\top\lambda=0$;乘子 $\lambda$ 描述最优值对保持约束右端扰动的一阶敏感性,其符号取决于约束写法。若有效雅可比秩不足或目标超出约束流形,调整 penalty 权重无法替代对控制目标或保持范围的重新定义。
保留范围可以分成原始特征、局部姿态和全局位置三种口径。固定局部腿部旋转而改变根位置,会移动整个下半身;固定全局足部位置时,根运动和腿部关节必须配合。同一次编辑因此可能具有较小的局部旋转误差和较大的世界位置误差,保持误差的含义由所选表示和坐标系共同决定。
10. 控制精度与编辑保持
控制精度衡量指定内容的满足程度,保持误差衡量其他区域偏离原动作的程度。前者只作用于受控关节和区间,后者作用于未编辑范围;手腕到达目标而躯干失衡,便是位置误差较小、全身协调较差的情形。两种量分别描述条件满足程度与编辑对全身运动的影响。
对于语言控制,左右互换应改变身体部位,时间区间平移应改变动作发生时刻,顺序交换应改变阶段排列。这些对应关系是语义控制的具体内容。行走模式保持而受控手臂错误,对应整体语义一致、局部属性执行失败的情形。
编辑边界的速度与加速度刻画过渡是否连续;未编辑区间的姿态、根轨迹或关节坐标差值刻画保持程度。它们沿用不同的坐标口径:根移动会改变全局位置,却可能保持局部旋转。密集空间轨迹则直接提供逐时刻位置,局部语言只规定属性与阶段,条件信息量也影响可达到的控制精度。
更复杂的接触任务会增加控制变量。例如,手腕位于杯子表面仅满足位置条件;稳定抓握还要求相对位姿、接触点速度及接触力相容。空间 penalty 的较小残差只说明几何目标近似成立,不能替代无穿透、摩擦锥和力矩平衡约束。人体运动控制因此逐步连接到人—物和人—场景交互,条件表示也从稀疏位置扩展到接触关系与执行过程。
参考资料
Yiming Xie, Varun Jampani, Lei Zhong, Deqing Sun, and Huaizu Jiang. OmniControl: Control Any Joint at Any Time for Human Motion Generation. In International Conference on Learning Representations, 2024.
Yiming Huang, Weilin Wan, Yue Yang, Chris Callison-Burch, Mark Yatskar, and Lingjie Liu. CoMo: Controllable Motion Generation through Language Guided Pose Code Editing. In Computer Vision – ECCV 2024, pages 180–196, Springer, 2024.
Keming Shen, Bizhu Wu, Junliang Chen, Xiaoqin Wang, and Linlin Shen. FineXtrol: Controllable Motion Generation via Fine-Grained Text. In Proceedings of the AAAI Conference on Artificial Intelligence, volume 40, number 11, pages 8905–8913, 2026.
Bizhu Wu, Jinheng Xie, Keming Shen, Zhe Kong, Jianfeng Ren, Ruibin Bai, Rong Qu, and Linlin Shen. MG-MotionLLM: A Unified Framework for Motion Comprehension and Generation across Multiple Granularities. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 27849–27858, 2025.
Mingyuan Zhang, Huirong Li, Zhongang Cai, Jiawei Ren, Lei Yang, and Ziwei Liu. FineMoGen: Fine-Grained Spatio-Temporal Motion Generation and Editing. In Advances in Neural Information Processing Systems, 2023.
Ginger Delmas, Philippe Weinzaepfel, Thomas Lucas, Francesc Moreno-Noguer, and Grégory Rogez. PoseScript: 3D Human Poses from Natural Language. In Computer Vision – ECCV 2022, Springer, 2022.
Resources
- OmniControl implementation:
diffusion/gaussian_diffusion.pyandmodel/cmdm.py. - CoMo implementation and PoseScript implementation.
- FineXtrol implementation and FineMoGen implementation.
- MG-MotionLLM implementation, project repository, and numerical examples.
Figure credits
- OmniControl architecture: author project, composited on white. Control results: Figure 1 of the paper, cropped to the original illustration.
- CoMo editing pipeline: Figure 3 of the paper, cropped to the original illustration.
- FineXtrol architecture and control results: Figures 2 and 4 of the paper; author project. Original labels and panels are retained.
- MG-MotionLLM interface: motion encoding, T5, and motion decoding panel from the author poster; paper and author information.